

Python爬虫真的无所不能吗?技术边界与常见误区
假设一位刚入行的数据分析师接到了一个需求:“把某主流电商平台全部商家的实时成交量、SKU库存及买家评价完整抓取下来”。在不少初学者甚至非技术管理者的印象中,网络爬虫似乎拥有穿透一切数据的魔力——只要安装了 Python,导入 Requests 或 Selenium,敲几十行代码就能抓取互联网上的任何信息。然而,当真正把脚本推向真实网络环境时,迎面而来的往往不是结构整齐的数据表,而是密密麻麻的 403 拒绝访问、验证码弹窗、动态混淆脚本,甚至是来自法务部门与运维部门的严肃问询。
直接给出结论:Python 爬虫绝非无所不能。爬虫在本质上只是一个遵循标准协议、模拟客户端发起请求并提取响应文本的自动化程序。它的能力上限从来不是由“代码写得多巧妙”决定的,而是从物理网络、环境指纹、行为风控到法律伦理,受到四重坚固的技术与规则边界制约。
一、爬虫能力的技术对抗全景
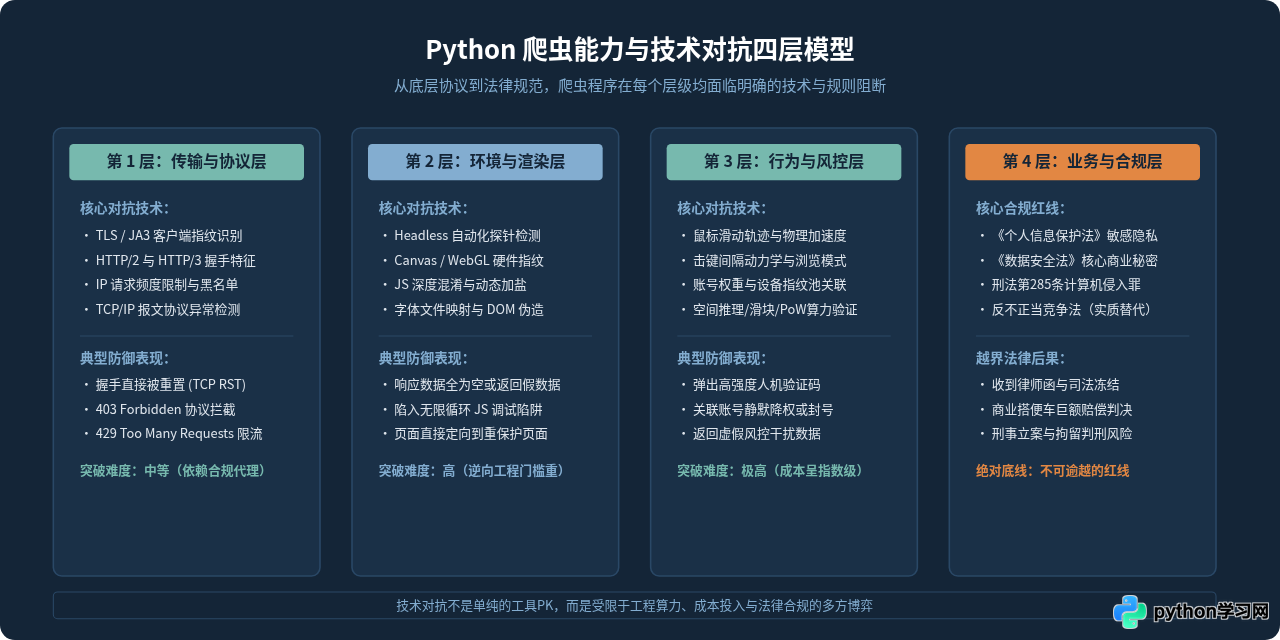
要理解爬虫为何频频受阻,首先需要厘清目标服务器构建的纵深防御体系。现代互联网服务的安全防护已经从单纯的“校验请求头(User-Agent)”,演变为横跨网络传输、浏览器环境、交互行为和业务风控的多维防御矩阵。
二、常见认知误区剖析
误区一:工具万能论——“只要用 Selenium/Playwright 模拟浏览器,就没有爬不下的网页”
初学者在遇到基础反爬(如动态 JavaScript 渲染)时,最常见的应对思路是:“既然 Requests 拿不到渲染后的 HTML,那我直接用 Selenium 或 Playwright 开一个真正的浏览器,所见即所得,目标网站肯定没法识别”。
这种思路在五年前或许能够解决大部分初级站点,但在当前的网络环境下已经完全失效。现代浏览器指纹检测技术已经极其成熟:
- 自动化环境特征识别:不仅仅是简单的
navigator.webdriver属性,无头浏览器在 Chromium 内核底层会暴露数百项默认特征(如缺失特定的音频编解码器、插件列表为空、WebGL 渲染器为 Mesa/SwiftShader 等)。 - 底层协议指纹:即使使用了完整的无头浏览器,其底层的 TLS Client Hello 握手报文(Cipher Suites 排序、Extensions 特征)与普通桌面端用户真实环境仍有统计学差异。
- 资源消耗瓶颈:一个轻量级的 Python Requests 请求只需要几毫秒和几兆内存,而启动一个无头浏览器实例需要消耗几百兆内存和高额 CPU。当采集任务需要扩展到数十万页面时,机器资源成本会呈几何级膨胀,根本不具备工程可行性。
误区二:接口至上论——“只要在控制台逆向出加密参数,就能一劳永逸采集”
进阶开发者常常热衷于“扣 JS 逆向”:在 Chrome DevTools 的 Network 面板找到真实的数据 API,通过打断点、分析混淆代码,找出 sign、token 或动态时间戳的加密逻辑,然后用 Python 的 execjs 或纯 Python 重写加密算法直接请求接口。
这种做法同样存在致命边界——攻防不对称与维护成本黑洞:
- 算法快速迭代:商业平台通常会建立每周甚至每日更新的混淆机制。逆向工程师花费整整三天理清的算法,在平台下一次前端打包发布后就会立即失效,所有解析代码全部推倒重来。
- Wasm 与代码虚拟化(VMP):越来越多的核心业务将加密签名逻辑编译入 WebAssembly 二进制文件,或者采用自定义字节码虚拟化技术。逆向难度已经从“阅读 JavaScript”跨越到了“二进制逆向工程”,学习门槛与时间投入极为高昂。
三、数据采集的技术选型与决策路径
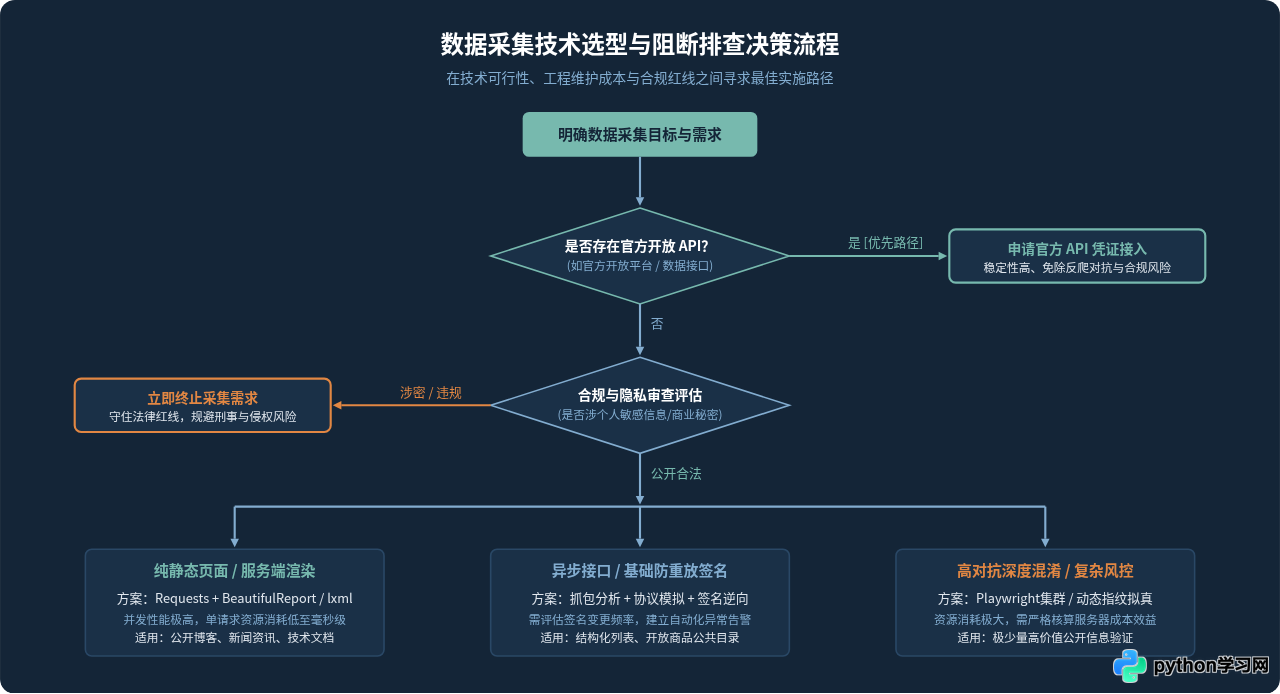
在面对具体的数据需求时,开发者不应该盲目上手写爬虫,而应该建立科学的工程化决策机制。首先评估数据来源的合法性与官方接口,再根据数据表现形式和防御强度选择最优的技术路径。
四、规模化采集中的工程鸿沟
很多开发者在本地终端运行单机脚本时一切正常,就误以为“爬虫已经做完了”。实际上,写一个能抓 100 页的练习脚本,与构建一个每天稳定采集上千万页面的数据系统,两者中间隔着巨大的工程鸿沟。
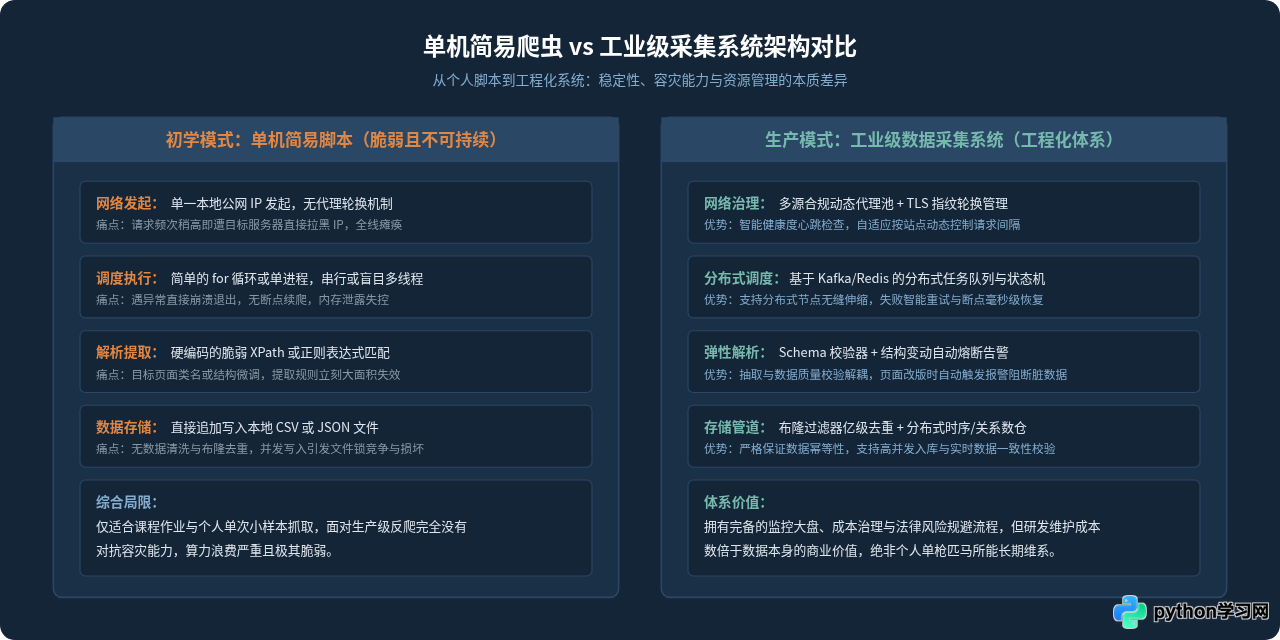
假设抓取一个具有严格风控的电商站点 1000 万个页面:优质住宅代理单 GB 成本在数十元不等,若采用无头浏览器渲染,每小时服务器集群算力开销数百元,再加上验证码打码服务费,单次全量采集的真实直接成本动辄上万元。如果采集到的数据本身无法产生对应的商业利润,这种采集从商业逻辑上就已经宣告失败。
五、不可逾越的法律与合规边界
技术能力的边界尚可通过升级架构、采购资源来逼近,但法律与合规的边界则是绝对的高压线,一旦触碰将付出惨重代价。在很多侵权与刑事判决中,“我们只是用爬虫收集网上公开的数据”是最常见却又最站不住脚的辩解。
1. 个人信息与隐私红线
《中华人民共和国个人信息保护法》明确规定,任何组织和个人不得非法收集、使用、加工、传输他人个人信息。爬取涉及用户真实姓名、手机号、家庭住址、身份证号、医疗记录等敏感信息的,不仅属于民事侵权,情节严重的将直接构成“侵犯公民个人信息罪”。
2. 越权访问与“突破技术防护”
如果目标网站已经设置了登录态校验、防爬风控机制,开发者通过逆向反编译、伪造设备特征、利用漏洞或绕过验证码强行获取非公开数据,在司法认定中极易被定性为“非法获取计算机信息系统数据罪”或“破坏计算机信息系统罪”。
3. 实质替代与不正当竞争
即使采集的数据属于企业公开内容(例如点评网站的商户评论、分类信息网的租房帖子),如果爬虫抓取后直接在自己的平台上原样照搬,用于商业变现,导致用户不再访问原平台,司法实践中通常依据《反不正当竞争法》认定为“搭便车”和构成实质性替代,判决巨额经济赔偿。
六、理性看待 Python 爬虫的技术定位
认清 Python 爬虫的技术边界与常见误区,并不是要否定爬虫本身的实用价值,而是为了让开发者建立健康的工程观与敬畏心:
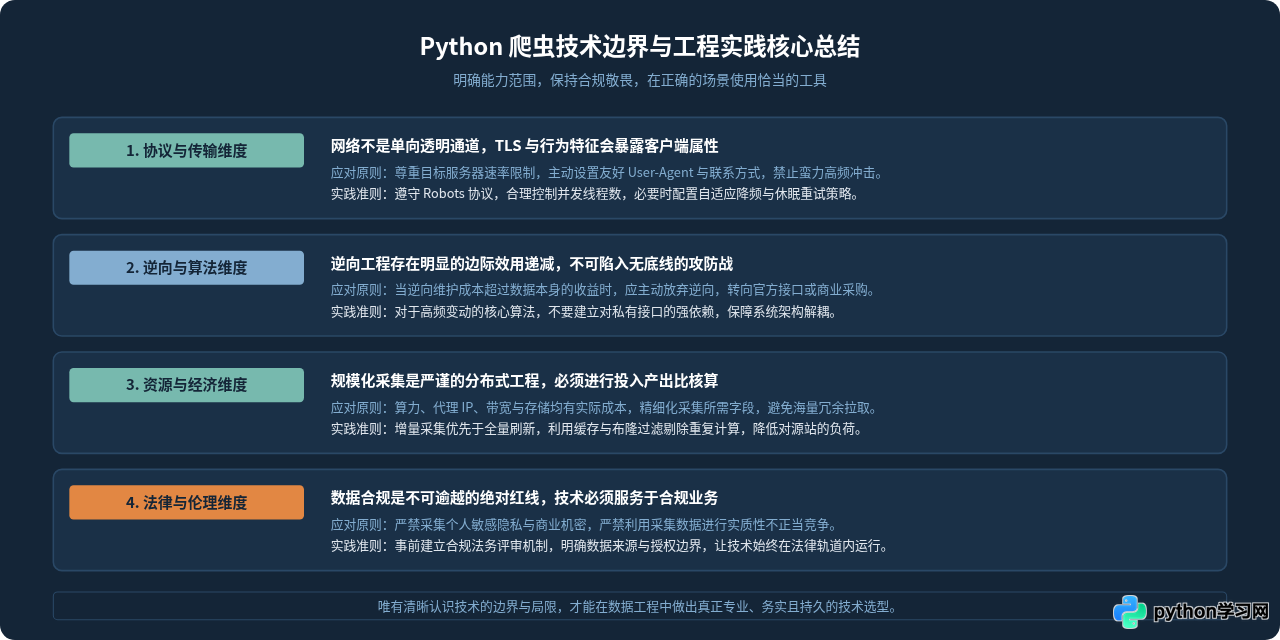
归根结底,Python 爬虫是数据采集与自动化测试领域一把锋利的“瑞士军刀”。在合适的小型场景、公开文档整理、学术研究以及企业内部自动化中,它能大幅提高生产力;但一旦将其神化为“无所不能的数据提款机”,开发者往往会迷失在逆向工程的技术泥潭中,甚至跌入法律风控的深渊。认清边界,敬畏规则,才是每一位合格工程师的立身之本。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









