

Python爬虫数据持久化:将采集结果存入MySQL、MongoDB或CSV

一、数据持久化核心路径与选型决策
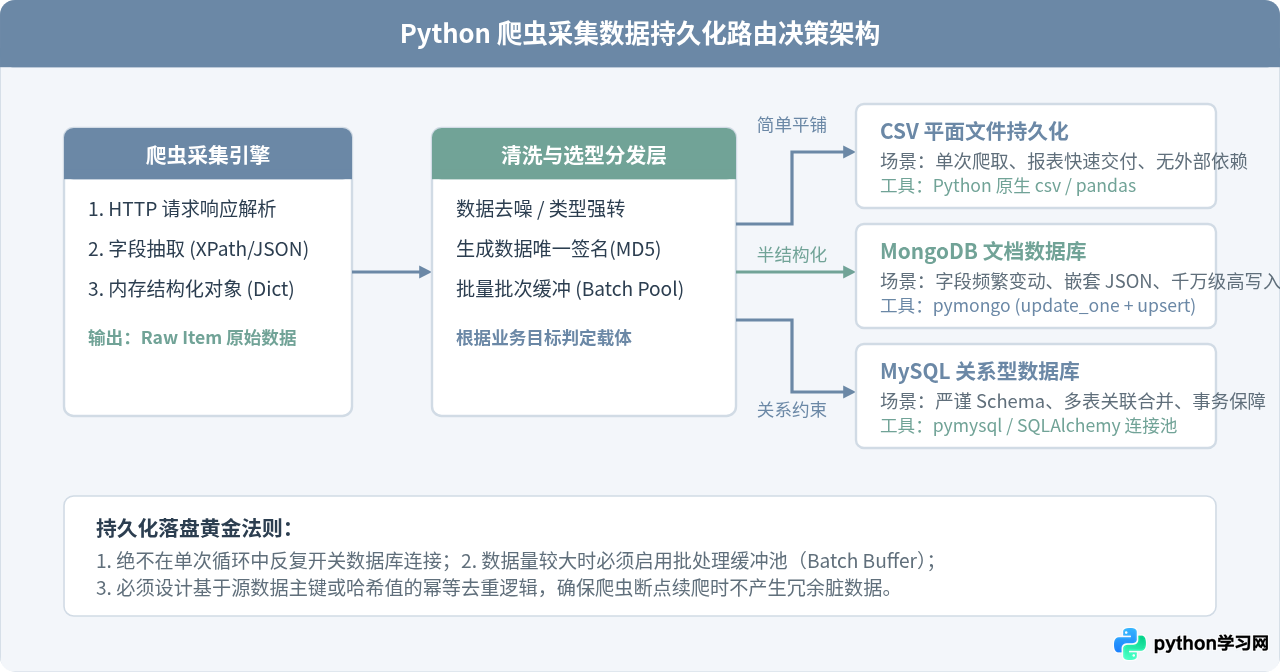
持久化方案没有绝对的优劣,只有与业务需求、数据形态相匹配的合理选择。在面对一个采集项目时,我们通常从三个基本维度评估存储载体:数据结构的规整程度、单次与累计的数据量级,以及后续对这批数据的查询与处理方式。
对于单次抓取且字段绝对平铺的小型数据集,写入轻量的 CSV 文件无需搭建任何服务;对于爬取多站点、字段不一致或包含多层嵌套对象(如用户动态、商品规格参数等半结构化数据),Schema-free(无固定模式)的 MongoDB 是理想归宿;而对于需要多表关联合并、遵循严格字段类型定义、具备强事务支持的业务场景,MySQL 依旧是不可动摇的行业标准。
二、三种存储方案特性深度对比
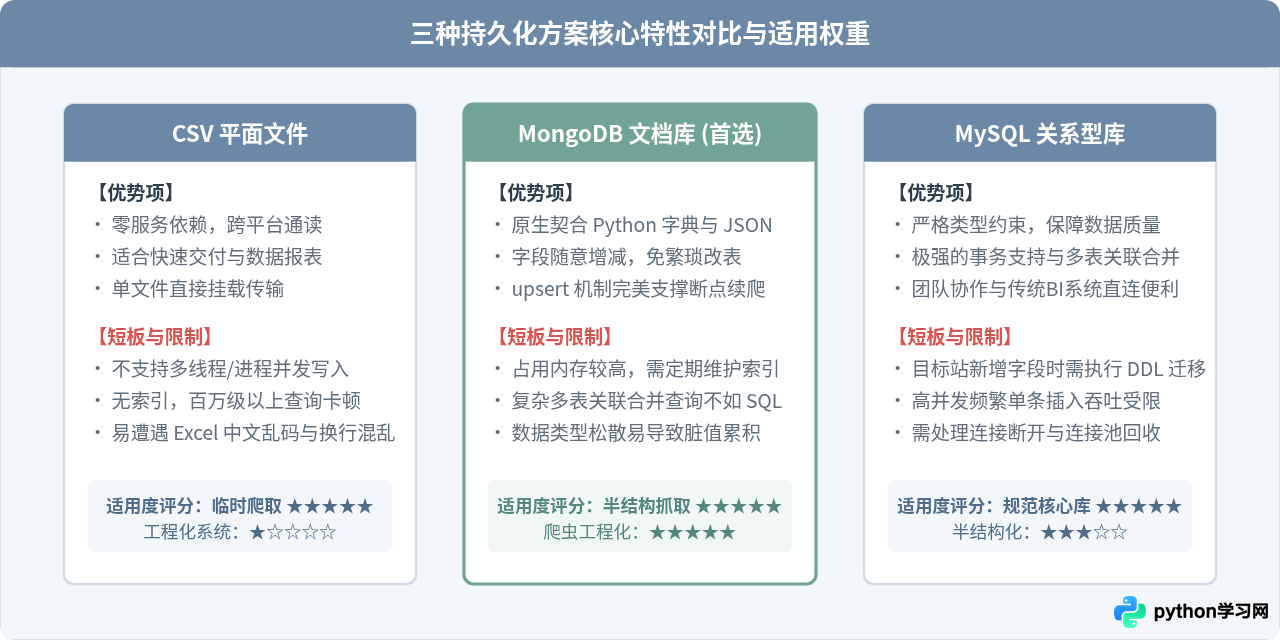
为了在开发初期做出正确决策,我们需要横向对比三者在数据模型、并发写入吞吐、查询便利性以及维护成本上的差异。下表列出了关键技术参数对比:
| 对比维度 | CSV 文件存储 | MongoDB 文档库 | MySQL 关系型库 |
|---|---|---|---|
| 数据模式 (Schema) | 二维平铺,不可直接存储数组/嵌套字典 | Schema-free,原生支持 BSON/JSON 复杂结构 | 严格预定义表结构,修改字段成本较高 |
| 写入性能与并发 | 单机极高(仅受磁盘I/O限制),无法多进程并发安全写入 | 极高(内存映射机制),天然支持高并发写与分片集群 | 较高,依赖批量插入与合理的事务提交频次 |
| 去重与幂等支持 | 无内置机制,需内存维护集合或后置去重脚本 | 基于 _id 或唯一索引,支持 upsert 原子更新 |
基于主键/唯一索引,支持 ON DUPLICATE KEY UPDATE |
| 查询与检索支持 | 全量扫描,需借助 Excel 或 pandas 处理 | 强大,支持针对嵌套属性的高效索引与聚合管道 | 极其强大,完整的 SQL 生态、多表 JOIN 与索引优化 |
| 运维与环境成本 | 零运维成本,无服务依赖 | 需部署服务,内存消耗相对较大 | 需部署服务,需设计表结构与索引 |
三、方案一:轻量直接的 CSV 文件持久化
CSV(Comma-Separated Values)是一种用逗号分隔纯文本数据的通用格式。Python 内置了 csv 模块,推荐使用 csv.DictWriter 直接将爬虫产生的字典对象批量追加写入。
1. 关键避坑点
- Windows Excel 乱码: 在打开文件时必须指定编码为
utf-8-sig,带有 BOM 头的 UTF-8 能确保各类电子表格软件正确识别中文。 - 空行与换行错位: Python 3 在打开 CSV 文本模式时,若不加
newline="",内置写入器会自动添加额外的\r\r\n导致每行数据间出现刺眼的空白行。 - 表头按需写入: 文件首次创建时写入 Header,后续追加写入(
mode="a")时需通过判断文件是否为空跳过表头写入。
2. 生产级 CSV 写入完整代码
import os
import csv
from typing import List, Dict

class CsvPipeline:
    def __init__(self, filepath: str, fieldnames: List[str]):
        self.filepath = filepath
        self.fieldnames = fieldnames
        self._ensure_header()

    def _ensure_header(self):
        """如果文件不存在或为空,先写入标题行"""
        file_exists = os.path.exists(self.filepath)
        is_empty = (os.path.getsize(self.filepath) == 0) if file_exists else True

        if not file_exists or is_empty:
            # 使用 utf-8-sig 兼容 Windows Excel 打开中文不乱码
            with open(self.filepath, mode="w", encoding="utf-8-sig", newline="") as f:
                writer = csv.DictWriter(f, fieldnames=self.fieldnames)
                writer.writeheader()

    def save_items(self, items: List[Dict]):
        """批量追加写入数据列表"""
        if not items:
            return
        with open(self.filepath, mode="a", encoding="utf-8-sig", newline="") as f:
            # extrasaction="ignore" 自动忽略字典中多余的非目标键,防止抛出异常
            writer = csv.DictWriter(f, fieldnames=self.fieldnames, extrasaction="ignore")
            writer.writerows(items)

# 示例调用
if __name__ == "__main__":
    fields = ["article_id", "title", "url", "publish_time", "read_count"]
    pipeline = CsvPipeline("crawler_articles.csv", fieldnames=fields)

    mock_scraped_data = [
        {
            "article_id": "1001",
            "title": "Python 并发爬虫优化技巧",
            "url": "https://example.com/p/1001",
            "publish_time": "2026-10-18",
            "read_count": 3420,
            "extra_debug_info": "ignore this"
        },
        {
            "article_id": "1002",
            "title": "Requests 与 Httpx 核心性能评测",
            "url": "https://example.com/p/1002",
            "publish_time": "2026-10-19",
            "read_count": 5110
        }
    ]
    pipeline.save_items(mock_scraped_data)
    print("CSV 数据写入成功,包含防乱码与换行控制")
四、方案二:面向半结构化数据的 MongoDB 持久化
MongoDB 是爬虫领域使用最普遍的文档数据库。它采用 BSON(Binary JSON)格式,与 Python 的 dict 和 list 数据结构完美契合。爬虫面对的前端接口字段经常变化,MongoDB 的无模式特性免去了每次因为目标网站新增属性而修改数据表结构的繁琐工作。
1. 核心实践:利用 Upsert 实现断点幂等写入
网络爬虫可能因为网络抖动在第 5000 条数据时中断,重新启动时若全量抓取,朴素的 insert_one 会抛出主键重复错误或产生两份相同的数据。通过将目标网站的唯一标识(如文章 ID、商品 SKU 或目标详情页 URL)设为检索条件,结合 update_one(filter, {"$set": item}, upsert=True),即可实现:存在则更新最新内容,不存在则新建插入。
2. 生产级 MongoDB 管道代码
from pymongo import MongoClient, UpdateOne
from typing import List, Dict

class MongoPipeline:
    def __init__(self, host="localhost", port=27017, db_name="spider_data", collection_name="articles"):
        # 建立连接客户端(自带连接池,单例复用)
        self.client = MongoClient(host=host, port=port, maxPoolSize=50)
        self.db = self.client[db_name]
        self.collection = self.db[collection_name]
        # 对关键去重标识创建唯一索引,保障即使并发写入也不会产生冲突
        self.collection.create_index("article_id", unique=True)

    def save_single_upsert(self, item: Dict):
        """单条写入/更新"""
        unique_key = item.get("article_id")
        if not unique_key:
            return
        # $set 仅更新指定字段,保留文档中已有的其他历史字段
        self.collection.update_one(
            {"article_id": unique_key},
            {"$set": item},
            upsert=True
        )

    def save_bulk_upsert(self, items: List[Dict]):
        """批量聚合写入(极度推荐:成百上千倍提升落盘性能)"""
        if not items:
            return
        operations = []
        for item in items:
            unique_key = item.get("article_id")
            if not unique_key:
                continue
            operations.append(
                UpdateOne(
                    {"article_id": unique_key},
                    {"$set": item},
                    upsert=True
                )
            )
        if operations:
            # bulk_write 一次网络传输提交整批操作,ordered=False 允许内部并行执行
            result = self.collection.bulk_write(operations, ordered=False)
            print(f"写入完成: 新增 {result.upserted_count} 条, 更新 {result.modified_count} 条")

# 示例调用
if __name__ == "__main__":
    mongo_pipe = MongoPipeline()
    items = [
        {"article_id": "art_201", "title": "异步爬虫实战", "tags": ["Python", "Asyncio"], "views": 1200},
        {"article_id": "art_202", "title": "Playwright 模拟指纹", "tags": ["Web", "Security"], "views": 850}
    ]
    mongo_pipe.save_bulk_upsert(items)
五、方案三:面向规范化强关系的 MySQL 持久化
当采集结果需要直接对接到下游数据仓库、业务报表或需要多表强外键约束时,MySQL 是必选方案。在写入 MySQL 时,必须严防三大隐患:SQL 注入、字符集不支持 Emoji(4 字节 UTF-8)、以及单条 INSERT 频繁提交导致的 I/O 阻塞。
1. 关键规范设计
- 字符集声明: 建表与连接必须指定
utf8mb4,否则一旦爬取到包含 Emoji 表情或生僻字的文本,MySQL 会直接报错Incorrect string value导致写入中断。 - 参数化查询: 绝不能使用 Python 的 f-string 或
%字符串拼接 SQL,必须依靠游标执行时的占位符(%s)进行原生转义,消除 SQL 注入风险。 - 原子幂等写入: 使用 MySQL 的
INSERT ... ON DUPLICATE KEY UPDATE语法,配合表上的主键或唯一索引,在主键冲突时自动更新,避免中断。
2. 生产级 MySQL 写入代码
import pymysql
from pymysql.cursors import DictCursor
from typing import List, Dict

class MysqlPipeline:
    def __init__(self, host="127.0.0.1", port=3306, user="root", password="your_password", database="spider_db"):
        self.config = {
            "host": host,
            "port": port,
            "user": user,
            "password": password,
            "database": database,
            "charset": "utf8mb4",          # 关键:必须支持 4 字节 Emoji
            "autocommit": False,           # 手动控制事务,批量提交提升性能
            "cursorclass": DictCursor
        }
        self.conn = pymysql.connect(**self.config)
        self._ensure_table()

    def _ensure_table(self):
        """初始化数据表,建立唯一索引约束"""
        ddl = """
        CREATE TABLE IF NOT EXISTS tbl_crawled_data (
            id BIGINT AUTO_INCREMENT PRIMARY KEY,
            source_id VARCHAR(64) NOT NULL COMMENT '源站唯一ID',
            title VARCHAR(255) NOT NULL,
            url VARCHAR(512) NOT NULL,
            views INT DEFAULT 0,
            crawled_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP ON UPDATE CURRENT_TIMESTAMP,
            UNIQUE KEY uk_source (source_id)
        ) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_unicode_ci;
        """
        with self.conn.cursor() as cursor:
            cursor.execute(ddl)
        self.conn.commit()

    def save_batch(self, items: List[Dict]):
        """批量幂等插入/更新"""
        if not items:
            return

        sql = """
        INSERT INTO tbl_crawled_data (source_id, title, url, views)
        VALUES (%s, %s, %s, %s)
        ON DUPLICATE KEY UPDATE
            title = VALUES(title),
            url = VALUES(url),
            views = VALUES(views);
        """

        # 将字典转换为参数元组列表
        data_tuples = [
            (
                item.get("source_id"),
                item.get("title", "")[:255],
                item.get("url", "")[:512],
                int(item.get("views", 0))
            )
            for item in items if item.get("source_id")
        ]

        try:
            with self.conn.cursor() as cursor:
                # executemany 配合单条 SQL 模板,将数百条数据合并一次请求传输
                cursor.executemany(sql, data_tuples)
            self.conn.commit()
            print(f"MySQL 批量落盘完成,处理记录: {len(data_tuples)} 条")
        except Exception as e:
            self.conn.rollback()
            print(f"写入异常,已自动回滚: {e}")
            raise e

    def close(self):
        if self.conn and self.conn.open:
            self.conn.close()
六、生产级爬虫持久化管道(Pipeline)实施步骤
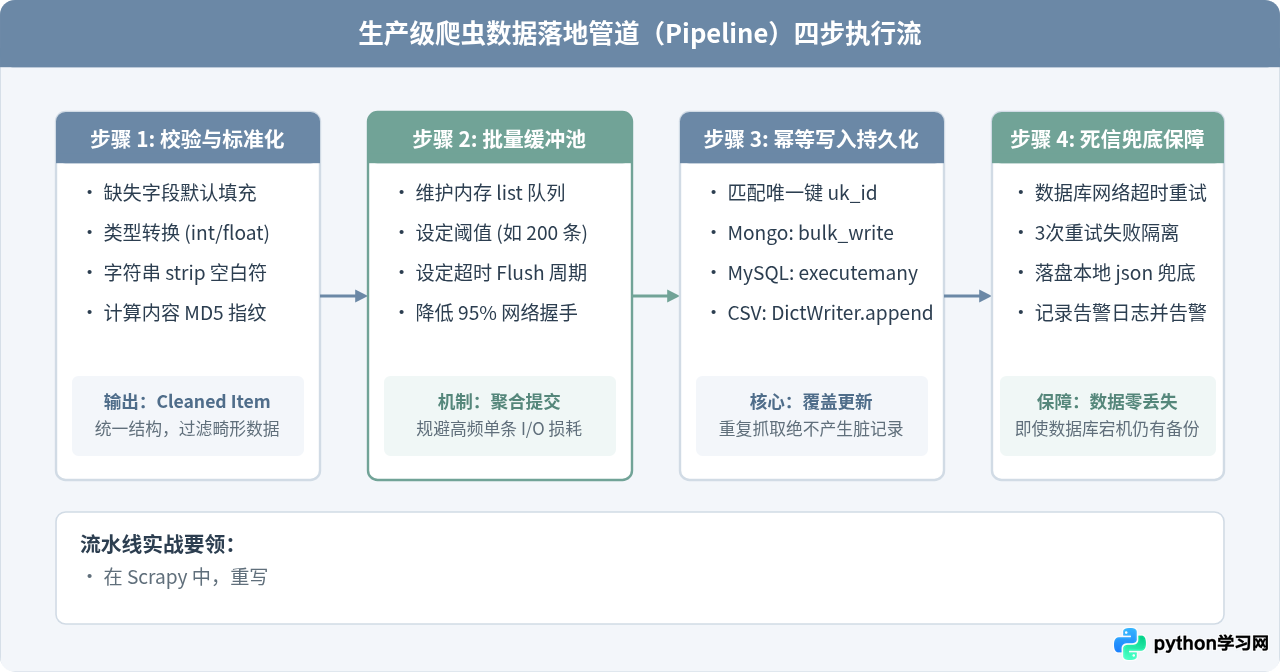
无论最终持久化目标是文件还是数据库,都不应当在爬虫解析函数的深层直接调用写入语句。成熟的爬虫架构采用解耦的流水线设计(Pipeline)。完整的持久化管道包括四个关键动作:
七、生产级最佳实践与避坑清单
save()。一个成熟的爬虫系统在落盘时必须能够承受“网络突发中断”、“数据库短暂限流”、“目标站点格式脏值”等各类外部扰动。
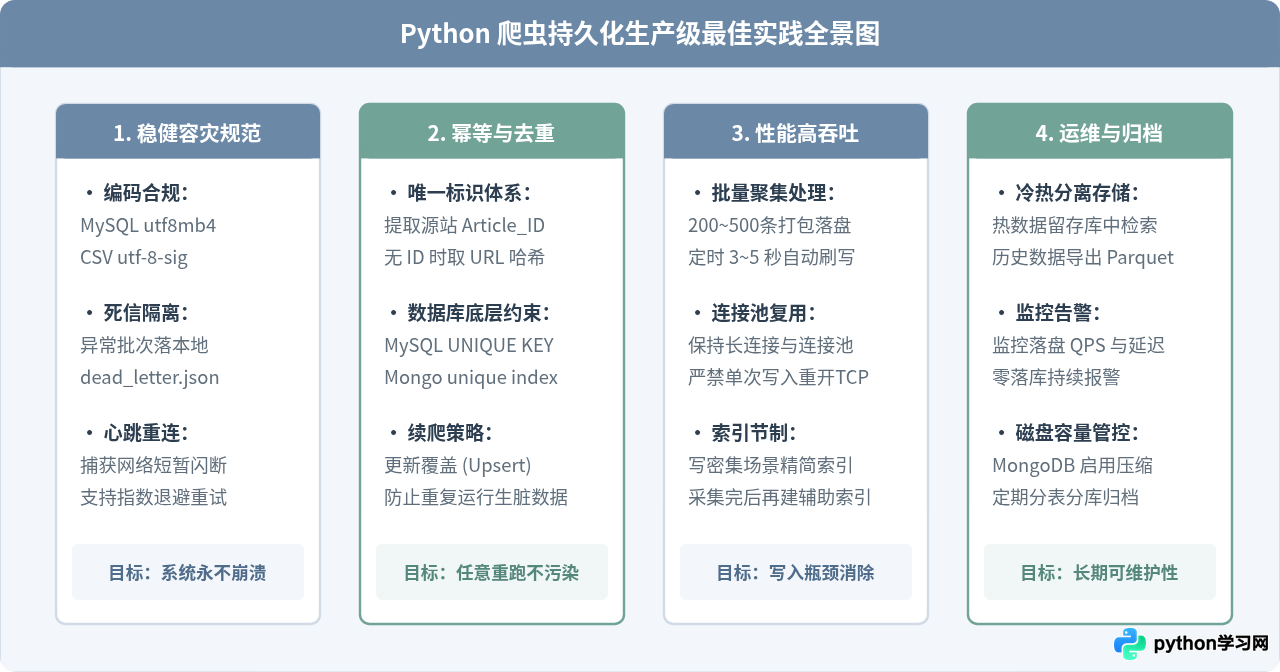
为了保证大规模长期爬取的稳定性,建议在实现时严格落地以下四个维度的设计规范:
- 内存批缓冲池(Batch Buffer): 绝不能每抓一条就执行一次写入。在内存中维护 100~500 条的列表缓冲,达到数量或满 5 秒时统一 Flush。这样能降低网络系统调用频次 95% 以上,极大缓解数据库主机的压力。
- 唯一键与幂等设计: 优先使用目标源的数据 ID(如商品 ID、文章 ID),若源站无显式 ID,则对“关键业务字段(例如:URL + 发布时间)”进行 MD5 计算得到哈希摘要,作为数据库的唯一索引。
- 编码与字符集兼容: 任何处理中文与现代互联网文本的系统,MySQL 库表必须设为
utf8mb4,CSV 写入必须使用utf-8-sig,彻底杜绝 Unicode 截断与显示乱码。 - 死信队列(Dead Letter Queue)落盘兜底: 当数据库由于死锁、账号鉴权或断网抛出不可恢复的致命异常时,持久化管道绝不应让爬虫崩溃,而应将当前批次直接 dump 到本地的
dead_letter_YYYYMMDD.json,待数据库恢复后通过离线脚本补录。
八、总结与选型指南
持久化是网络数据采集生命周期的终点,也是下游数据消费与算法分析的起点。回到最初的选型问题:
- 如果你正在做一次性采集、小规模数据探索或直接向运营人员交付报表,选择 CSV 并配置好
utf-8-sig与newline="",是最快速有效的手段。 - 如果你面对的是电商详情、社交舆情、内容字段动态多变且包含嵌套对象的数据,首选 MongoDB,借助
bulk_write和upsert=True实现近乎零维护的高速入库。 - 如果你需要将采集数据对接到严格的企业级核心数据表、财务业务系统或进行高频跨表 SQL 关联,选择 MySQL,规范使用
utf8mb4与INSERT ... ON DUPLICATE KEY UPDATE,确保数据强类型与事务可靠性。
建立规范的缓冲池与幂等去重逻辑,不仅能让爬虫在面临各种异常时稳如磐石,更能确保采集到的海量数据能够整齐、干净地转化为持久的业务价值。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









