

Python爬虫开发需要哪些软件?Requests与Scrapy技术栈介绍
进行Python爬虫开发,核心需要三类软件:一是Python解释器与代码编辑器(用于编写与运行代码),二是浏览器开发者工具及抓包分析软件(用于观察目标网页的网络请求),三是爬虫与数据解析库(用于具体抓取与清洗数据)。在技术栈选择上,轻量小规模任务首选Requests搭配解析器,而中大型、深层链接采集任务则通常采用功能完备的工程框架Scrapy。本文将具体梳理爬虫开发所需的软件清单,并详细拆解这两大主流技术栈的架构与使用方法。
一、Python爬虫开发所需的基础软件清单
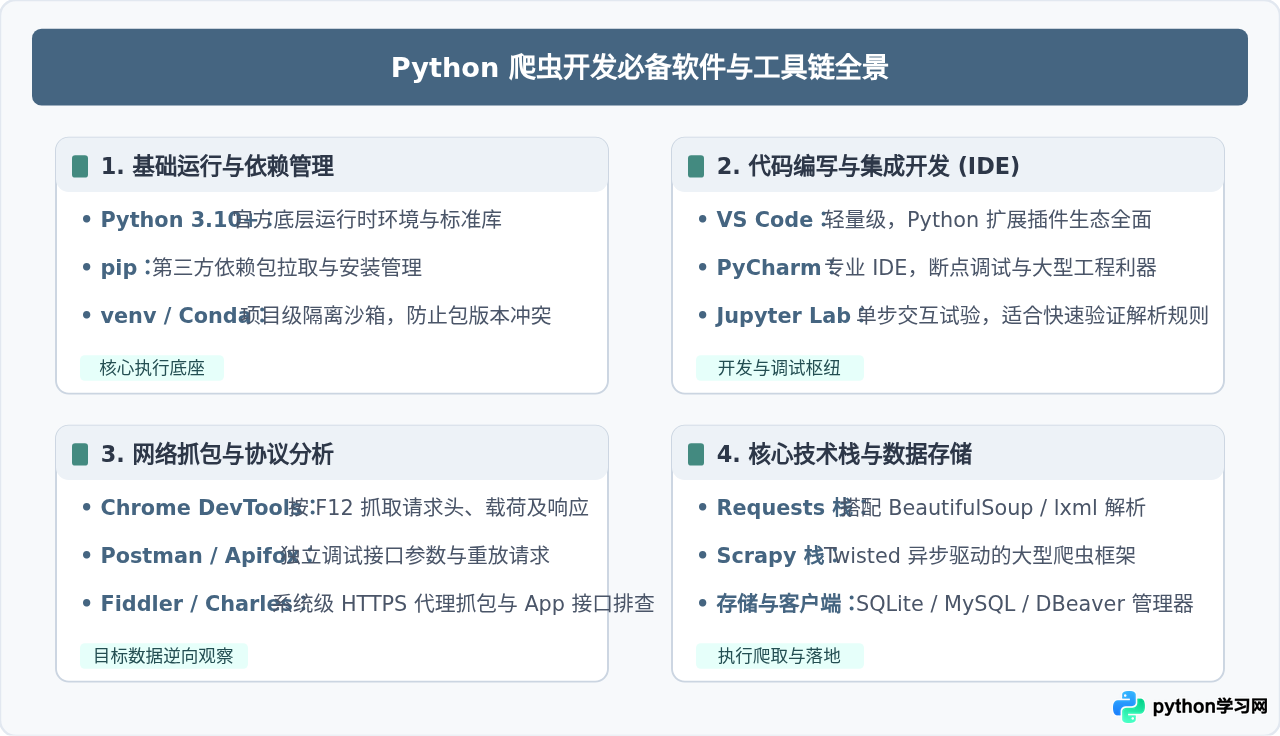
网络爬虫的本质是模拟浏览器向目标服务器发送网络请求,接收并解析返回的响应数据。要完成从抓包分析到持久化存储的全过程,需要在电脑中准备以下几个核心软件与工具:
1. 运行环境与依赖管理
- Python 解释器:推荐安装 Python 3.10 或 3.11 官方稳定版本。它是运行爬虫程序的底座,自带标准库(如
urllib、json、re)和包管理器pip。 - pip 与虚拟环境(venv):Python 自带的包管理工具。建议为每个爬虫项目单独创建虚拟环境,避免不同项目间的第三方库版本冲突。
2. 代码编写与集成开发环境(IDE)
- Visual Studio Code(VS Code):轻量且生态丰富的编辑器。安装 Python 和 Pylance 插件后,具备代码提示、调试断点、环境变量管理与终端一体化能力,适合绝大多数爬虫开发。
- PyCharm(Community 或 Professional):专业的 Python IDE。开箱即用,代码重构、目录导航以及复杂工程的断点单步调试体验极佳,特别适合维护 Scrapy 这种多文件工程项目。
3. 协议分析与网络抓包软件
- 现代浏览器开发者工具(DevTools):按键盘
F12或快捷键打开,核心使用Network(网络)标签页。在爬取前,必须用它观察请求的 URL、Request Headers(如 User-Agent、Cookie)、请求方式(GET/POST)以及响应类型(HTML 还是 JSON)。 - 接口测试软件(Postman 或 Apifox):用于单独抽离接口进行参数模拟和重放,验证在脱离浏览器时接口是否正常返回数据。
- 系统级抓包工具(Fiddler 或 Charles):当目标网站有复杂的重定向、移动端 App 接口抓取或需要配置全局代理排查流量时使用。
二、Requests 与 Scrapy 核心特性与技术栈对比
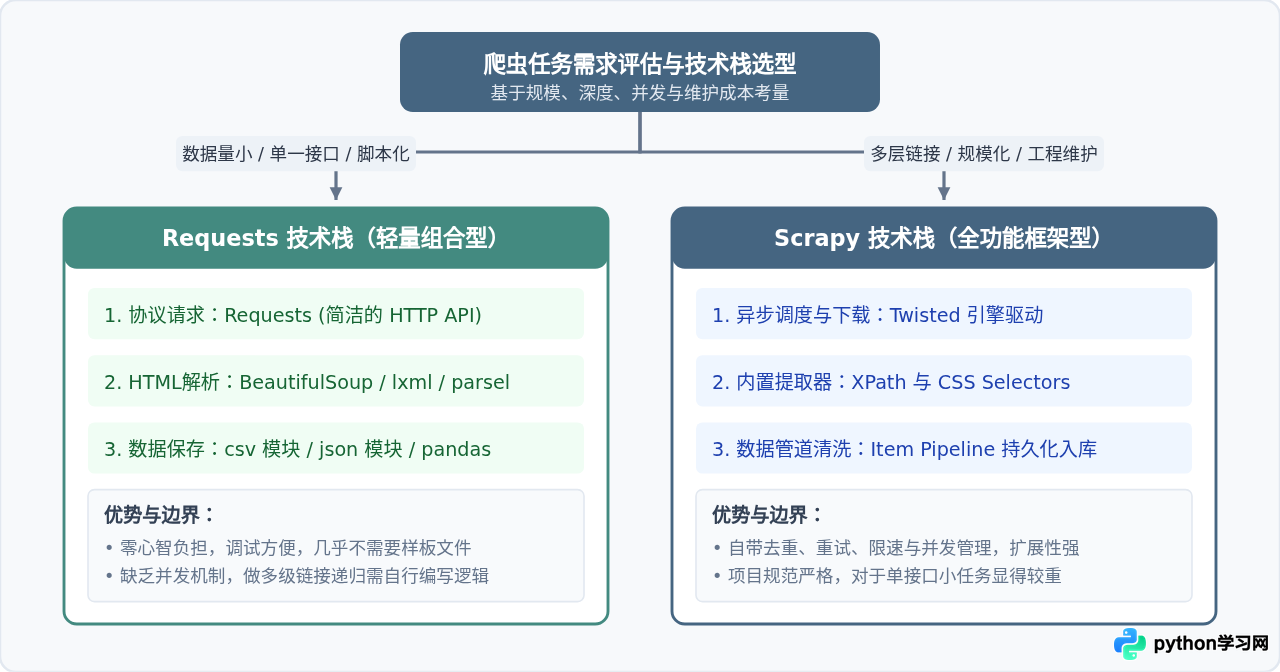
在 Python 爬虫生态中,Requests 和 Scrapy 分别代表了“函数库自由组合”与“一体化工程框架”两种截然不同的架构路线。选择哪个技术栈,取决于任务的数据规模、网站结构复杂度以及团队协作需求。
| 对比维度 | Requests 技术栈(轻量级) | Scrapy 技术栈(工程级) |
|---|---|---|
| 本质定位 | 纯 HTTP 请求库,只负责发送与接收网络报文 | 完整的工业级爬虫框架,内置调度、并发与管道 |
| 解析与提取 | 不含解析功能,需额外搭配 BeautifulSoup、lxml 或 parsel | 内置 Selector,原生支持高效 XPath 与 CSS 选择器 |
| 并发与异步 | 默认单线程阻塞同步执行,并发需自己写多线程或协程 | 底层基于 Twisted 异步事件驱动,天然支持高并发非阻塞 |
| 去重与调度 | 需开发者自行维护 URL 集合或 Redis 记录 | 自带 Scheduler 与请求指纹哈希过滤,内置自动去重 |
| 学习与上手 | 极低,5 行代码即可跑通一次数据抓取 | 中等,需要理解引擎、中间件、Pipeline 等组件机制 |
| 适用场景 | 单页面数据抓取、监控小脚本、自动化接口调用、教学实验 | 整站采集、深层链接爬取、分布式抓取、百万级长期数据采集 |
三、Requests 技术栈:工作流程与基础实战
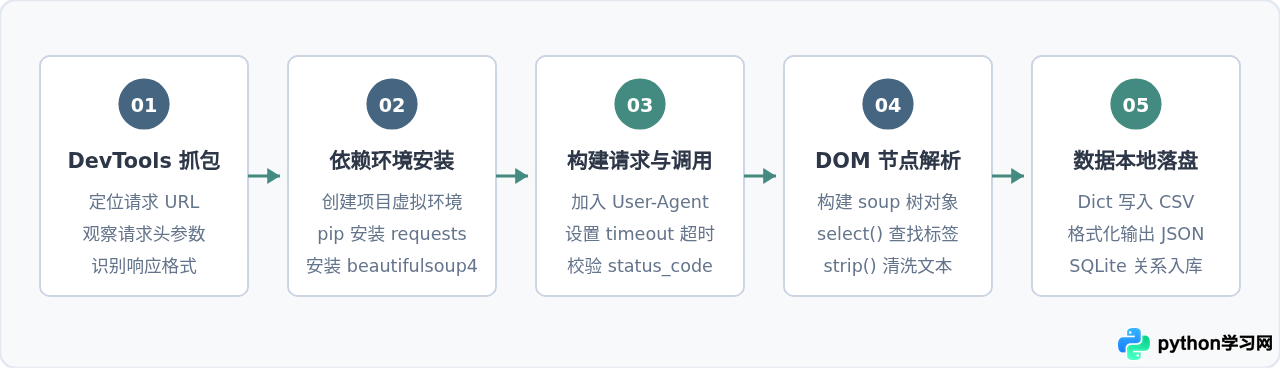
Requests 本身只专注于 HTTP 传输,在实际开发中,通常以 Requests(发请求)+ BeautifulSoup4 / lxml(解析文档)+ CSV / JSON(存储) 的组合形态运行。完整操作分为 5 个清晰步骤:
- 分析网页:打开浏览器 DevTools 检查目标内容的载入方式(静态 HTML 还是动态 Ajax)。
- 安装依赖:在终端执行安装命令。
- 构造请求:配置
Headers(至少包含User-Agent)并发出带有timeout的 GET/POST 请求。 - 解析提取:将响应的
response.text传入解析器,用 CSS 选择器或 XPath 提取字段。 - 持久化存储:将提取到的字典数据追加写入 CSV 或 JSON 文件。
依赖安装命令
# 激活虚拟环境后,安装 requests 与 bs4 解析器
pip install requests beautifulsoup4 lxml
完整代码示例
下面是一个标准的单文件爬取脚本,抓取网页中的文章标题与链接,并保存为 CSV:
import csv
import requests
from bs4 import BeautifulSoup

def fetch_articles(target_url):
    # 1. 明确伪装 User-Agent,避免使用默认 requests 请求头
    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36"
    }

    try:
        # 2. 设置 timeout,防止由于网络拥堵导致程序无限卡死
        response = requests.get(target_url, headers=headers, timeout=10)
        # 3. 如果返回 4xx 或 5xx 状态码,直接抛出异常
        response.raise_for_status()
        # 自动识别页面编码
        response.encoding = response.apparent_encoding
    except requests.exceptions.RequestException as e:
        print(f"请求失败,原因: {e}")
        return []

    # 4. 解析 HTML 内容
    soup = BeautifulSoup(response.text, "lxml")
    results = []

    # 假设目标列表包裹在 .article-item 中
    for item in soup.select(".article-item"):
        title_tag = item.select_one("h2.title")
        link_tag = item.select_one("a")

        if title_tag and link_tag:
            title = title_tag.get_text(strip=True)
            link = link_tag.get("href", "")
            results.append({"title": title, "link": link})

    return results

def save_to_csv(data_list, output_file="articles.csv"):
    if not data_list:
        print("未抓取到有效数据,跳过保存。")
        return

    # 5. 持久化写入 CSV,设置 utf-8-sig 防止 Windows Excel 打开乱码
    with open(output_file, mode="w", encoding="utf-8-sig", newline="") as f:
        writer = csv.DictWriter(f, fieldnames=["title", "link"])
        writer.writeheader()
        writer.writerows(data_list)
    print(f"已成功将 {len(data_list)} 条数据保存至 {output_file}")

if __name__ == "__main__":
    url = "https://example.com/blog"
    articles = fetch_articles(url)
save_to_csv(articles)四、Scrapy 技术栈:架构原理与工程落地
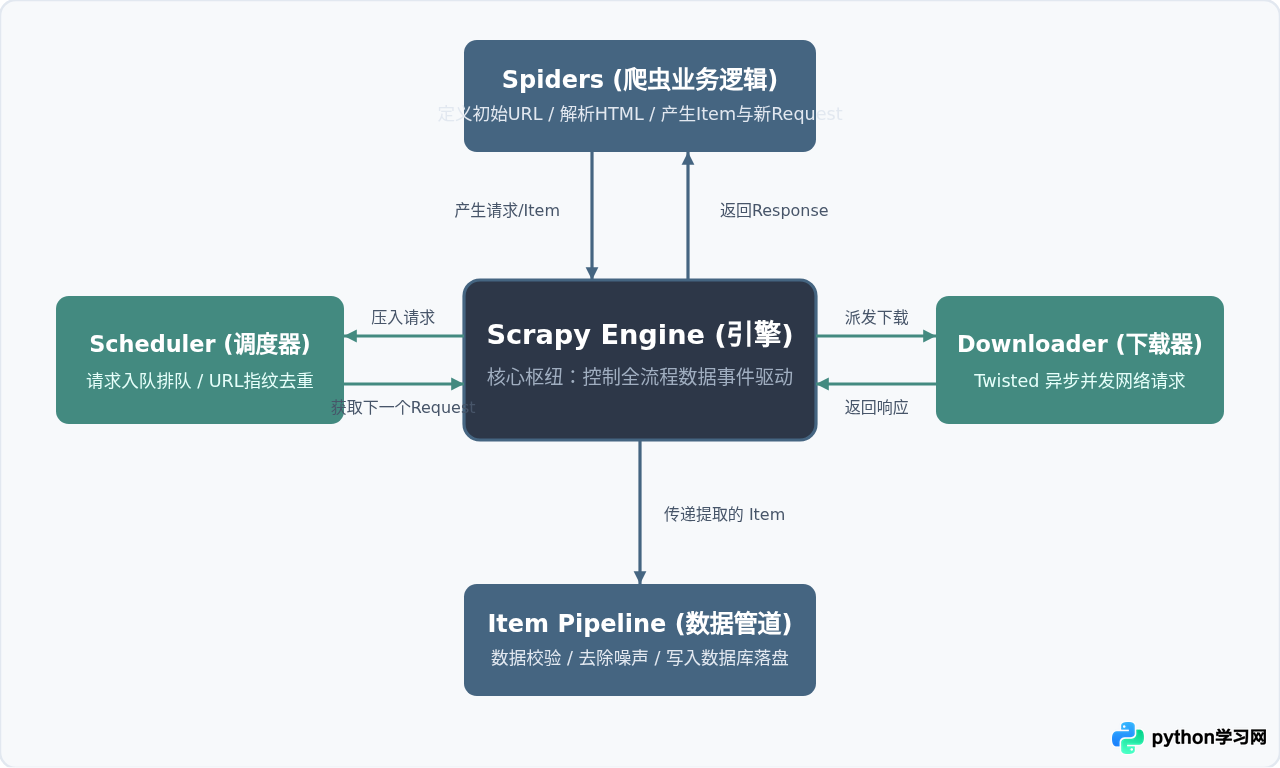
当采集需求拓展为全站抓取、包含数万个层级页面或需要高频并发时,自行编写线程池与去重队列的维护成本极高。此时应当使用 Scrapy。Scrapy 是一个基于异步网络库 Twisted 开发的应用框架,各组件之间职责高度解耦。
1. Scrapy 核心架构组件与数据流向
- Engine(引擎):核心大脑,负责协调各组件之间的数据与信号流动。
- Spiders(爬虫主体):用户编写解析逻辑的地方,定义起始 URL,解析响应,产生结构化数据
Item或新的Request。 - Scheduler(调度器):接收引擎转交的请求,在内存队列中排队,并自动计算请求指纹以过滤重复 URL。
- Downloader(下载器):高速异步下载网页内容,并将下载后的
Response传递回引擎。 - Item Pipeline(数据管道):负责对 Spider 提取出来的 Item 进行清洗、验证有效性及最终写入数据库(MySQL / MongoDB)。
- Middlewares(中间件):分为下载中间件(Downloader Middleware)和爬虫中间件(Spider Middleware),用于批量处理请求头注入、代理 IP 轮换和异常拦截。
2. Scrapy 工程初始化与开发流程
与 Requests 只需要写一个 .py 脚本不同,Scrapy 通过脚手架组织工程目录结构。开发步骤如下:
# 1. 安装 Scrapy
pip install scrapy

# 2. 创建一个名为 mycrawler 的工程骨架
scrapy startproject mycrawler

# 3. 进入目录并基于模板生成爬虫代码
cd mycrawler
scrapy genspider example example.com
生成的项目核心目录包含以下文件:
scrapy.cfg:项目部署配置文件。spiders/example.py:爬虫核心解析文件。items.py:定义提取字段的数据模型类。pipelines.py:处理与保存数据的持久化管道。settings.py:配置并发线程数、下载延迟、请求头与启用的中间件。
3. Scrapy 核心代码结构展示
在 spiders/example.py 中编写页面提取逻辑:
import scrapy

class ExampleSpider(scrapy.Spider):
    name = "example"
    allowed_domains = ["example.com"]
    start_urls = ["https://example.com/blog"]

    def parse(self, response):
        # 使用 Scrapy 内置的 CSS 选择器直接提取
        for article in response.css(".article-item"):
            yield {
                "title": article.css("h2.title::text").get(),
                "link": article.css("a::attr(href)").get(),
            }

        # 提取下一页链接并自动跟进
        next_page = response.css("a.next-page::attr(href)").get()
        if next_page is not None:
            # 自动将相对 URL 拼接为绝对 URL 并递归抓取
            yield response.follow(next_page, callback=self.parse)
在 pipelines.py 中处理数据持久化(例如过滤无标题脏数据并入库):
from scrapy.exceptions import DropItem

class CleanDataPipeline:
    def process_item(self, item, spider):
        # 字段清洗与验证
        if not item.get("title"):
            raise DropItem("缺少标题,丢弃该数据")
        item["title"] = item["title"].strip()
        return item
五、总结与高频注意事项
总结来说,入门并精通 Python 爬虫不需要安装过于复杂的专用软件,核心是掌握以 VS Code/PyCharm + 浏览器 DevTools 为代表的开发环境,并根据需求在 Requests 与 Scrapy 之间做出合理取舍:
- 针对单页面、小体量或固定 API 抓取:直接选用
Requests + BeautifulSoup4,开发周期以分钟计,依赖轻,排错直观。 - 针对复杂整站、多级链接遍历或大规模采集:坚决采用
Scrapy,依靠其异步并发、自动去重与管道分离能力,保障工程的健壮性。 - 动态渲染防御:如果目标网站采用前端深度渲染(如 React / Vue 纯客户端渲染且接口带复杂反爬签名),则需要引入 Playwright 或 Selenium 等无头浏览器驱动软件协助渲染页面,再配合解析库提取。
- 合规防封原则:在请求中务必带上真实规范的
User-Agent;在settings.py或脚本中配置DOWNLOAD_DELAY增加下载间隔,避免对目标服务器造成拒绝服务攻击。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









