

Python遍历字典键值对进行数据格式化与转换实例
在 Python 业务开发、日志分析和 API 数据对接场景中,字典是最常用的非线性数据承载结构。原始字典数据往往存在键名格式不统一、数值类型不规范、嵌套冗余以及需要转义等问题。本文通过系统讲解 dict.items() 迭代机制,结合格式化字符串输出、数据清洗管道、字典推导式以及嵌套结构扁平化等完整实例,展示如何高效遍历键值对并完成各类结构转换。
一、字典键值对遍历机制与基础解构
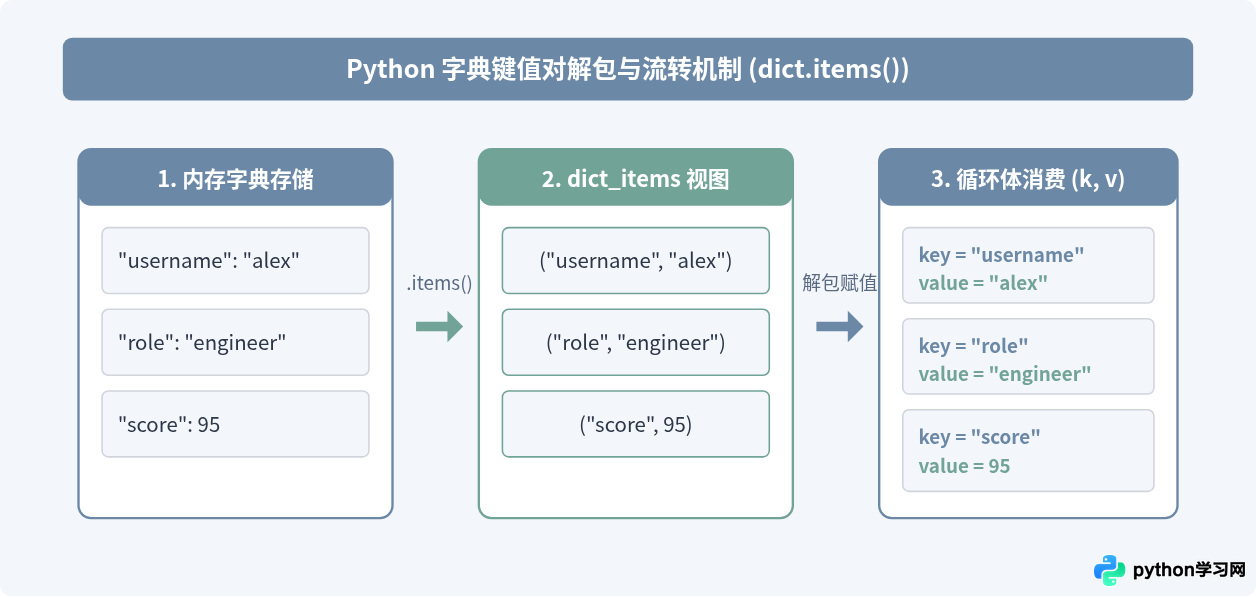
遍历字典的直接目的通常是同时获取“键”(Key)与“值”(Value)。在 Python 中,字典提供了 keys()、values() 与 items() 三种视图方法。若需同时处理键与值,dict.items() 是最为高效且地道的做法。
items() 方法返回一个动态视图对象(dict_items),它提供字典项的只读视图。当字典发生变动时,该视图会实时响应。在 for 循环中,Python 会自动将每个二元元组 (key, value) 进行解包赋值:
# 基础解构示例
user_profile = {
    "username": "alex_chen",
    "role": "data_engineer",
    "login_count": 42
}

for key, value in user_profile.items():
    print(f"属性名: {key} -> 属性值: {value}")
for key in user_profile: value = user_profile[key]。这种写法在每次循环中额外触发一次哈希寻址与取值操作,不仅代码冗长,在大规模字典场景下更会增加不必要的开销。使用 items() 则是一次性迭代出键值元组。
二、格式化输出实战:对齐、报表与 Query 参数构建
遍历字典最常见的直接需求是将结构化数据拼接为便于展示或传输的文本。结合 Python 的 f-string 格式化能力与标准库,可以优雅地完成多列对齐与编码拼接。
1. 控制台对齐与报表文本生成
当需要打印监控指标、性能数据或账单详情时,利用 f-string 的对齐填充语法(如 <20 左对齐,>10 右对齐)可以快速对齐文本:
# 运行环境: Python 3.8+
server_metrics = {
    "cpu_usage_pct": 74.382,
    "memory_used_mb": 8192.0,
    "active_connections": 1250,
    "disk_io_iops": 450.6
}

print(f"{'指标名称':<22} | {'指标值':>12}")
print("-" * 38)
for metric_key, val in server_metrics.items():
    # 对浮点数与整数分别格式化
    if isinstance(val, float):
        formatted_val = f"{val:>12.2f}"
    else:
        formatted_val = f"{val:>12,d}"
    print(f"{metric_key:<22} | {formatted_val}")
示例输出:
指标名称                   |          指标值
--------------------------------------
cpu_usage_pct          |        74.38
memory_used_mb         |     8,192.00
active_connections     |        1,250
disk_io_iops           |       450.60
2. URL 查询参数与 Key-Value 序列拼接
网络请求中,通常需要将字典转为符合 HTTP 规范的 Query 字符串(如 keyword=python&limit=20&active=true)。在遍历过程中需要注意对值进行字符串转化并对特殊符号进行 URL 编码:
from urllib.parse import quote_plus

query_payload = {
    "keyword": "python 遍历",
    "category_id": 105,
    "sort_by": "created_at",
    "include_draft": False
}

pairs = []
for key, value in query_payload.items():
    # 布尔值转为小写字符串,其余值转字符串后执行编码
    if isinstance(value, bool):
        val_str = str(value).lower()
    else:
        val_str = str(value)
    encoded_pair = f"{quote_plus(str(key))}={quote_plus(val_str)}"
    pairs.append(encoded_pair)

query_string = "&".join(pairs)
print("拼接结果:", query_string)
# 示例输出: keyword=python+%E9%81%8D%E5%8E%86&category_id=105&sort_by=created_at&include_draft=false
三、数据清洗与结构转换操作流程
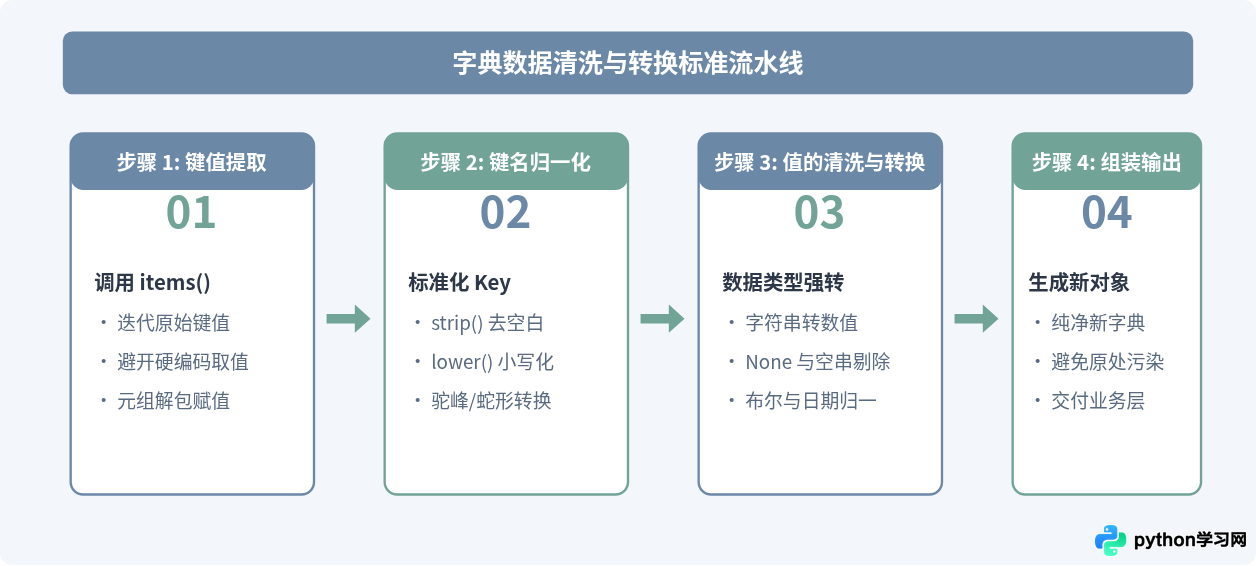
真实项目中的字典往往来自前端表单、第三方接口或数据库查询,存在大小写混乱、前导空格、类型缺失或非法空值等情况。构建一个标准清洗流程能显著提升系统稳健性。
完整数据清洗实例代码
假设我们收到来自前端表单的脏数据字典,需要将其键名统一转换为蛇形小写(snake_case),并把数值字符串转换为对应的整型或浮点型,过滤掉无效的 None 和全空格字符串:
raw_form_data = {
    " User_Name ": "  zhang_san  ",
    "Age": "28",
    "Account_Balance": "15200.50",
    "IS_VIP": "true",
    "Remark": "   ",
    "Optional_TAG": None
}

def clean_and_convert_dict(raw_data: dict) -> dict:
    cleaned = {}
    for key, value in raw_data.items():
        # 1. 清理键名:去首尾空格并小写化
        clean_key = str(key).strip().lower()

        # 2. 检查与清洗值
        if value is None:
            continue  # 丢弃为 None 的字段

        if isinstance(value, str):
            val_stripped = value.strip()
            if not val_stripped:
                continue  # 丢弃纯空白字符串

            # 3. 类型识别与转换
            if val_stripped.lower() in ("true", "false"):
                cleaned[clean_key] = val_stripped.lower() == "true"
            elif val_stripped.isdigit():
                cleaned[clean_key] = int(val_stripped)
            else:
                try:
                    cleaned[clean_key] = float(val_stripped)
                except ValueError:
                    cleaned[clean_key] = val_stripped
        else:
            cleaned[clean_key] = value

    return cleaned

result = clean_and_convert_dict(raw_form_data)
print("清洗后字典:", result)
转换结果说明:
清洗后字典: {
    'user_name': 'zhang_san',
    'age': 28,
    'account_balance': 15200.5,
    'is_vip': True
}
四、字典推导式与键值翻转的高级转换
对于逻辑较清晰的轻量转换场景,使用 字典推导式(Dictionary Comprehension) 可以将代码从数行浓缩为单行表达式,具备极佳的可读性与执行效率。
1. 字典推导式的典型应用
- 条件过滤:仅保留满足条件的键值对(如提取数值大于阈值的项)。
- 数值缩放与加工:对所有数值统一乘以系数或应用转换函数。
- 键名映射转换:为所有键名添加特定命名空间前缀。
# 商品原始价格字典
prices_in_usd = {"laptop": 1200, "mouse": 25, "keyboard": 75, "display": 350}
exchange_rate = 7.25

# 转换需求:仅保留总价大于 50 美元的商品,并转换为人民币(保留两位小数)
cny_prices = {
    item.upper(): round(price * exchange_rate, 2)
    for item, price in prices_in_usd.items()
    if price >= 50
}

print(cny_prices)
# 示例输出: {'LAPTOP': 8700.0, 'KEYBOARD': 543.75, 'DISPLAY': 2537.5}
2. 键值互换(Invert Dictionary)及其安全约束
在数据检索与状态码逆向查找时,常需要将 {key: value} 倒转为 {value: key}。必须注意两个硬性约束:
- 哈希约束:原字典的值必须是可哈希类型(如字符串、数字、元组);若值是列表或字典,直接充当新键会引发
TypeError: unhashable type。 - 唯一性约束:如果原字典中存在重复的 Value,后遍历到的键会直接覆盖先遍历到的键。若需保留全部映射,需将新值聚合为列表或集合。
# 场景:状态码映射逆向检索
status_code_map = {
    "SUCCESS": 200,
    "NOT_FOUND": 404,
    "INTERNAL_ERROR": 500,
    "BAD_GATEWAY": 502
}

# 简单反转(值无重复时)
code_to_status = {code: name for name, code in status_code_map.items()}
print("反转字典:", code_to_status[200]) # 输出: SUCCESS

# 复杂反转:允许多对一场景下的安全聚合反转
user_department = {
    "alice": "IT",
    "bob": "HR",
    "charlie": "IT",
    "david": "Finance"
}

dept_to_users = {}
for user, dept in user_department.items():
    dept_to_users.setdefault(dept, []).append(user)

print("聚合反转:", dept_to_users)
# 示例输出: {'IT': ['alice', 'charlie'], 'HR': ['bob'], 'Finance': ['david']}
五、嵌套字典的递归处理与安全修改
复杂 API 响应通常包含多层嵌套字典(如配置树或微服务响应体)。如果需要遍历并格式化深层节点,需要采用递归函数配合键路径拼接。
1. 递归扁平化(Flattening)嵌套字典
将多层嵌套结构转换为单层扁平字典,把父子键名以点号(.)或下划线连接,是存入关系型数据库或导出 CSV 的标准手段:
nested_config = {
    "app": {
        "name": "payment_service",
        "port": 8080
    },
    "database": {
        "primary": {
            "host": "10.0.0.12",
            "port": 5432
        },
        "pool_size": 20
    }
}

def flatten_dict(d: dict, parent_key: str = "", sep: str = ".") -> dict:
    items = []
    for k, v in d.items():
        new_key = f"{parent_key}{sep}{k}" if parent_key else str(k)
        if isinstance(v, dict):
            # 遇到子字典递归处理
            items.extend(flatten_dict(v, new_key, sep=sep).items())
        else:
            items.append((new_key, v))
    return dict(items)

flat_result = flatten_dict(nested_config)
for key, value in flat_result.items():
    print(f"{key} = {value}")
扁平化运行输出:
app.name = payment_service
app.port = 8080
database.primary.host = 10.0.0.12
database.primary.port = 5432
database.pool_size = 20
2. 防御性陷阱:遍历时不可就地增删键
在遍历字典时,千万不要在循环体内部直接执行 del d[k] 或 d[new_k] = v。Python 迭代器会检测哈希表结构变化,直接抛出异常:
# 错误示例:
data = {"a": 1, "b": 2, "c": 3}
for k, v in data.items():
    if v == 2:
        del data[k]  # 触发 RuntimeError: dictionary changed size during iteration
推荐的安全解决方案:
- 使用列表固化键视图:
for k, v in list(data.items()):,此时循环的是一个独立的静态列表快照,删除原字典键不会影响当前迭代。 - 构建过滤新字典:
data = {k: v for k, v in data.items() if v != 2},这是推荐的标准做法,无副作用且内存友好。
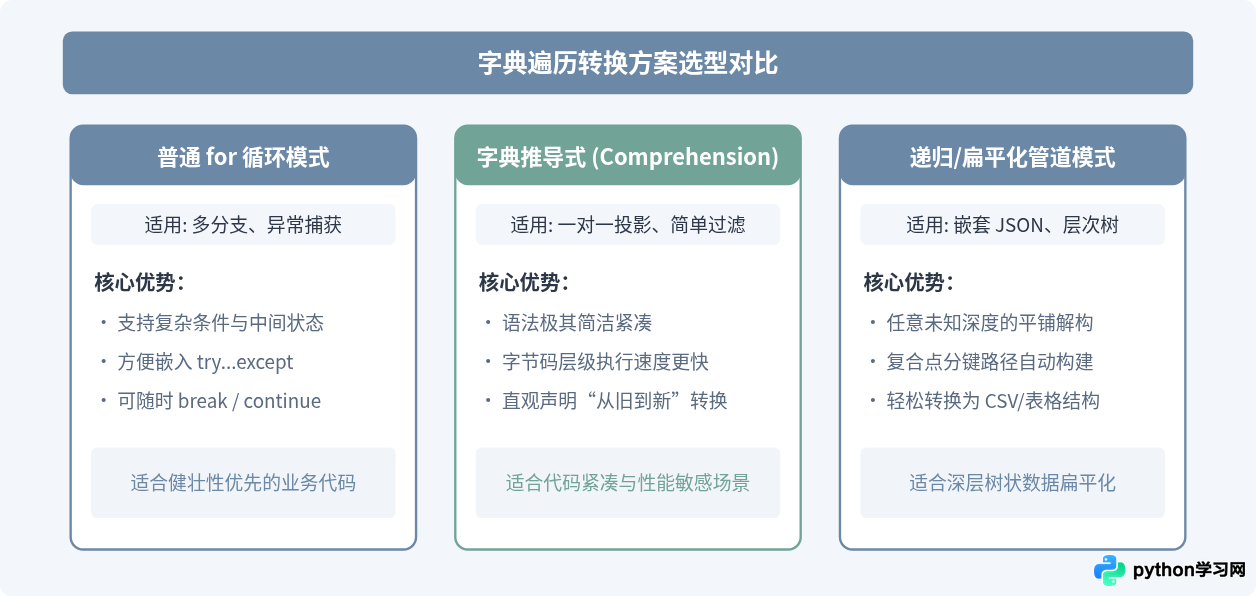
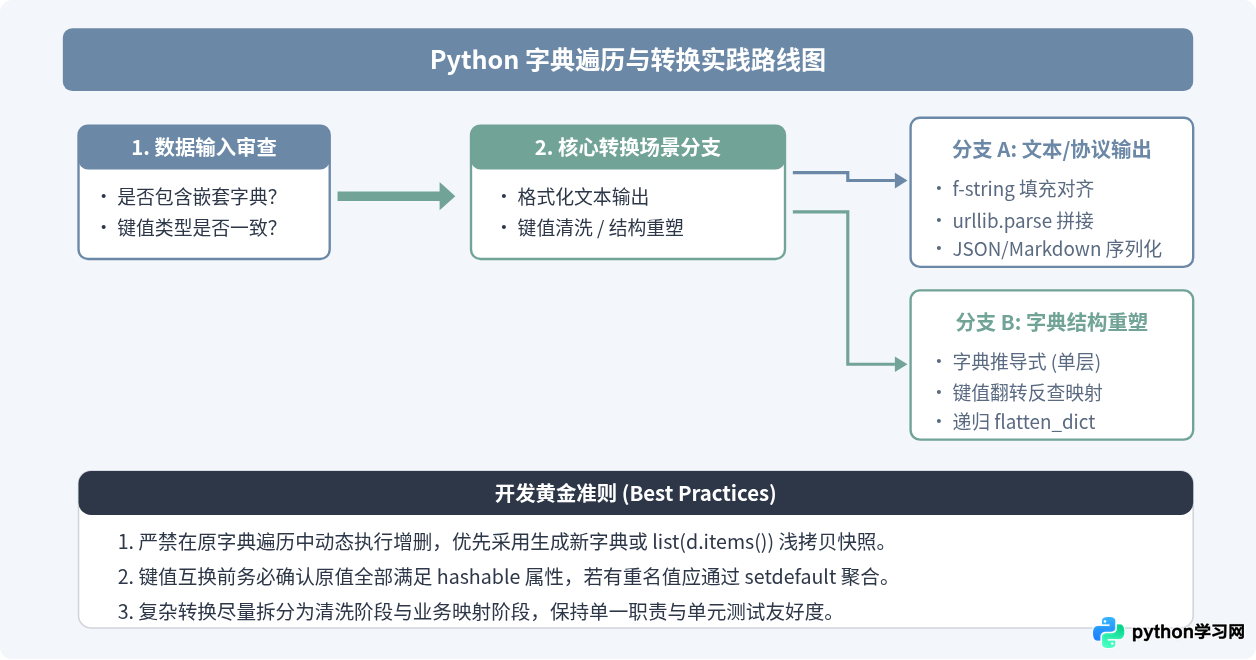
六、实践决策路线与速查指南
为了在实际编码中快速选择最合理的转换工具,以下路线图梳理了从需求确认到方法落地的决策链条:
| 场景类型 | 首选操作方式 | 核心优势 | 潜在风险与防范 |
|---|---|---|---|
| 报表与日志输出 | for k, v in d.items() + f-string |
精确控制对齐宽度、精度与千分位 | 数据类型不兼容引发格式化异常,需预先类型判断 |
| 轻量映射与过滤 | 字典推导式 {k: v for ...} |
语法精简、语义清晰、内部字节码优化 | 逻辑过深影响可读性,多层分支应回退至函数 |
| 脏数据清洗 | 自定义清洗函数 + 新字典累积 | 可加入完整异常处理与类型兜底 | 内存占用加倍,对超大字典可考虑生成器管道 |
| 键值翻转查询 | {v: k for k, v in d.items()} |
实现 O(1) 反向索引 | 值不可哈希抛异常;重复值导致静默覆盖丢失 |
| 多层配置展平 | 递归解析并拼接点号路径 | 彻底解耦层级深度,适配二维表格 | 层级极深时注意递归上限(通常默认 1000 层) |
掌握字典键值对遍历的本质与各种转换模式后,开发者可以依据具体的数据规模、嵌套层级与健壮性要求灵活搭配工具,写出既高效又具备高可维护性的 Python 数据处理代码。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









