

从零开始写Python爬虫:HTTP协议基础与请求头构造详解

编写Python爬虫的本质,是让计算机程序模拟人类在浏览器中的网络交互行为,向目标网站服务器发送请求并接收其返回的数据。很多初学者在初学爬虫时,写出两行代码直接调用请求库却立刻遭遇访问拒绝(如403 Forbidden),根本原因就在于未理解HTTP协议的通信格式,以及忽略了关键的请求头伪装。本文将从网络请求与响应的基本模型讲起,深入剖析HTTP请求报文的结构细节与核心字段,并通过具体代码演示如何在Python中构造规范且安全的请求头。
一、HTTP协议通信基础与请求报文结构
HTTP(超文本传输协议)是无状态的、基于“请求-响应”模型的应用层协议。客户端(通常是浏览器或爬虫程序)发起TCP连接并向服务器发出一个HTTP请求(Request),服务器处理完成后返回一个HTTP响应(Response),随后根据连接策略维持或关闭通道。
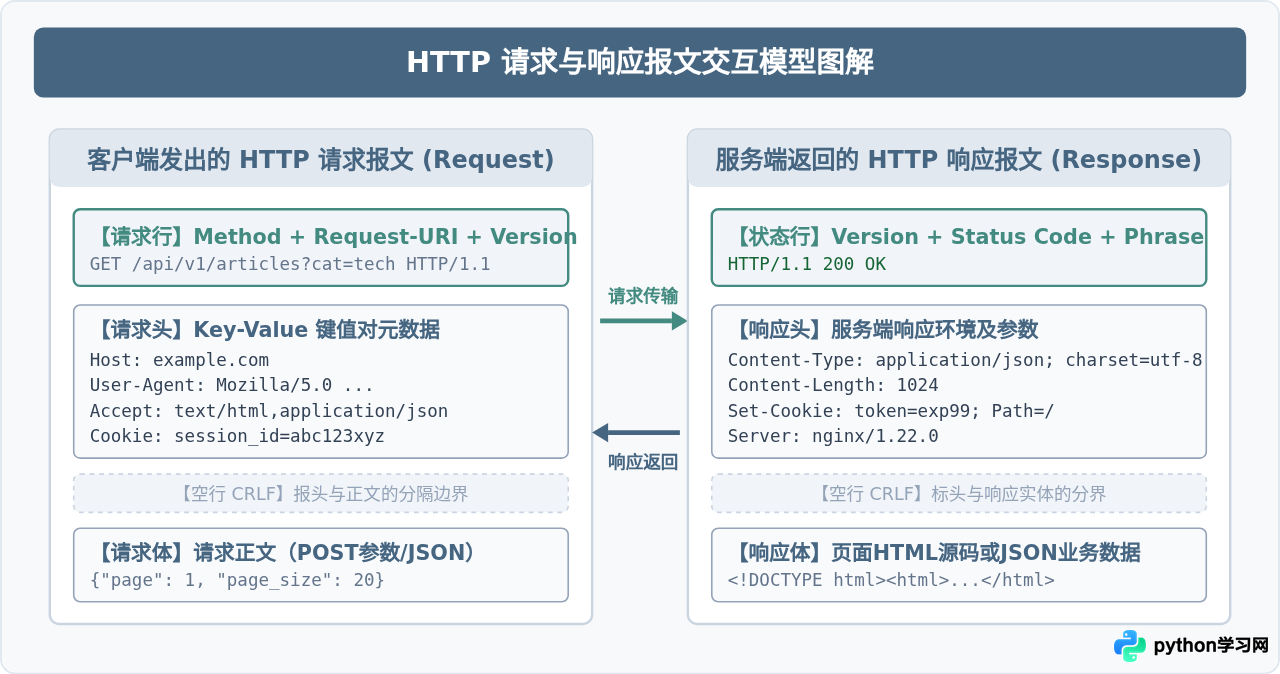
一个标准的HTTP请求报文自上而下严格由四部分组成:
- 请求行(Request Line):包含请求方法(如GET、POST)、请求的目标资源路径(URL路径与查询参数)以及HTTP协议版本号(如HTTP/1.1)。
- 请求头(Request Headers):键值对形式的元数据,向服务端告知客户端的软硬件环境、接受能力、来源地址及身份凭证等。这是爬虫防封伪装的关键阵地。
- 空行(CRLF):单独的一个回车换行符,作为标头部分结束与正文内容开始的物理分界线。
- 请求体(Request Body):可选的数据载荷,在GET请求中通常为空,在POST或PUT请求中包含表单数据、JSON文本或上传的文件。
二、获取目标请求头的实操步骤
编写爬虫时,凭空猜测请求头字段往往会导致参数遗漏。最稳妥的做法是从真实的浏览器网络会话中捕获并分析目标请求。无论是 Chrome、Edge 还是 Firefox,都内置了功能完备的开发者工具。
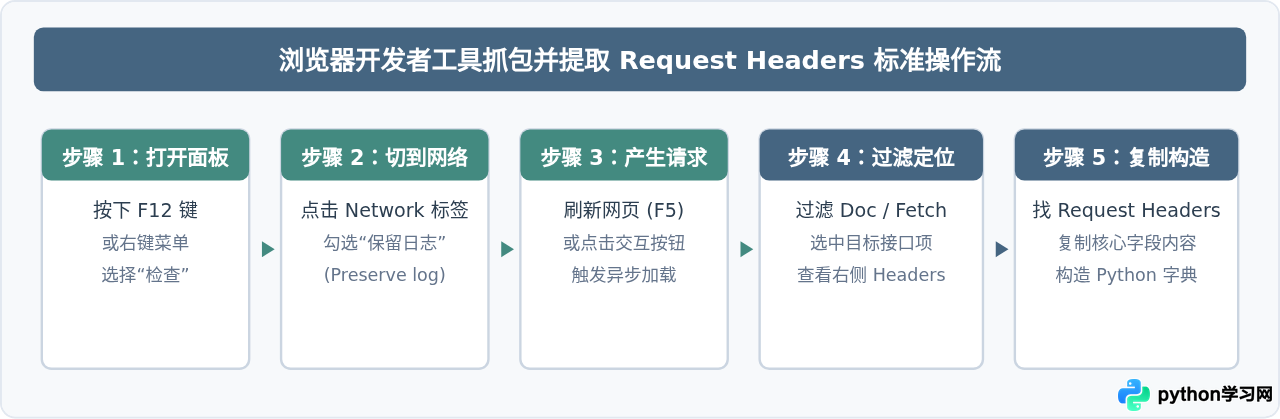
抓取目标请求头并提取参数的规范操作流程如下:
- 打开开发者工具:在目标网页空白处点击右键选择“检查”,或直接按下快捷键
F12(macOS 为Cmd + Option + I)。 - 定位到网络面板:点击顶部导航栏中的 Network(网络) 面板。确保左上方的红色录制指示灯处于激活状态。
- 触发目标网络请求:按
F5刷新页面,或者在网页上进行点击翻页、加载列表等操作。此时面板中将实时打印出浏览器发起的所有资源请求。 - 筛选与查看目标项:在筛选栏中选择
Doc(主文档HTML)或Fetch/XHR(异步接口JSON)。在请求列表列表中选中具体 URL,并在右侧详情中切换到 Headers 选项卡。 - 复制并转换为字典:在 Request Headers 区域查看浏览器附带的原始标头,提取关键字段复制到 Python 代码的字典结构中。
三、爬虫必须掌握的核心请求头字段与反爬机制
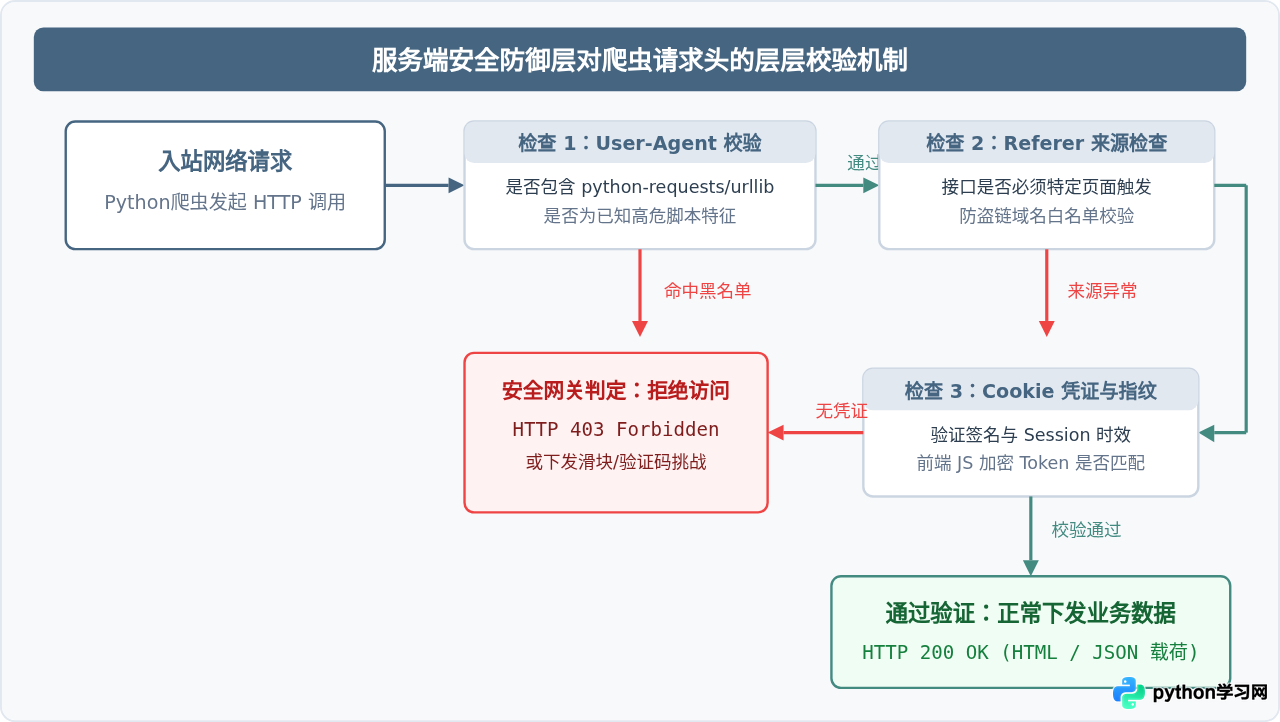
虽然一次真实的浏览器访问可能包含数十个请求头,但在爬虫开发中,服务端安全网关(WAF)重点比对和校验的通常集中在以下几个核心字段:
1. User-Agent(用户代理)
User-Agent 是请求头中最重要的身份标识字段,它声明了访问者的浏览器品牌、内核版本以及操作系统信息。如果使用 Python 发起未经配置的请求,各个库会暴露其默认特征:
urllib默认发送类似Python-urllib/3.11的头部;requests默认发送类似python-requests/2.31.0的头部。
多数面向公网的 Web 服务器仅凭这条规则就能在几毫秒内直接识别并拦截非浏览器请求,直接返回 403 错误代码。因此,为每一次请求手动配置真实浏览器的 User-Agent 是爬虫开发的第一准则。
2. Referer 与 Origin(来源追踪)
Referer 记录了当前请求是从哪一个上级网页链接跳转或引用而来的。服务端经常利用它来实现防盗链验证或非法调用拦截:
- 接口调用防刷:如果某内部数据接口只允许在
https://example.com/detail/1001页面内通过 JS 调用,那么直接在爬虫里裸调该接口(Referer 为空或不匹配域名)将被直接判定为非法。 - 图片/资源防盗链:服务器比对 Referer 域是否属于白名单,非本站引用则返回 403 或占位图。
3. Cookie(会话维持与凭证)
HTTP 协议本身是无状态的,Web 服务器通过在客户端植入 Cookie 来记录用户身份、登录状态与浏览上下文。对于需要登录才能查看的内容,或者带有防爬机制(如由前端 JavaScript 计算出的临时 token 写入 Cookie)的网站,必须在请求头中完整携带有效的 Cookie 字符串。
4. Host 与 :authority
Host 标明请求的目标主机域名和端口号。在反向代理(如 Nginx)和云服务 CDN 架构中,单台物理服务器通常托管了多个不同域名的虚拟主机。若请求头缺少正确的 Host,或者发出的 Host 与连接的 IP 不匹配,服务器将无法定位对应的站点配置,从而返回 400 Bad Request 或 404。
5. Accept 与 Accept-Encoding
Accept 告知服务器客户端期望获取的文件格式(如 text/html 或 application/json)。Accept-Encoding 声明支持的压缩算法(如 gzip, deflate, br)。
Accept-Encoding: gzip, deflate, br 时需注意:若目标网站采用 Brotli(br)算法压缩返回体,而本地 Python 环境未安装 brotli 解压库,直接使用 response.text 可能会解析出乱码。建议使用 requests 时交由库自身自动处理编码谈判,或确保相应解码依赖已就绪。
四、Python 代码实战:构造与管理请求头
掌握了基本原理后,接下来使用具体代码进行实战演练。在 Python 中,既可以使用内置的 urllib 模块,也可以使用工业界主流的第三方 requests 库。
1. 使用内置库 urllib.request 构造请求
如果当前运行环境受限,无法通过 pip 安装第三方包,可以使用 Python 标准库内置的 urllib.request。通过显式实例化一个 Request 对象,将目标 URL 与自定义请求头字典一同包装后发送:
import urllib.request
import urllib.error

url = "https://httpbin.org/headers"

# 1. 构造请求头字典
headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36",
    "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,image/webp,*/*;q=0.8",
    "Accept-Language": "zh-CN,zh;q=0.9,en;q=0.8",
    "Referer": "https://httpbin.org/"
}

# 2. 创建包含 Headers 的 Request 对象
req = urllib.request.Request(url=url, headers=headers, method="GET")

try:
    with urllib.request.urlopen(req, timeout=10) as response:
        status_code = response.getcode()
        content = response.read().decode("utf-8")
        print(f"响应状态码: {status_code}")
        print("服务端接收到的请求头反馈:")
        print(content)
except urllib.error.HTTPError as e:
    print(f"HTTP 请求异常: {e.code} - {e.reason}")
except urllib.error.URLError as e:
    print(f"网络连接异常: {e.reason}")
2. 使用 requests 库构造与发送请求
在实际生产开发中,requests 是更为推崇的选择,语法更为简洁,且会自动管理连接池与响应编码。构造请求头只需定义一个字典,并通过 headers 关键字参数传入即可:
import requests

target_url = "https://httpbin.org/headers"

# 构造请求头字典
custom_headers = {
    "User-Agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/122.0.0.0 Safari/537.36",
    "Accept": "application/json, text/plain, */*",
    "Referer": "https://httpbin.org/",
    "Connection": "keep-alive"
}

try:
    response = requests.get(target_url, headers=custom_headers, timeout=8)
    # 状态码非 200 时主动抛出异常
    response.raise_for_status()

    # 解析并输出返回的 JSON
    data = response.json()
    print("成功获取响应,服务端记录的请求头为:")
    for key, value in data.get("headers", {}).items():
        print(f"  {key}: {value}")
except requests.exceptions.RequestException as err:
    print(f"请求失败: {err}")
3. 企业级推荐实践:使用 requests.Session 统一管理请求头与 Cookie
在连续爬取同一个网站的多页面或翻页接口时,不建议每次都手动重复传入字典,也不应让每一次调用都重新建立底层 TCP 握手。使用 requests.Session() 可以持久化会话连接并保持 Cookie:
import requests

# 1. 创建会话对象
session = requests.Session()

# 2. 为整个会话配置全局通用请求头
session.headers.update({
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/122.0.0.0 Safari/537.36",
    "Accept-Language": "zh-CN,zh;q=0.9",
    "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8"
})

# 3. 后续所有通过 session 发起的请求都会自动带上上述 Headers
resp1 = session.get("https://httpbin.org/cookies/set?session_token=secret_98765")
print(f"步骤1状态: {resp1.status_code}")

# 后续请求不仅带上 Headers,还会自动在 Cookie 头中附带上文返回的 session_token
resp2 = session.get("https://httpbin.org/cookies")
print("步骤2附带的 Cookie 状态:", resp2.json())

# 针对特定接口,可覆盖或追加临时请求头
resp3 = session.get("https://httpbin.org/headers", headers={"X-Custom-Trace": "job-101"})
print("步骤3请求头包含临时追加项:", resp3.json()["headers"].get("X-Custom-Trace"))

# 任务完成后关闭会话连接池
session.close()
五、知识总结与关键字段配置速查
在构造请求头时,并非字段越多越好,而是需要“精准模拟真实浏览器环境”。对于一般的静态数据抓取,配置 User-Agent 即可满足要求;对于防盗链与鉴权接口,必须准确补充 Referer 与 Cookie;对于高频爬取,应配合动态更换 User-Agent 策略。
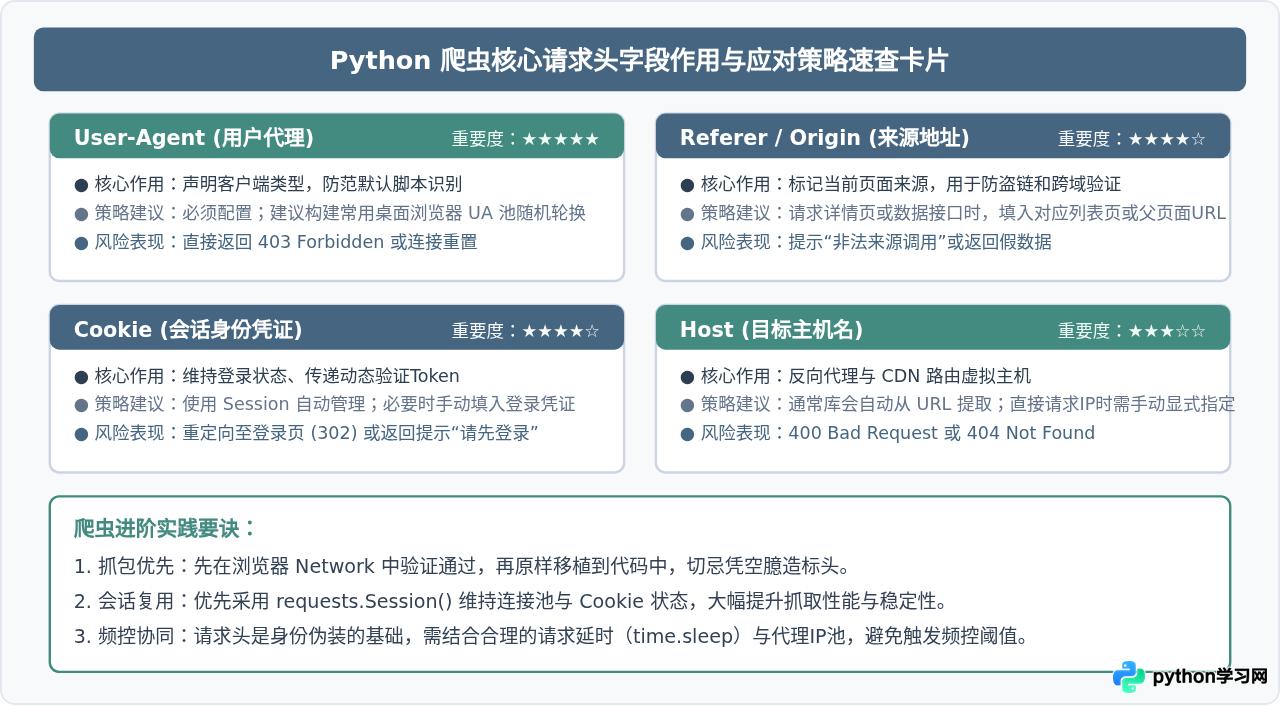
通过本文的讲解与示例,读者应当已经掌握了 HTTP 协议的基础架构、请求报文的核心构成,以及在实际编写 Python 爬虫时如何精准提取并构造请求头。构造规范的请求头是爬虫程序走向健壮、稳定的第一步,后续在此基础上配合解析库(如 BeautifulSoup、lxml)与异步调度,即可从容应对绝大部分常见的数据采集任务。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









