

云原生与AI趋势下,Java和Python的未来竞争力分析
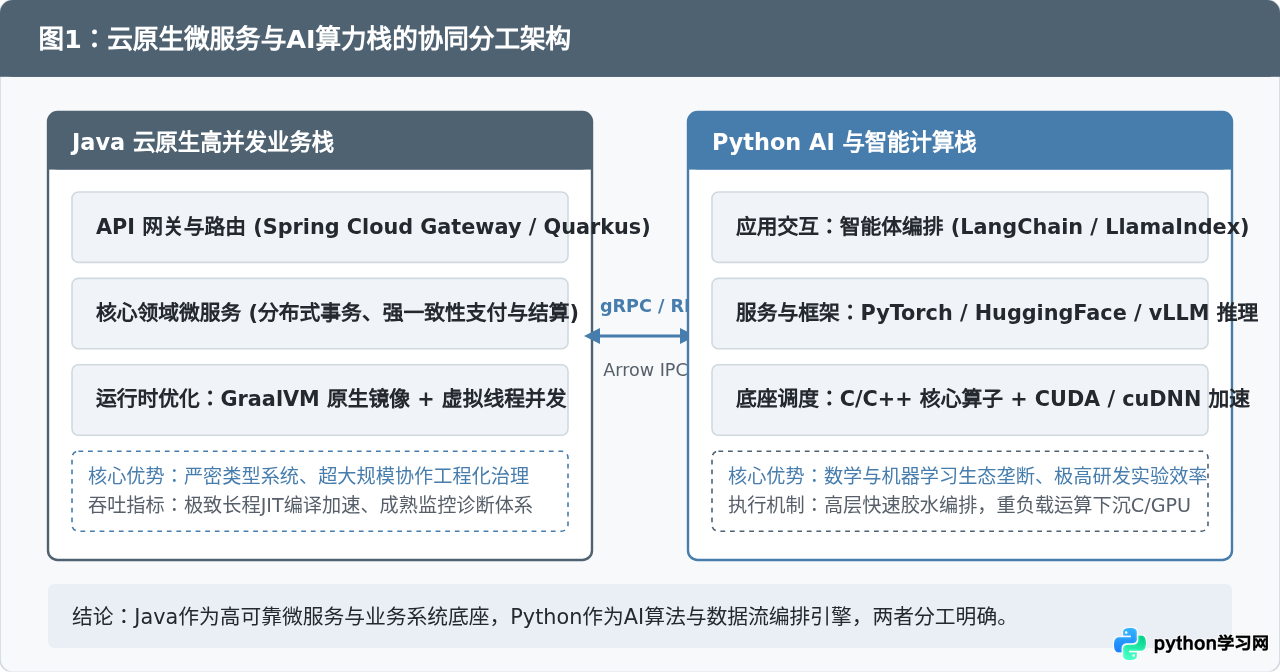
在云原生微服务普及与大语言模型席卷工业界的双重驱动下,关于“Java与Python谁更有未来”的争论频繁出现。核心答案非常明确:两者的竞争并非零和博弈,而是沿着不同的系统边界形成了高度稳固的护城河。Java在云原生时代凭借工程化治理规范、高吞吐能力以及GraalVM原生镜像与虚拟线程的革新,筑牢了企业级高并发系统与交易底座;Python则凭借无可匹敌的算法开源生态、极简胶水整合能力与底层C/CUDA算子调度优势,完全主导了AI模型研发与智能体编排。未来的技术格局不是一方淘汰另一方,而是Java负责高并发确定性业务执行、Python负责探索性智能编排的长期共存融合。
双轮驱动下的技术现实:云原生与AI对语言特性的重塑
现代系统基础设施发生了根本变化。在云原生环境下,容器化、弹性伸缩与Serverless对程序的冷启动时延、内存基线占用(Footprint)以及水平扩展效率提出了严苛要求;而AI技术栈则要求开发语言具备极高的算法原型迭代速度、丰富的张量运算生态,以及与底层异构算力(GPU、NPU、TPU)无缝协同的能力。
这种现实直接重塑了两门语言的竞合格局。传统的Java因为重量级的Java虚拟机(JVM)预热开销,在微型容器冷启动时受到挑战;但其卓越的长程JIT优化与内存管理,在大规模分布式系统中依然具有极高的单节点吞吐收益。Python受限于全局解释器锁(GIL)和动态解释机制,单核计算性能较弱,但其极佳的C/C++扩展接口,让它成为了调度C++底层计算库和CUDA算子的天然粘合剂。
Java在云原生底座中的核心护城河与技术演进
在企业级核心系统中,稳定性、吞吐量和维护成本是第一考量指标。Java多年来沉淀的静态强类型系统、强大的生态系统(如Spring Boot、Micronaut、Quarkus)以及成熟的APM全链路监控体系,使得百人以上工程团队在维护百万行级代码时仍能保持低缺陷率。
1. 痛点突围:GraalVM AOT原生镜像
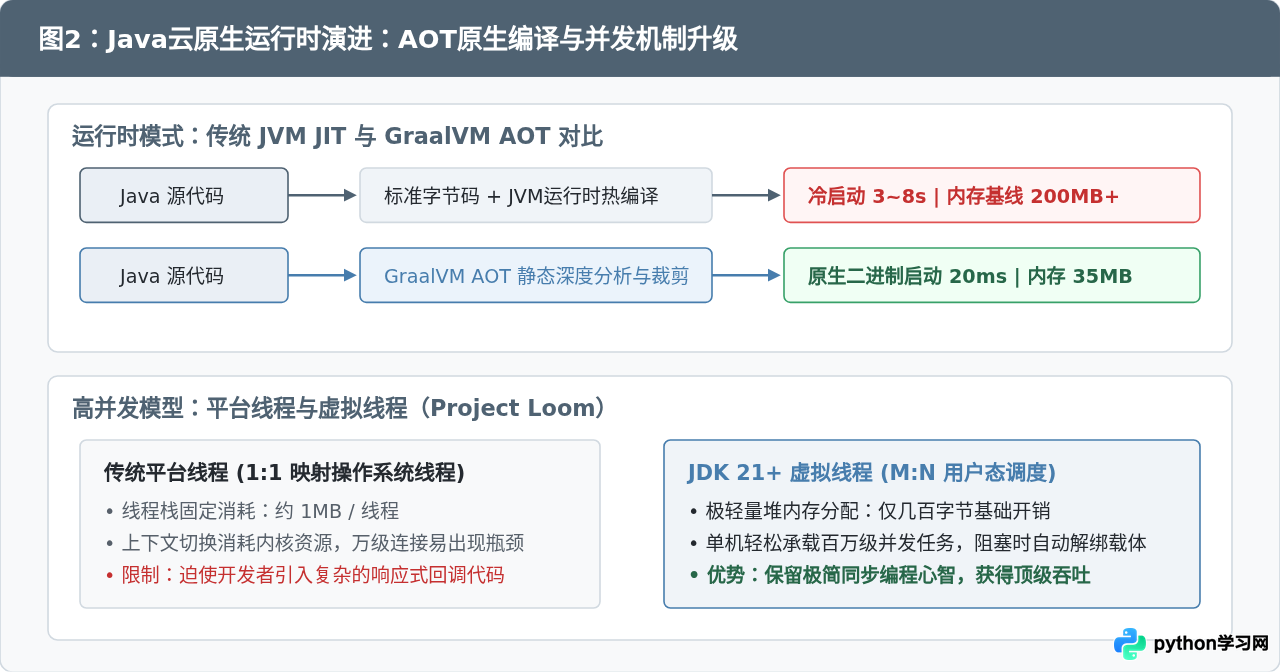
传统JVM采用即时编译(JIT),需要在运行时逐步分析热点代码并进行机器码转换。这种方式在长时间运行的大型服务中吞吐极高,但在Kubernetes容器编排中,冷启动可能长达数秒甚至十数秒,常驻内存基线通常在200MB以上。GraalVM的提前编译(AOT)技术将Java字节码直接构建为宿主机原生二进制程序,消除了JVM启动耗时:
- 启动延迟降低95%以上:从传统JVM的3~8秒缩减至15~40毫秒以内,使得Java完全具备了作为Serverless无服务器函数快速拉起的能力。
- 内存驻留降低75%:原生镜像去除了动态编译器的内存占用,初始内存常驻缩减到30MB左右,极大提升了容器部署密度。
2. 并发革新:Project Loom虚拟线程
在JDK 21正式落地的虚拟线程(Virtual Threads)彻底解决了Java多年来在高并发IO密集场景下的痛点。以往Java的线程直接与操作系统内核线程1:1绑定,一个线程占用约1MB栈内存,单机承载数千连接即面临内存枯竭与上下文切换代价。虚拟线程由JVM内部调度,在极小内存开销下允许创建百万级并发任务,保持简单直观的同步阻塞代码风格,同时具备反应式编程(Reactive)的高并发性能。
Python在AI浪潮中的绝对生态垄断与短板突破
如果说Java是严谨的“重工业工程结构”,那么Python则是AI时代事实上的“万能通用控制语言”。几乎所有主流AI突破性工作(从Transformers架构、PyTorch框架到vLLM高吞吐推理系统)首选且必须支持的第一语言都是Python。
1. 胶水语言与算力下沉的完美契合
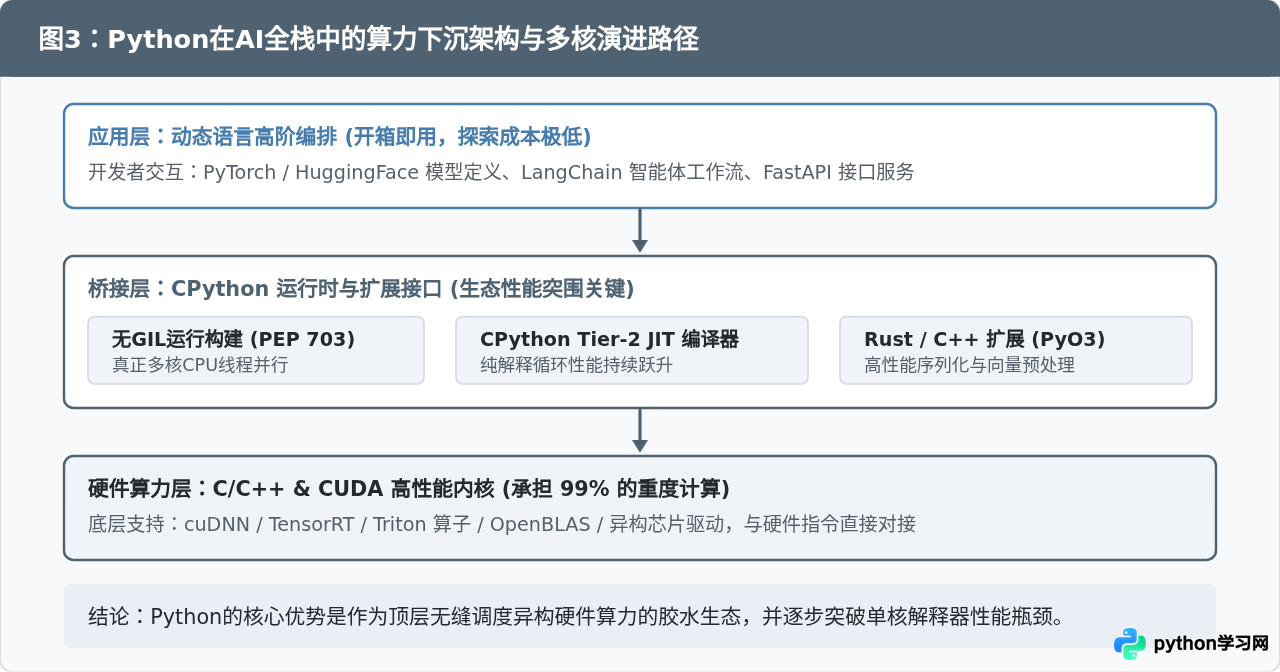
AI开发本质上分为两层:上层的探索性实验与工作流编排,以及底层的张量高密度浮点计算。Python通过C-API将密集计算完全委托给C/C++、Fortran或CUDA编写的高性能动态库。上层算法研究员通过Python简洁直观的语法构建计算图,下层GPU硬件以矩阵硬件指令(Tensor Core)全速运转。这种“高层极其敏捷、底层极致速度”的二元架构,正是Python在AI领域不可撼动的核心竞争力。
2. 解释器短板与官方性能攻坚
Python长期以来在服务端面临GIL限制和动态解释慢的挑战,在面对复杂高频数据清洗或纯Python逻辑处理时常显乏力。为解决这一瓶颈,社区与官方正加速落地关键改进:
- 无GIL Python(PEP 703):在CPython 3.13及后续版本中逐步引入可选的自由线程构建(Free-threaded CPython),允许真正的多核并行运行Python字节码,无需依赖多进程或跨进程IPC。
- 专业化自适应解释器与JIT:Python 3.11起启动的“Faster CPython”计划,使得纯解释执行性能提升30%~50%,并在后续版本试验轻量JIT编译器。
- 生态编译加速方案:Numba、Cython、Taichi等即时编译工具,以及Rust生态(如PyO3、Polars)的深度融合,让Python可以按需将局部热点逻辑编译为机器指令。
架构决策指南:业务场景下的技术选型判断步骤
在面对具体的业务系统时,架构师不应根据语言偏好做决定,而应依据业务指标与计算模型按步骤评估。以下是具体的选型判断操作流程:
-
第一步:识别核心业务的计算属性与数据特征
若业务逻辑主要是基于关系型数据库或分布式KV存储的高频CRUD、强一致性资金账本、严密风控判定规则或海量RPC网关路由,属于典型的IO密集且要求低GC停顿与严密类型检查,应首选 Java 微服务技术栈。若业务涉及海量特征工程处理、模型前向推理编排、检索增强生成(RAG)管道或实验性数据流清洗,应首选 Python。
-
第二步:评估团队工程规模与维护生命周期
对于计划维持3年以上、研发人员超过50人且人员流动性较高的核心主线系统,Java的静态强类型和严密设计模式可大幅降低代码重构灾难;而对于需要2周内快速验证商业假设、小团队敏捷开发或AI前沿算法实验的项目,Python能提供高出数倍的原型构建速度。
-
第三步:评估服务交付与弹性伸缩边界
对于常驻云原生集群、长时间运行的大规模工作负载,Java在经过JIT热优化后的吞吐率极其优秀;而如果需要超轻量Serverless事件驱动处理,采用GraalVM编译的Java或直接采用轻量Python函数计算服务是更合理的解法。
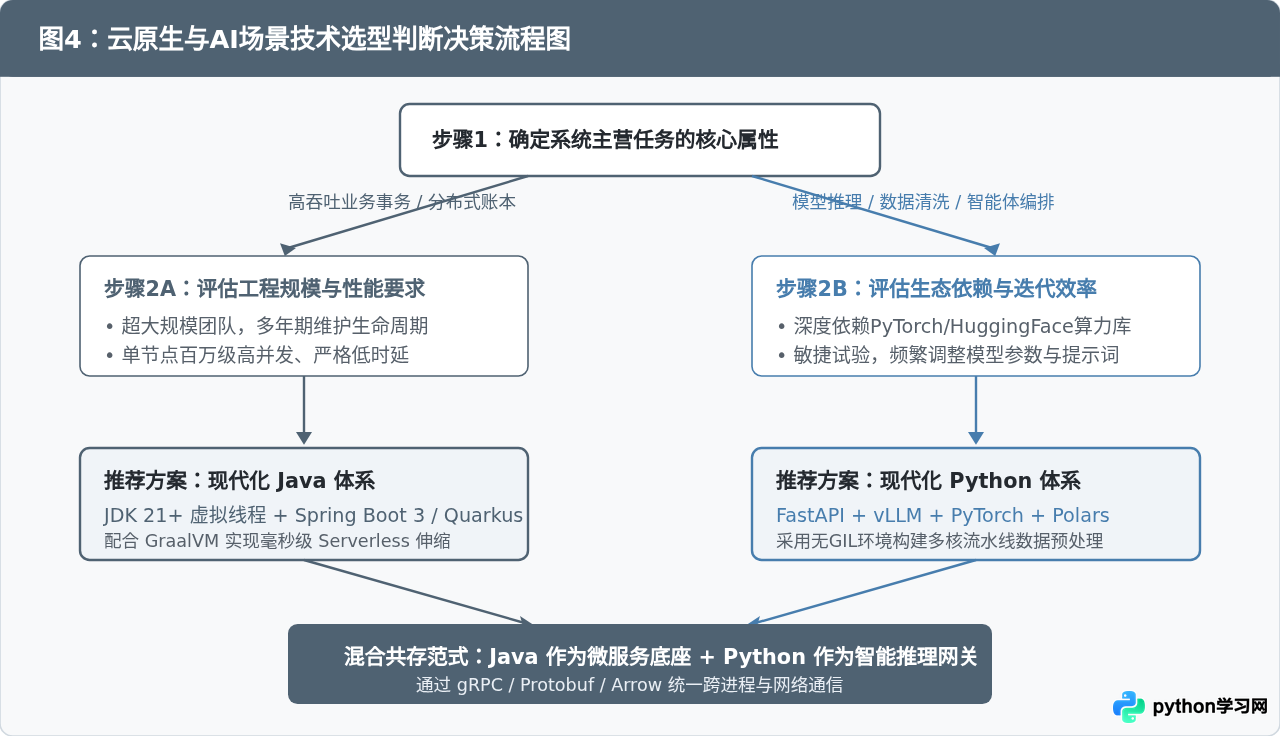
多维竞争力对比与未来五年融合范式
为了给技术选型提供直观的量化参考,我们将两门语言在现代化云原生与AI生产环境中的关键指标总结如下:
| 评估维度 | Java (JDK 21+ / GraalVM) | Python (3.12+ / 现代AI栈) | 选型建议与落地权衡 |
|---|---|---|---|
| 云原生与Serverless适用性 | 极高(经AOT构建后启动在40ms内,常规JVM吞吐领先) | 高(启动速度快,轻量函数部署便捷) | 若单节点并发连接极高,Java虚拟线程优势明显;若按函数触发且调用轻量,两者均可。 |
| AI与深度学习生态 | 中等(有DJL、LangChain4j等桥接库,但主流模型非原生首发) | 绝对垄断(PyTorch、Transformers、vLLM等核心生态首发) | 算法训练、模型微调与复杂智能体构建必须依赖Python生态。 |
| 高并发与运行时吞吐 | 顶级(成熟JIT长程优化、分代GC与虚拟线程调度) | 受限(单核性能受GIL与动态类型限制,依赖扩展库下沉) | 交易流水线、网关核心与账本服务选Java;纯算子调用交给底层GPU加速。 |
| 大规模工程化治理 | 极强(静态编译期检查、标准接口约束、模块化工具链完善) | 中等(依靠Type Hints、Ruff、Mypy辅助,动态类型重构风险较高) | 团队规模达数十人以上且代码库庞大时,Java能大幅抑制维护熵增。 |
| 原型研发与探索速度 | 中等(需要严格的工程结构、类定义与依赖组织) | 极高(即写即验,交互式Notebook与极简脚本开发) | 新产品商业逻辑探索、数据分析与算法验证,Python具有无可比拟的速度。 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









