

Python读取CSV文件时根据条件筛选特定数据

在日常数据清洗与业务开发中,从CSV文件中按条件过滤出目标记录是一项基础而频繁的任务。解决这一需求主要有两条清晰的路径:对于不需要外部第三方库、内存敏感或数据规模较小的轻量级场景,可直接使用Python内置的csv模块;而对于结构复杂、数据量大或需要复杂多条件运算的场景,则推荐使用性能更优且语义精炼的pandas库。本文将围绕这两个核心工具,详尽演示从基础文件读取到单条件、多条件与区间筛选的具体操作步骤及注意事项。
一、准备演示数据
为了保证所有示例具备一致的可运行性,我们预设一个名为employees.csv的数据文件。该文件包含员工的基本信息,内容结构如下:
id,name,department,age,salary
1,张伟,技术部,28,12000
2,李娜,市场部,34,9500
3,王强,技术部,31,16000
4,赵敏,运营部,25,8000
5,刘洋,市场部,29,11000
6,陈杰,技术部,42,23000
二、核心处理流程解析
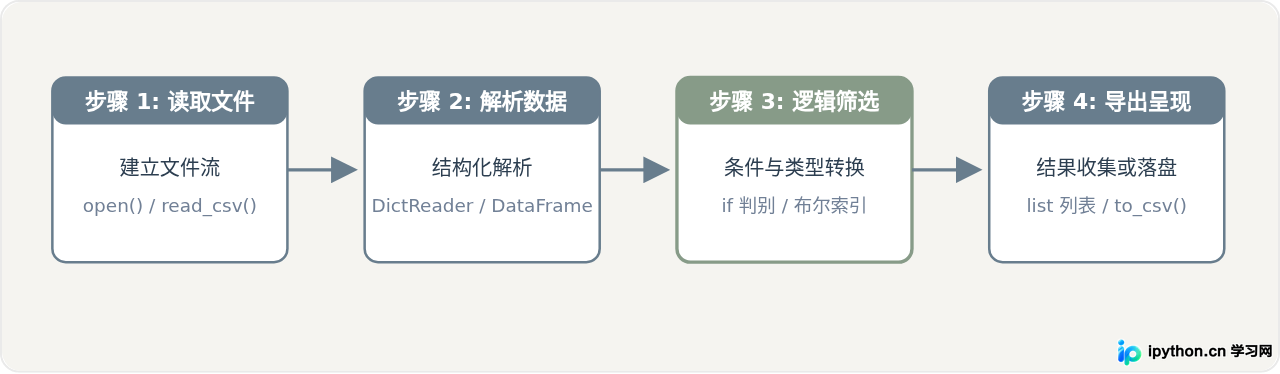
无论是使用内置模块还是数据分析库,CSV条件筛选的核心逻辑均包含四个固定阶段:建立数据流连接、逐行或批量解析、应用布尔判断条件,以及输出存储筛选结果。
三、方法一:使用内置csv模块筛选数据
Python标准库自带的csv模块无需安装任何外部依赖。其中,csv.DictReader将每一行解析为Python字典,列名直接作为键,代码可读性极高。
1. 单条件筛选:查找指定部门员工
以下示例演示如何筛选出所有归属于“技术部”的员工。关键点在于使用with open安全管理文件上下文,并在循环中添加条件分支:
import csv

filtered_records = []
file_path = "employees.csv"

with open(file_path, mode="r", encoding="utf-8") as file:
    reader = csv.DictReader(file)
    for row in reader:
        # 字符串完全匹配筛选
        if row["department"] == "技术部":
            filtered_records.append(row)

# 打印筛选结果(示例输出)
for item in filtered_records:
print(f"ID: {item['id']}, 姓名: {item['name']}, 工资: {item['salary']}")csv.reader和csv.DictReader读取出的所有单元格数据默认都是字符串类型(str)。若进行数字大小比较,必须显式转换为int或float。
2. 多条件筛选:数值范围与逻辑组合
当需要同时满足“技术部”且“薪资大于15000”时,需要使用and关键字,并对数值列进行类型转换:
import csv

target_rows = []
with open("employees.csv", mode="r", encoding="utf-8") as file:
    reader = csv.DictReader(file)
    for row in reader:
        salary_val = float(row["salary"])
        # 多条件联合判定:部门匹配且薪资大于15000
        if row["department"] == "技术部" and salary_val > 15000:
            target_rows.append(row)

print("符合高薪技术人员条件的人数:", len(target_rows))
四、方法二:使用pandas库高效筛选
如果数据文件规模达到数万行以上,或者涉及复杂的矩阵化筛选,pandas库凭借底层C语言优化和布尔索引机制,能够提供更高的执行效率和更为简洁的语法。
1. 布尔索引单条件与多条件筛选
使用pandas.read_csv()读取数据后,通过布尔序列(Boolean Series)进行数据切片。在组合多个条件时,使用&(与)和|(或),且每个独立条件必须用圆括号包裹:
import pandas as pd

# 读取CSV文件
df = pd.read_csv("employees.csv")

# 条件一:单条件筛选(市场部)
marketing_df = df[df["department"] == "市场部"]

# 条件二:多条件筛选(技术部 且 年龄大于30岁)
tech_senior_df = df[(df["department"] == "技术部") & (df["age"] > 30)]

# 输出筛选后的结果预览
print(tech_senior_df)
2. 利用query()方法提供更自然的表达式
DataFrame.query()方法支持直接传入类似于SQL语法的字符串条件,在逻辑链条较长时能显著减少方括号与变量名的冗余:
import pandas as pd

df = pd.read_csv("employees.csv")

# 使用query进行区间与类别组合筛选
result = df.query('department == "技术部" and salary >= 12000 and age < 40')
print(result)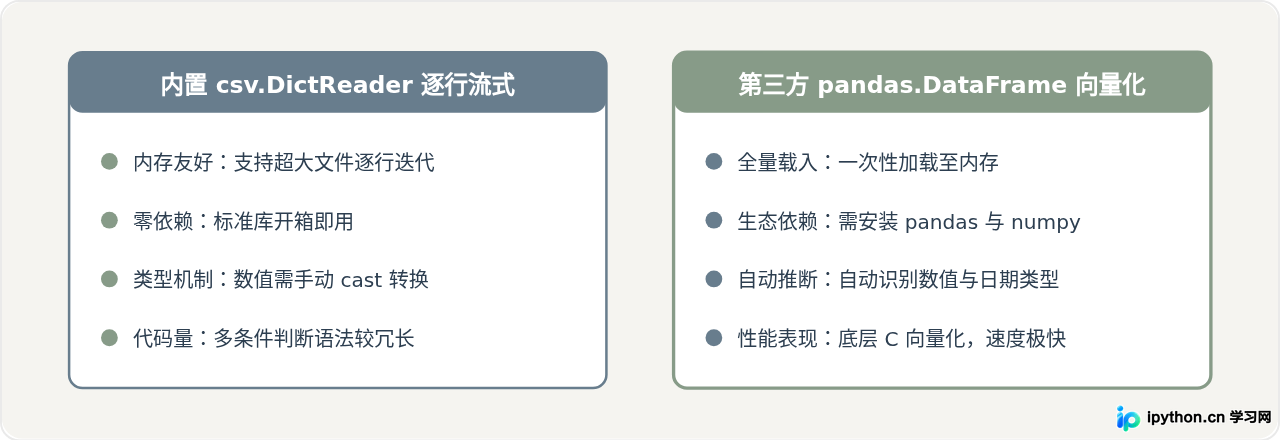
五、筛选逻辑与运算符细节
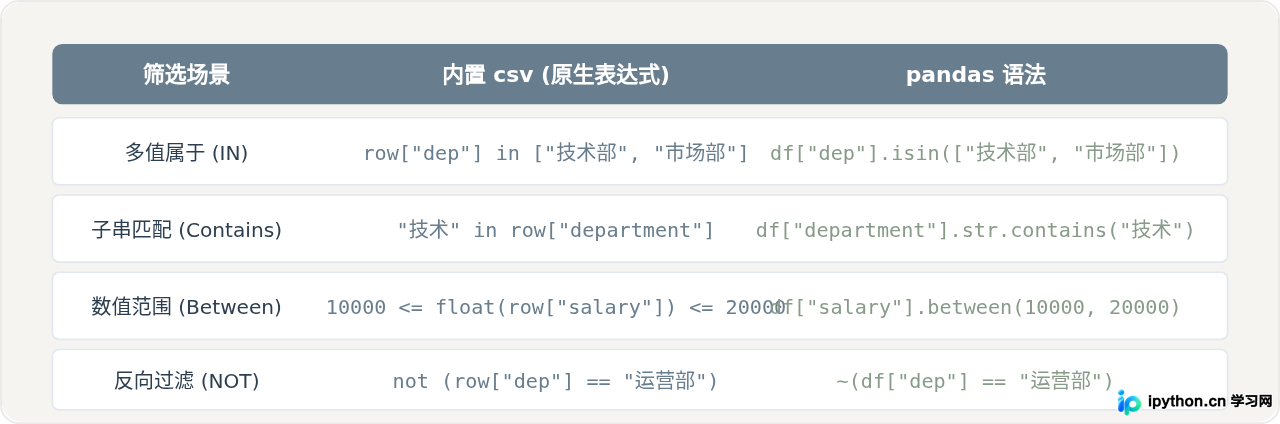
在实际业务中,筛选条件不仅限于相等的精确比对,往往还涵盖包含关系(子串匹配)、成员归属(IN判断)以及空值剔除。掌握不同场景下的匹配算子是编写稳健筛选脚本的关键。
六、实践中的关键注意事项
- 文件编码问题:在国内Windows环境下导出的CSV文件常常采用
GBK或ANSI编码,而Linux/macOS或现代应用则普遍采用UTF-8或UTF-8-SIG(带有BOM头)。读取时若出现UnicodeDecodeError,应在open()或read_csv()中明确指定encoding="utf-8-sig"或encoding="gbk"。 - 缺失值(NaN / 空串)防范:原生
csv中空字段表现为空字符串"",直接转换float("")会抛出ValueError,需要增加row["salary"] != ""校验;而pandas会将空单元格转为NaN,数值比对时遵循IEEE浮点标准(与NaN比较一律返回False),可使用dropna()先行清理。 - 内存消耗权衡:处理体量在GB级别以上的海量CSV时,
pd.read_csv()一次性载入可能导致内存耗尽(OOM)。此时既可以采用csv.reader流式读取,也可以通过pd.read_csv(..., chunksize=10000)分块读取并迭代筛选。
七、决策与总结
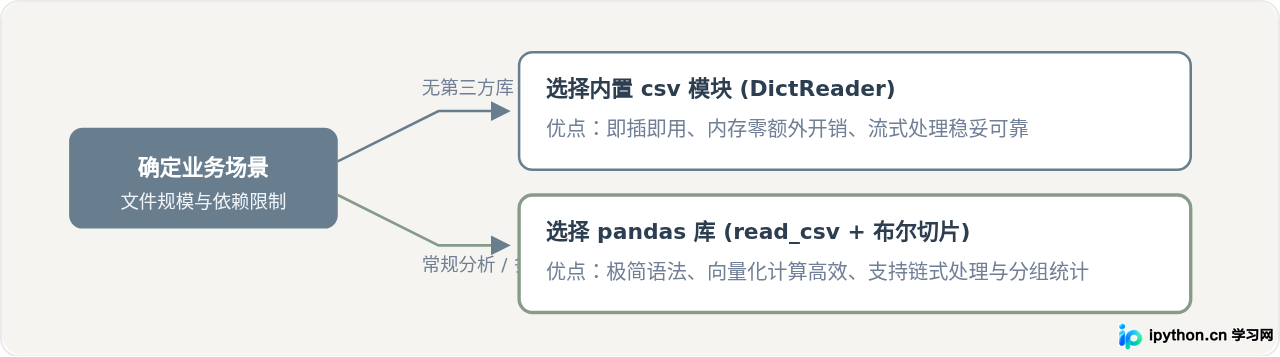
在面对“Python读取CSV文件时根据条件筛选特定数据”的任务时,选择合适的技术手段能够显著提升开发效率与运行稳定性。建议根据文件规模与现有环境依赖进行取舍:
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









