

Tesseract与PaddleOCR:Python图片转Excel库的效果对比

把图片中的表格转换为 Excel 电子表格,核心难点在于同时解决“字符识别(OCR)”与“表格拓扑结构重建(单元格行列关系与合并状态)”。在 Python 生态中,PaddleOCR 依托 PP-Structure 表格分析套件提供了端到端的结构化提取能力,在中文识别与复杂表格还原上优势明显;而 Tesseract 本质是纯文本与字符级边框识别引擎,若要生成完整的 Excel 文件,必须额外编写大量图像形态学检测和空间坐标聚类算法,工程门槛与维护成本均显著高于 PaddleOCR。
一、核心技术挑战:OCR 不等于“转 Excel”
许多初次接触该任务的开发者容易将“图片转 Excel”简单理解为调用 OCR 读取文字。然而,纯文本 OCR 输出的仅仅是离散的文字内容及其外接矩形坐标(Bounding Box)。要真正生成可在 Microsoft Excel 或 WPS 中正常编辑、计算的 .xlsx 文件,程序必须建立一个二维拓扑网格,准确判定文字到底隶属于哪一行、哪一列,以及是否存在跨行跨列合并单元格。
因此,评价一个工具或方案的优劣,不仅要看文本字符识别率,更关键在于表格结构的还原准确度。以下为 Tesseract 与 PaddleOCR 在面对图片转 Excel 任务时的根本机制差异:
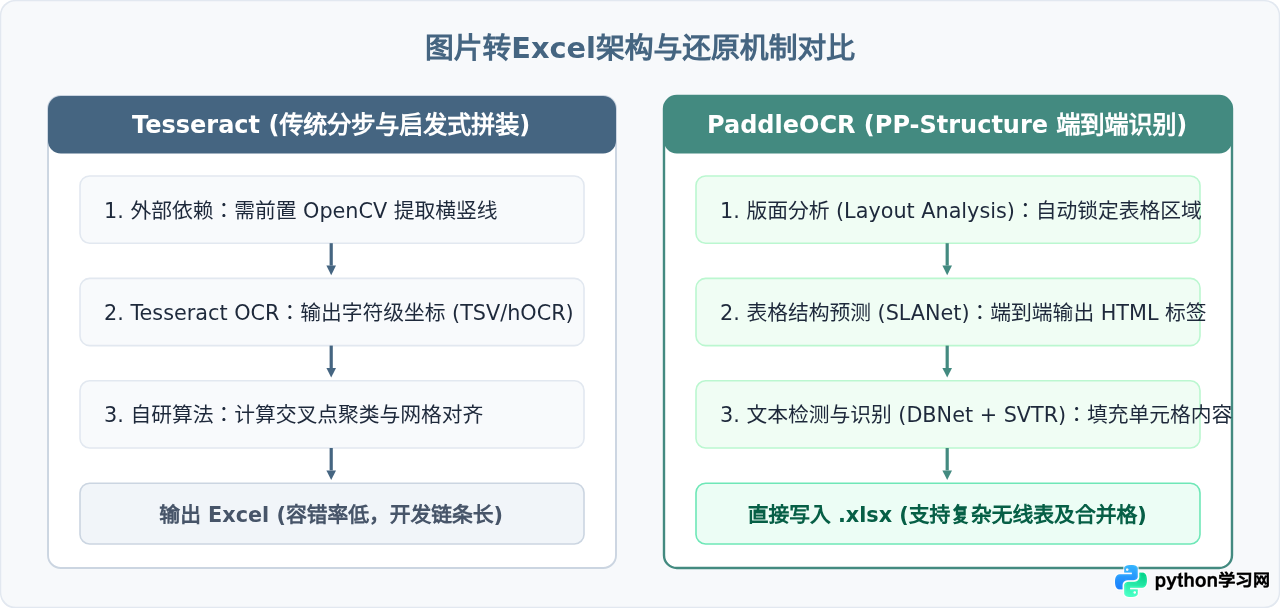
二、关键指标与特性横向对比
为了让选择依据更加直观,我们将影响生产环境使用的核心指标总结如下表:
| 评估维度 | Tesseract (配合 pytesseract) | PaddleOCR (结合 PP-Structure) |
|---|---|---|
| 原生表格支持 | 无。仅输出文本、行号与外接坐标框(TSV/hOCR)。 | 内置 PP-Structure 表格分析模块,原生直接导出 Excel。 |
| 中文识别准确率 | 中等偏低。chi_sim 字库对生僻字、特定字体容易漏字与乱码。 | 极高。针对多场景中文数据集深度训练,鲁棒性很强。 |
| 无线表格识别能力 | 极弱。无法依赖物理线条切分,文本坐标聚类容易错行错列。 | 优秀。基于注意力与序列模型预测拓扑,无需显式边框线。 |
| 合并单元格还原 | 需编写复杂的几何面积重叠判断逻辑,极易误判。 | 支持预测 colspan 与 rowspan 属性,直接还原跨度。 |
| 环境与依赖复杂度 | 轻量。依赖系统 C++ 二进制包,Python 仅需轻量封装包。 | 重量。依赖 PaddlePaddle 深度学习框架,依赖体积在几百 MB 至数 GB。 |
| 硬件加速支持 | 主要依赖 CPU,多线程并发占用较低。 | 全面支持 CPU (ONNX / OpenVINO) 与 GPU (CUDA) 加速推理。 |
三、典型应用场景效果剖析
在实际业务中,表格的形态多种多样。我们针对两种最典型的情况进行具体效果剖析:
1. 标准有线表格(全框线报表、税务发票)
在所有单元格均有清晰连续黑线封闭的标准表格中,Tesseract 搭配 OpenCV 形态学操作(提取水平核与垂直核计算交点)可以达到及格水平。但只要表格线出现轻微断裂、虚线、或者打印淡化,OpenCV 的轮廓检测就会失效,导致邻近单元格被错误合并。
PaddleOCR 则无需强行依赖物理边框的绝对连通性。其语义分割网络会结合文字分布与版面空白进行联合判断,即使局部线条模糊或断裂,也能正确还原表格矩阵。
2. 无线表格与三线表(财务摘要、学术论文表)
对于只在表头和表尾有水平线、中间数据全靠空格自然对齐的“无线表格”,两者的差距最为悬殊:
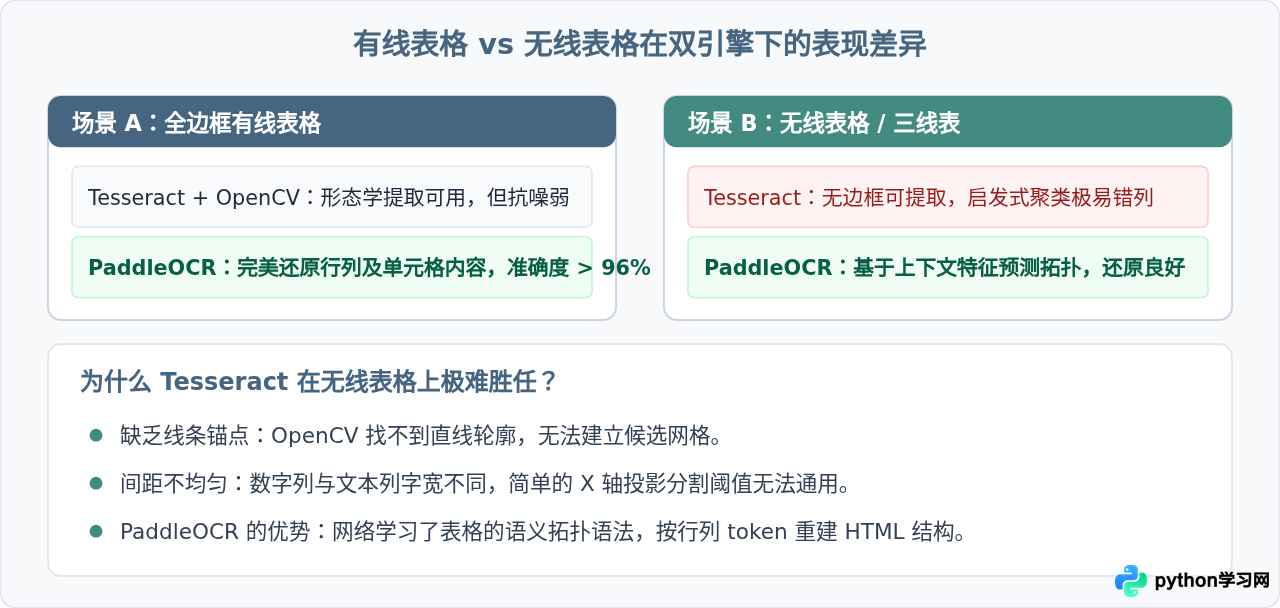
四、完整工程代码与实现路径
为便于读者根据业务实际快速验证,下面给出两者的标准实现示例与操作说明。
1. PaddleOCR (PP-Structure) 的标准导出流程
PaddleOCR 官方提供了高度集成的表格识别接口。安装 paddleocr 与图像处理依赖后,只需几行代码即可将图片中的表格识别为 HTML 并直接输出 Excel:
# 环境准备命令:
# pip install paddlepaddle paddleocr openpyxl

import os
import cv2
from paddleocr import PPStructure, save_structure_res

# 初始化表格分析器:table=True 开启表格识别,ocr=True 开启文本识别
table_engine = PPStructure(show_log=True, image_orientation=True)

image_path = "invoice_sample.png"
output_dir = "./output_excel"
os.makedirs(output_dir, exist_ok=True)

img = cv2.imread(image_path)
result = table_engine(img)

# 将结构化结果保存为 Excel 文件
save_structure_res(result, output_dir, os.path.basename(image_path).split('.')[0])

for region in result:
    if region['type'] == 'table':
        # 获取还原出的 HTML 表格字符串与对应的 Excel
        print("提取到表格HTML结构:")
        print(region['res']['html'])
运行后,PaddleOCR 会在 output_dir 中自动生成与图片同名的 .xlsx 文件,表格的边框、单元格合并状态均已预设完毕,开箱即用度极高。
2. Tesseract + OpenCV 的传统拼装流程
使用 Tesseract 转换表格时,由于其无法直接输出 Excel,必须先用 OpenCV 定位横竖线,提取单元格 ROI,再逐个单元格运行 Tesseract 识别字符:
# 传统方案思路示例 (需安装 tesseract-ocr 系统二进制包与 pytesseract)
import cv2
import pytesseract
import pandas as pd
import numpy as np

def extract_table_cells(img_path):
    img = cv2.imread(img_path, cv2.IMREAD_GRAYSCALE)
    _, binary = cv2.threshold(img, 200, 255, cv2.THRESH_BINARY_INV)

    # 提取横线与竖线形态学结构元
    h_kernel = cv2.getStructuringElement(cv2.MORPH_RECT, (40, 1))
    v_kernel = cv2.getStructuringElement(cv2.MORPH_RECT, (1, 30))

    table_h = cv2.morphologyEx(binary, cv2.MORPH_OPEN, h_kernel)
    table_v = cv2.morphologyEx(binary, cv2.MORPH_OPEN, v_kernel)
    table_grid = table_h + table_v

    # 查找交点与外接矩形 (省略数十行边界聚类与排序逻辑)
    contours, _ = cv2.findContours(table_grid, cv2.RETR_TREE, cv2.CHAIN_APPROX_SIMPLE)

    # 对定位出的每个小网格调用 pytesseract 提取字符
    # 随后拼装为二维矩阵并用 pandas 导出:
    # df = pd.DataFrame(data_matrix)
    # df.to_excel("tesseract_result.xlsx", index=False)
    return "逻辑链条长,对拍摄角度倾斜或无框线完全无解"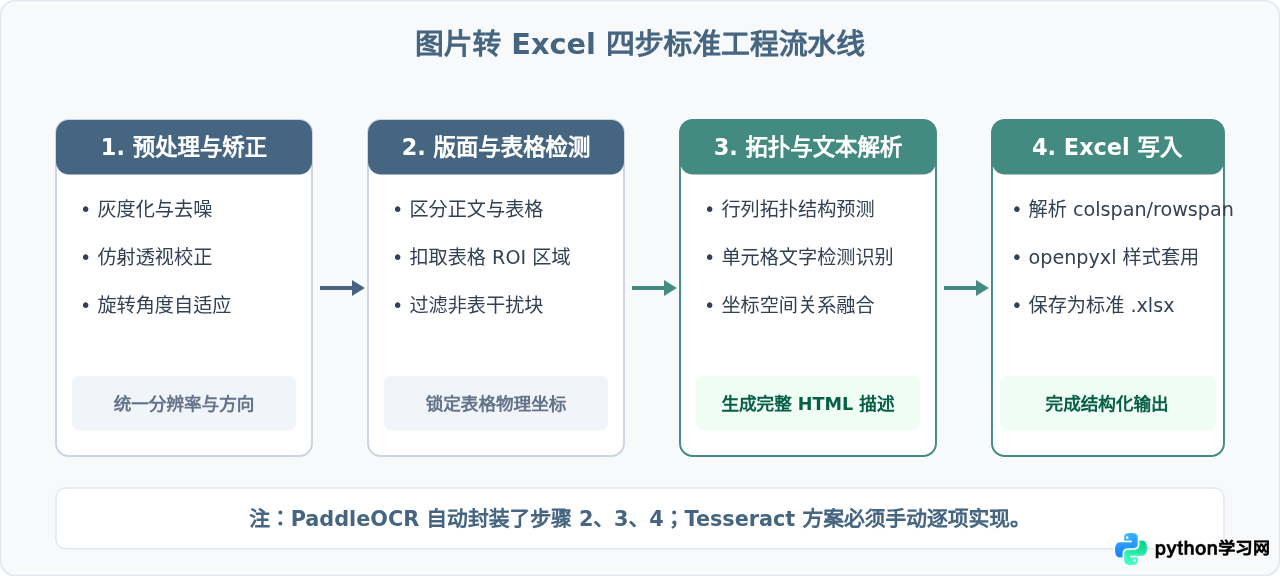
五、选型建议与落地权衡
虽然 PaddleOCR 在功能与效果上呈现压倒性优势,但具体选型仍需结合开发环境的资源限制进行权衡:
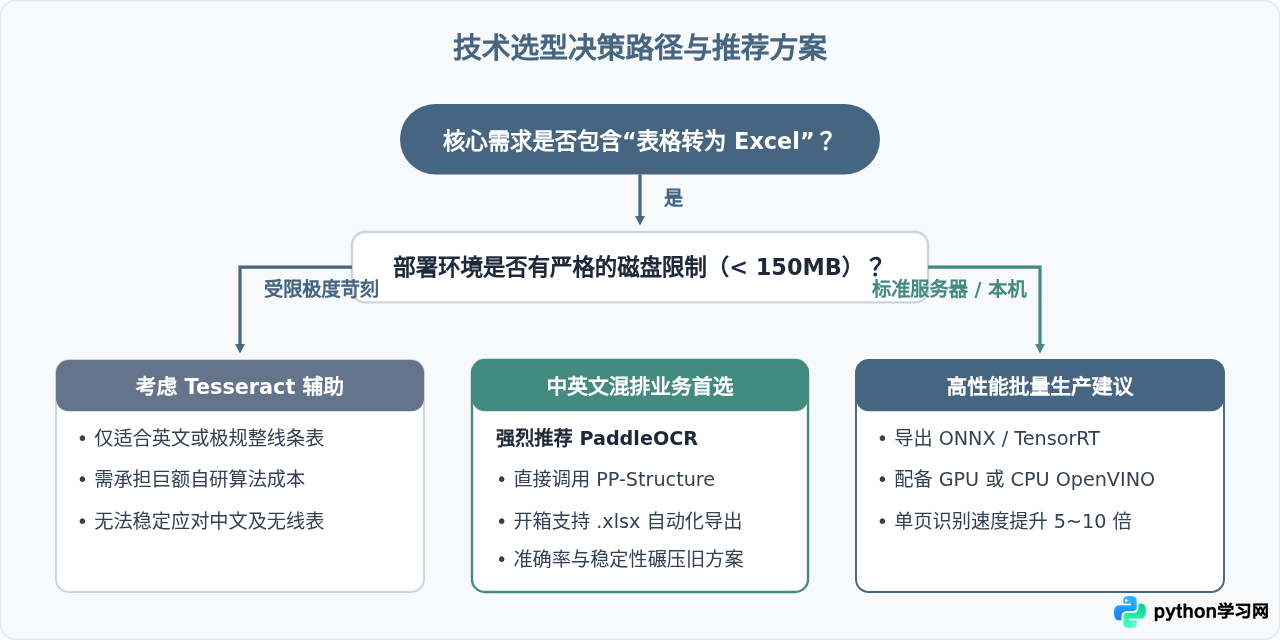
如果在项目中需要将含有中文、无线表、跨行合并或扫描票据的图片转化为标准 Excel 文件,请毫不犹豫地选择 PaddleOCR(PP-Structure)。只有在运行环境处于极端嵌入式平台、对安装包体积有苛刻硬限制,且图片均为印刷体英文标准有线表格的罕见场景下,才考虑使用 Tesseract 结合定制 OpenCV 规则实现。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









