

Python中大量字符串拼接的性能优化:join vs +=

+= 操作符在循环中累加会导致执行效率显著下降,甚至引发性能瓶颈;而改用 str.join() 能够将时间复杂度稳定在 O(N)。本文将从 Python 对象的底层内存分配机制出发,解析这一现象的成因,剖析 CPython 的优化边界,并给出工业级场景下的标准选型方案。
一、问题的本质:不可变对象与循环累加的二次方开销
在 Python 语言设计中,字符串(str 对象)是完全不可变(immutable)的。这意味着一旦一个字符串在内存中被创建,它的字符序列与长度就固定不变,开发者无法在原地修改其内容。
初学者通常习惯于使用 += 进行迭代拼接,如下所示:
# 常见的低效写法
result = ""
for item in large_data_list:
    result += item
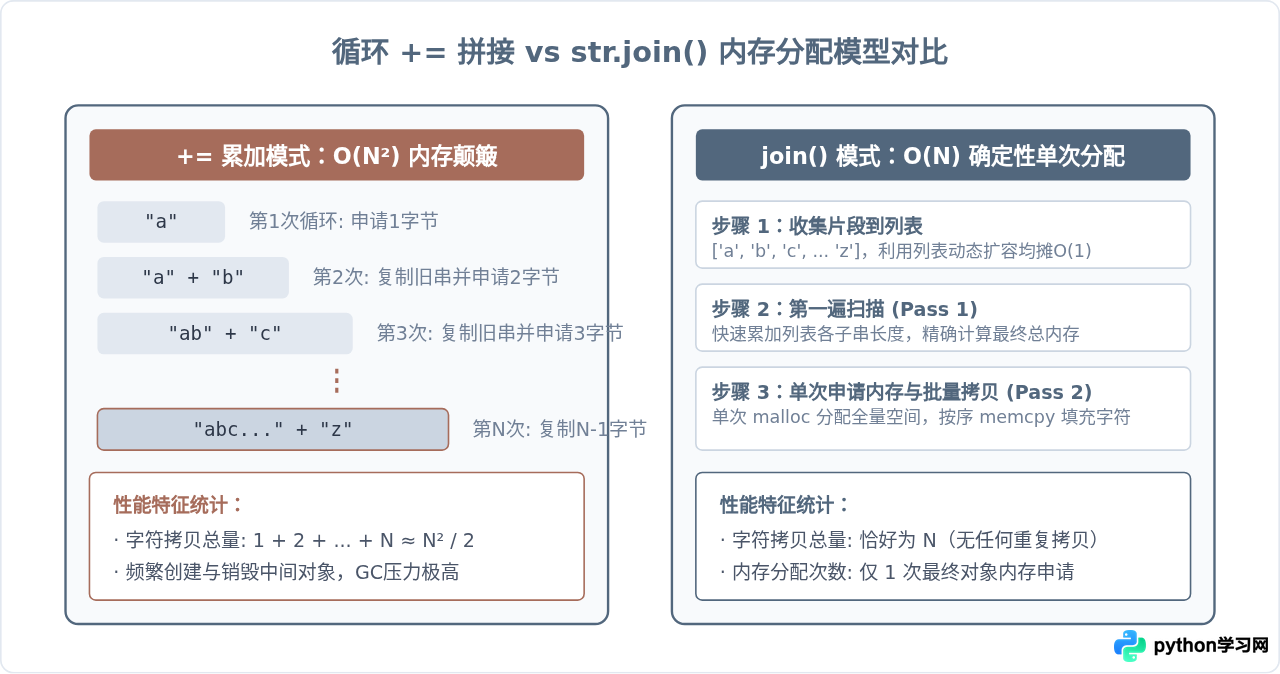
从语义上看,result += item 相当于 result = result + item。每次执行该语句时,Python 通常需要做三件事:
- 向操作系统申请一块全新的连续内存区域,容量刚好容纳
result的当前长度与item的长度之和。 - 将旧
result中的所有字节完整复制到新内存中。 - 将
item的内容复制到新内存的末尾,并将变量result重新指向新对象,旧对象等待垃圾回收。
当循环执行 N 次时,旧字符序列会被反复拷贝:第 1 次复制 1 份数据,第 2 次复制 2 份数据……第 N 次复制 N 份数据。字符拷贝的总量为 1 + 2 + 3 + ... + N ≈ N² / 2,算法的时间复杂度直接退化为 O(N²)。当数据量从 1,000 级上升到 100,000 级时,耗时将从毫秒级暴增至数十秒甚至卡死。
二、str.join() 的底层实现机制:为什么是 O(N)
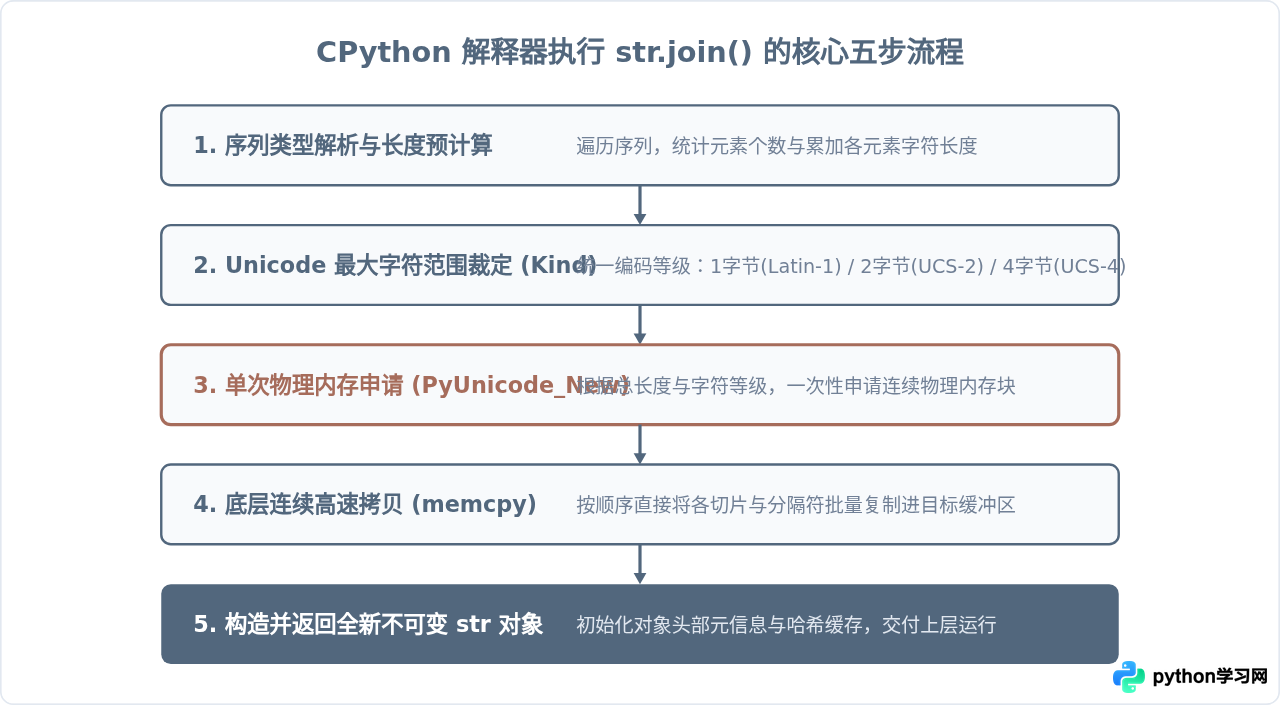
与 += 的被动重新分配不同,str.join() 是 Python 官方针对容器内序列拼接量身定制的内置方法。在 CPython 的底层 C 代码实现中(位于 Objects/unicodeobject.c 中的 PyUnicode_Join 函数),它采用经典的“两遍扫描(Two-pass)”算法:
- 第一遍遍历(预计算):遍历传入的可迭代对象,读取每个子字符串的字符长度以及包含的字符编码种类(区分 ASCII、Latin-1、UCS-2、UCS-4),并计算出加入分隔符(如逗号或空串)后的精确总字符数与所需字节数。
- 单次内存申请:调用底层
PyUnicode_New(),向操作系统一次性申请足额且连续的内存块。 - 第二遍遍历(批量内存拷贝):直接利用 C 标准库的高速内存复制指令(如
memcpy)或优化的字符复制宏,将各个字符串的内容连续拷贝到新缓冲区的相应偏移位置。
由于整个过程中每个字符仅被读取和拷贝了固定次数,没有产生任何废弃的中间字符串对象,因此无论输入规模多大,算法的时间复杂度与空间复杂度都严格保持为 O(N)。
三、CPython 的 += 原地优化机制及其失效边界
有些开发者在实际小规模测试中会发现:在较新版本的 CPython 中,写 s += "x" 耗时并没有理论上那么慢,甚至有时也能跑出接近线性的性能。这是为什么?
这是因为 CPython 解释器引入了一项特定的激进优化——引用计数原地重分配(In-place realloc)。当执行 s += item 时,CPython 会先检查当前左侧变量 s 所指向对象的引用计数(ob_refcnt):
- 如果
ob_refcnt == 1,意味着当前除了变量s之外,没有任何其他地方引用该字符串对象。此时 CPython 会尝试直接调用 C 语言底层的realloc(),试图在当前内存块的后方就地扩容,从而避免开辟新内存和整体复制。 - 如果
ob_refcnt > 1,或者内存管理器后面没有足够的连续空间,这项优化将立即彻底失效,回退到完整的“新申请-全量拷贝-旧对象销毁”流程。
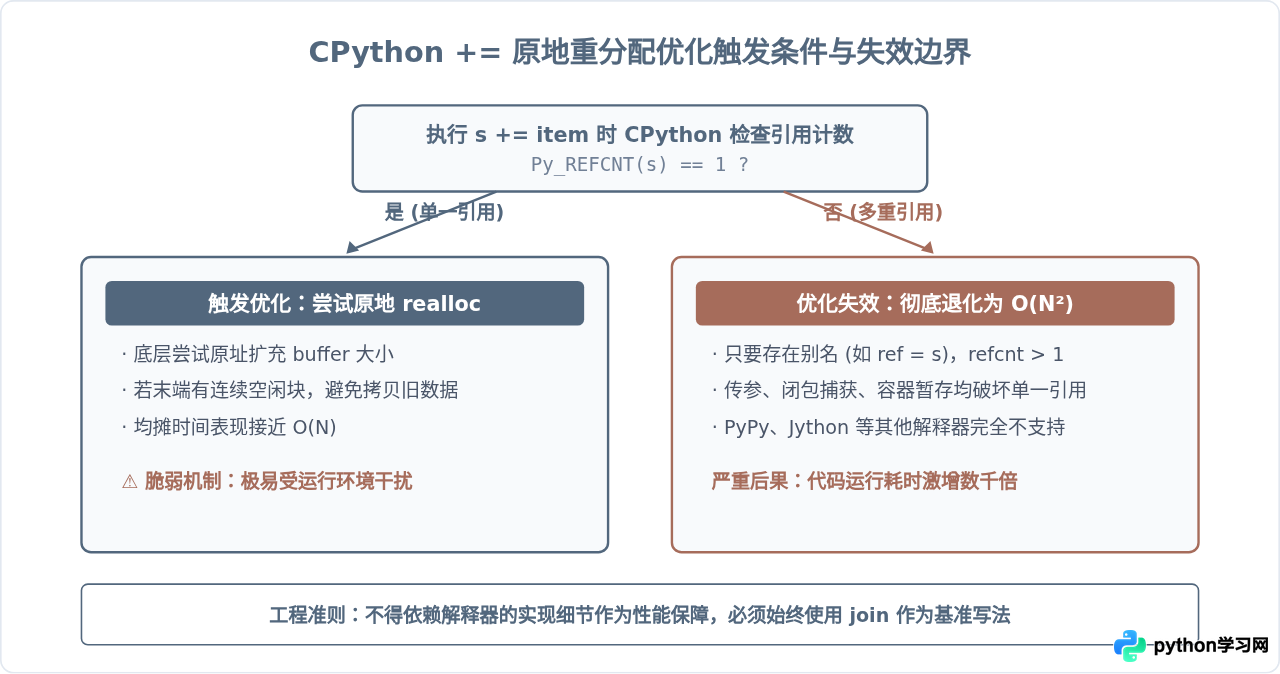
backup = s 或将 s 作为参数传入函数,就会导致其引用计数增加,从而瞬间击穿 CPython 的优化机制。在非 CPython 实现(如 PyPy)中,其行为表现也各不相同。因此,绝不能在生产环境中依赖 += 的隐式优化。
四、不同拼接方式的代码实践与基准对比
针对不同的输入形态,Python 提供了多种规范的字符串拼接途径。以下是最常见的三种写法:
1. 动态生成数据:列表收集后统一 join
当片段在循环中动态生成时,最佳实践是先将各个片段 append 到一个 Python 列表中,循环结束后调用 join() 一次性合并。
# 推荐模式:先用列表收集,再用 join 一次性拼接
chunks = []
for row in query_database():
    formatted_str = format_row(row)
    chunks.append(formatted_str)

final_text = "".join(chunks)
Python 的列表底层是动态数组(类似 C++ 的 std::vector),append() 具备均摊 O(1) 的时间复杂度,内存扩容频率极低。配合最终的 join(),整体时间复杂度完全保持为 O(N)。
2. 转换已知可迭代对象:列表推导式与生成器表达式
# 列表推导式:速度最快(推荐内存充足时使用)
csv_line = ",".join([str(x) for x in data_list])

# 生成器表达式:节约内存(超大集合时使用)
csv_line_gen = ",".join(str(x) for x in stream_data)
需要特别说明的是:在内存允许的情况下,列表推导式通常比生成器表达式更快。因为 str.join() 遇到列表时能直接读取其 ob_size 获取元素总数,预分配效率最高;而遇到纯生成器时,必须边迭代边扩容,内部会增加缓冲开销。
3. 海量流式内容构建:io.StringIO
如果业务场景类似于“写文件”过程,函数调用层级深、需要频繁调用 write(),可以使用标准库提供的 io.StringIO:
import io

buffer = io.StringIO()
for block in generate_blocks():
    buffer.write(block)

result_content = buffer.getvalue()
buffer.close()
五、选型决策指南与优化总结
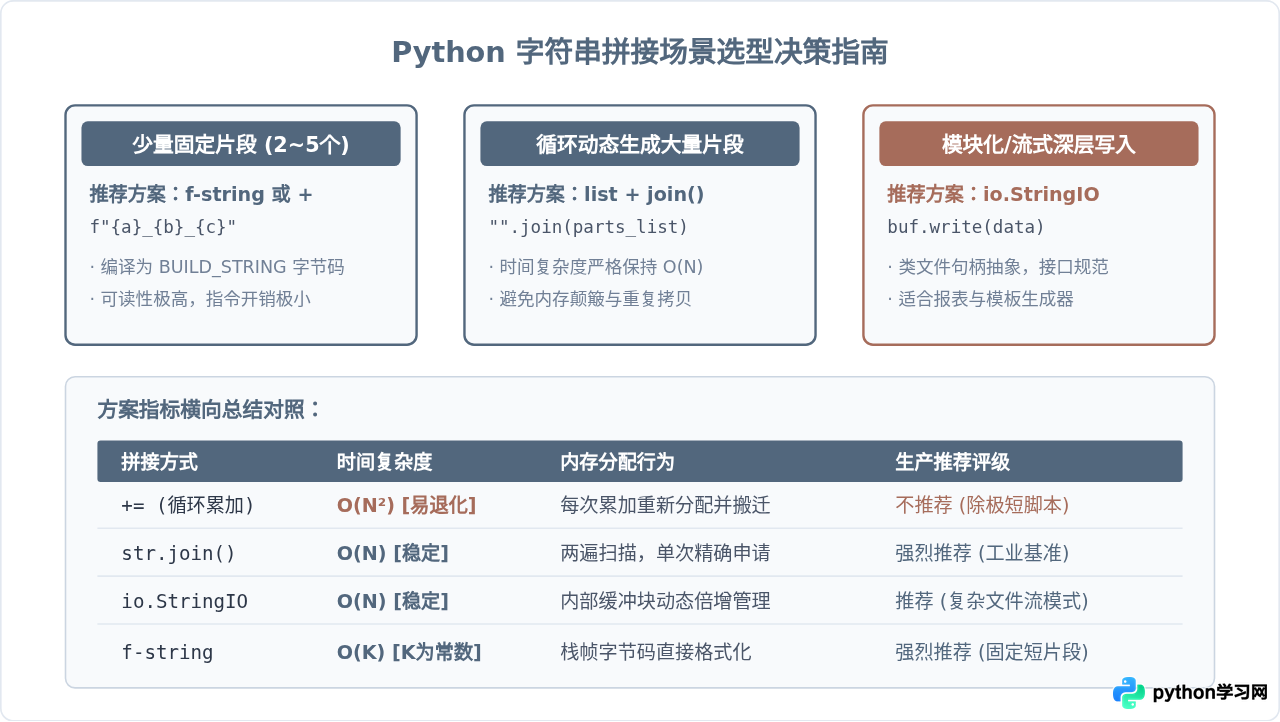
不同场景下应选用匹配的字符串拼接策略,避免“过早优化”或“选型失误”:
- 少量固定数量的字符串(2~5个):首选 f-string(如
f"{first}_{second}_{third}")或普通+操作。此时代码可读性最高,且 Python 在编译期能够将其优化为专用的BUILD_STRING字节码,无须引入列表。 - 循环次数不确定或数据量较大(>100个):必须坚决采用
list.append() + str.join()。 - 超长文本类文件操作:优先采用
io.StringIO维持清晰的文件式接口抽象。
六、总结
理解 join 与 += 的性能分水岭,核心在于认识 Python 字符串的不可变性以及内存分配开销。在处理动态批量文本拼接时:
- 切忌在循环体中使用
+=,避免触发不可预测的 O(N²) 内存颠簸与全量拷贝。 - 以“列表暂存后统一
join()”作为默认且稳定的编码规范。 - 在内存充裕时优先使用列表推导式而非生成器,以最大化发挥
PyUnicode_Join的预分配能力。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









