

Python 3.9新增字典合并操作符|和|=用法指南

dict.update() 方法或 {**d1, **d2} 解包语法,但这些方式要么存在改变原对象的副作用,要么语法不够直观。Python 3.9 正式引入了 PEP 584,为内置字典(dict)增加了合并操作符 | 与就地更新操作符 |=。本文将系统梳理这两个操作符的标准语法、键冲突覆盖原则、底层引用机制以及与历史方案的边界差异,帮助你在实际开发中写出既简洁又安全的数据处理代码。
一、操作符语法与基础用法
Python 3.9 扩展了内置的二进制按位或符号,使其在映射类型之间承担联合与合并的语义。根据是否生成全新对象,分为纯表达式合并操作符 | 与原地增量赋值操作符 |=。
1. 纯表达式合并:操作符 |
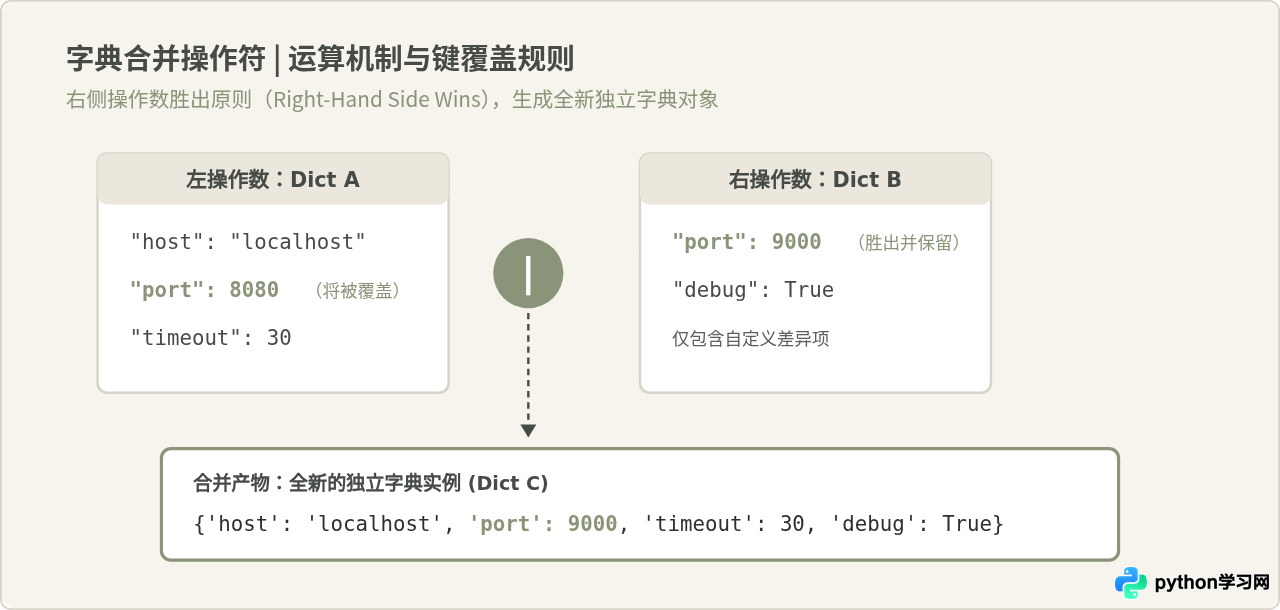
操作符 | 用于将两个字典的内容合并,并返回一个包含了双方所有键值对的全新字典实例。运算过程中,参与计算的原始字典均不会被篡改。
# 运行环境:Python 3.9+
default_config = {"host": "localhost", "port": 8080, "timeout": 30}
user_config = {"port": 9000, "debug": True}

# 执行合并
active_config = default_config | user_config

print("合并结果 active_config:", active_config)
print("原始配置 default_config:", default_config)
print("用户配置 user_config:", user_config)合并结果 active_config: {'host': 'localhost', 'port': 9000, 'timeout': 30, 'debug': True}
原始配置 default_config: {'host': 'localhost', 'port': 8080, 'timeout': 30}
用户配置 user_config: {'port': 9000, 'debug': True}
当两个字典中出现重复键时,操作符严格遵循右操作数优先(Right-Hand Side Wins)的覆盖规则。在上述示例中,default_config 和 user_config 均包含键 "port",结果字典保留了右侧 user_config 的数值 9000。
2. 就地增量更新:操作符 |=
操作符 |= 是字典就地更新(In-place Merge)的专用语法。它直接修改位于左侧的原字典对象,而不会在内存中分配新的字典实例,其运行效果等同于调用 d1.update(d2)。
# 运行环境:Python 3.9+
session_data = {"user_id": 1001, "role": "guest"}
print("更新前内存地址:", id(session_data))

# 使用 |= 原地更新
session_data |= {"role": "admin", "token": "abc-xyz"}

print("更新后内存地址:", id(session_data))
print("更新后内容:", session_data)更新前内存地址: 4356789120
更新后内存地址: 4356789120
更新后内容: {'user_id': 1001, 'role': 'admin', 'token': 'abc-xyz'}d1 | d2 要求左右两个操作数通常必须都是 dict 实例(或实现了对应特殊方法的映射对象)。如果尝试使用字典与列表进行 | 运算,会触发 TypeError。然而,就地更新 d1 |= iterable 的容错度更宽,其右侧可以接收任何生成 (key, value) 二元组的可迭代对象,例如 d1 |= [("status", 200)]。
二、内存机制与引用生命周期辨析
理解 | 与 |= 的核心在于明确对象生命周期与副作用。在编写函数、封装业务配置或在多模块间共享状态时,混淆两者可能会带来隐蔽的数据污染问题。
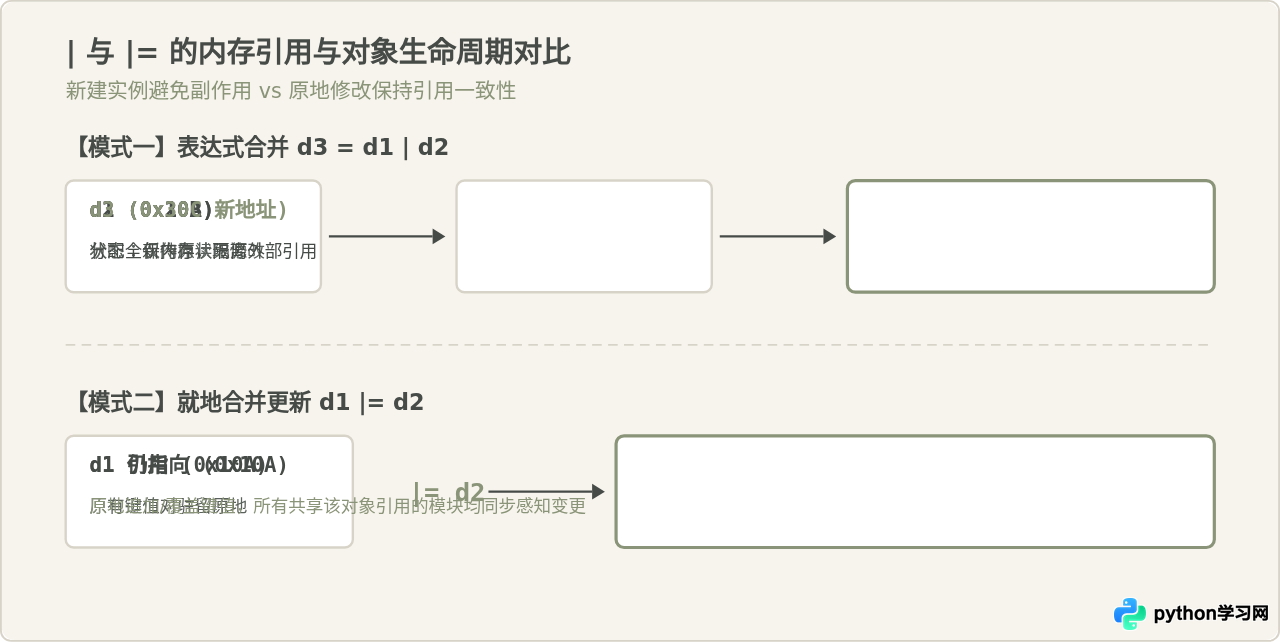
在编写公用函数时,如果直接使用 d1 |= d2,传入的入参若属于外部传入的共享字典,函数外部的数据也会被不可逆地改写。如果不希望产生副作用,应始终优先使用 d1 | d2 构建全新副本。
三、典型应用流程与场景实践
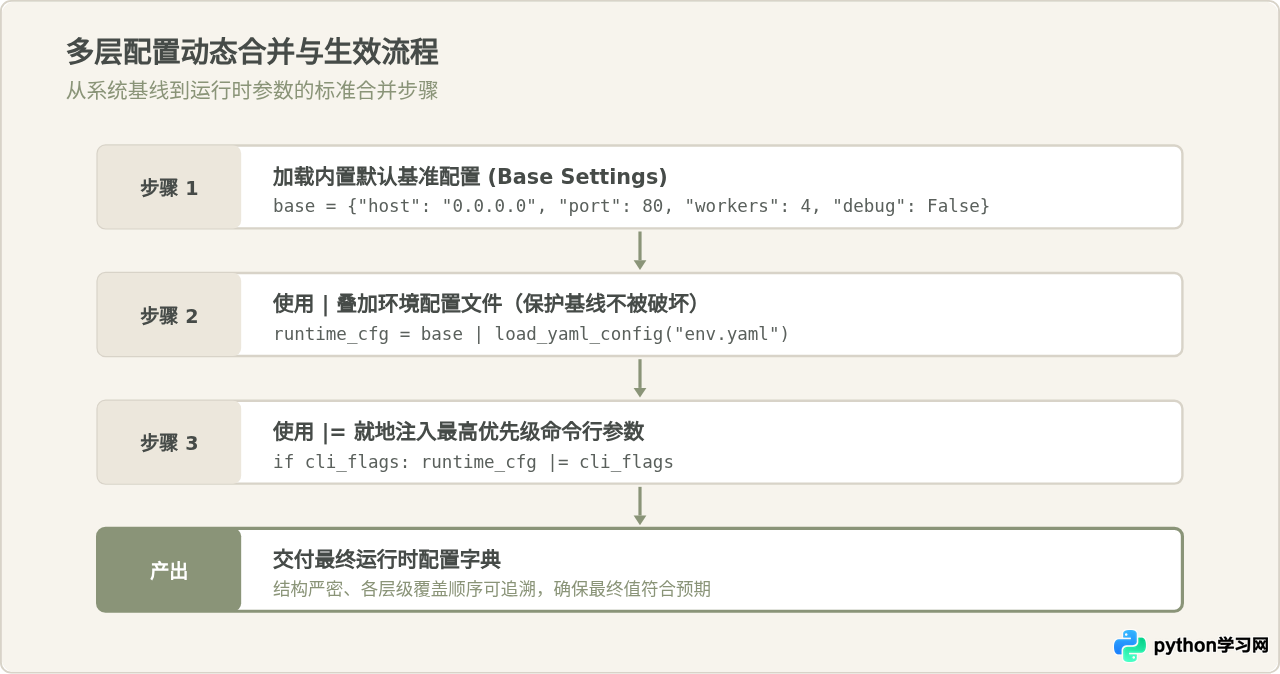
在实际工程开发中,| 和 |= 最常用于多层配置合并、分层参数覆盖以及链式数据流处理。
链式合并多个字典
操作符 | 满足从左到右结合的运算特性,支持优雅的链式书写:
schema_defaults = {"theme": "light", "lang": "zh"}
app_settings = {"theme": "dark", "fontSize": 14}
user_preferences = {"fontSize": 16, "showLineNumbers": True}

# 从左向右依次合并,最右侧拥有最高优先级
final_settings = schema_defaults | app_settings | user_preferences
print("最终合并结果:", final_settings)最终合并结果: {'theme': 'dark', 'lang': 'zh', 'fontSize': 16, 'showLineNumbers': True}四、容易混淆的技术认知与深层辨析
在接触 | 和 |= 时,部分开发者容易将其与深拷贝或集合运算画上等号。明确以下几个关键细节,有助于避免在复杂数据结构中踩坑。
1. 误区辨析:| 是浅拷贝还是深拷贝?
结论:操作符 | 仅执行浅拷贝(Shallow Copy)。
当字典中的值包含嵌套的可变对象(如列表、嵌套字典)时,合并后新字典中的值只是持有了对原对象引用的拷贝。若修改嵌套对象,会引发联动变更。如果数据结构存在深层嵌套,仍需借助 copy.deepcopy() 进行深度递归拷贝。
2. 为什么不继续沿用 {**d1, **d2}?
许多开发者会问:既然 Python 3.5 已经支持了双星号解包 {**d1, **d2},为何还要额外增加 | 操作符?
- 视觉意图更直观:双星号解包属于函数参数解包语法的延伸,阅读时不如二元运算符直观。
- 继承与定制性:
|背后对应的是特殊方法__or__和__ior__,自定义的字典子类可以重写这些方法实现自定义合并逻辑;而解包语法{**d1, **d2}是由解释器层直接构造标准字典,无法被子类拦截或扩展。 - 与集合(Set)语法保持统一:在 Python 中,集合的并集运算早已使用
|和|=,为字典提供相同符号使得标准库的运算符体系更为对称自然。
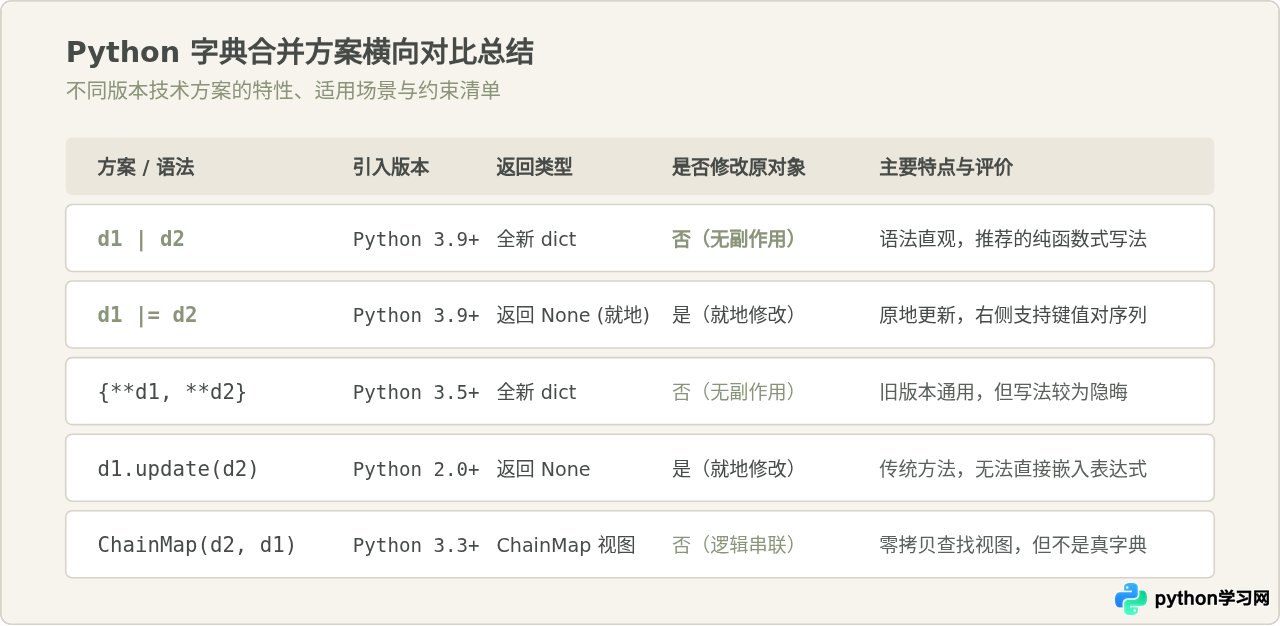
五、Python 历代字典合并方案对比总结
回顾 Python 的演进历史,合并字典经历了多种方案。不同方案在返回值、是否改变原字典以及键类型限制上各有差异。
六、实践总结与选用建议
在 Python 3.9 及更高版本的开发实践中,推荐遵循以下准则:
- 需要生成新字典时:优先使用
d1 | d2或链式合并d1 | d2 | d3,语法表达清晰,逻辑无副作用。 - 需要原地更新大字典时:使用
d1 |= d2替代d1.update(d2),使增量更新的书写风格与整数、集合等标准数据类型保持高度一致。 - 若需兼容 Python 3.8 及更低环境:继续使用
{**d1, **d2}创建新副本,或在代码头部提供向下兼容的辅助函数。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









