

Python中小整数缓存对is运算结果的影响

在 Python 中对相同的数值执行比较时,开发者常常会遇到令人困惑的现象:同样是比较两个相等的整数,有时使用 is 返回 True,有时却返回 False。其根本原因在于官方 CPython 解释器内置了小整数缓存机制(Small Integer Cache)。本文直接剖析小整数缓存的范围、底层实现机制,深入解答它对 is 与 == 比较结果带来的直接影响,并提供明确的编写规范。
一、现象引入:令人困惑的整数比对结果
打开 Python 原生交互式命令行(REPL),分别执行以下两组代码:
>>> a = 256
>>> b = 256
>>> a is b
True

>>> x = 257
>>> y = 257
>>> x is y
False
在数值完全相等的前提下,数值为 256 时 a is b 判定为真,而换成 257 后 x is y 却判定为假。然而,若改用 == 运算符:
>>> a == b
True
>>> x == y
True
两者均稳定返回 True。这种行为并非 Python 出现计算偏差,而是因为 is 运算符与 == 运算符检查的本质完全不同,且 CPython 在内存管理上做出了特定的缓存优化。
二、CPython 小整数缓存机制的本质
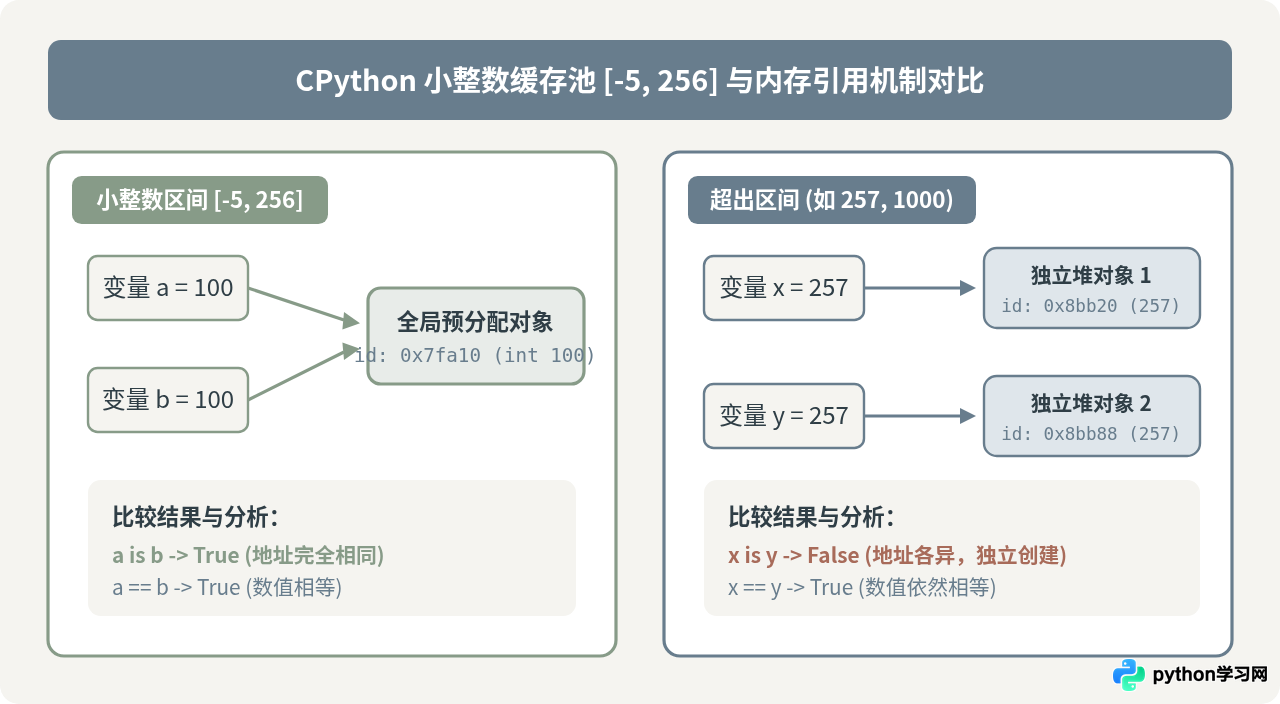
在 Python 中,整数属于不可变对象(Immutable Object)。在日常编程中,较小的整数(如计数器 0、状态标记 1、索引值等)使用频率极高。如果每次用到这些数字都在堆内存上开辟新内存空间、创建 PyLongObject 并在用完后回收,会带来显著的内存碎片与性能损耗。
为此,CPython 在虚拟机启动时,预先在全局内存中初始化了一个固定区间的整数对象数组。这一区间被硬编码在 CPython 源码中:
- 下限常量
NSMALLNEGINTS:默认为-5 - 上限常量
NSMALLPOSINTS:默认为256
凡是落在闭区间 [-5, 256] 内的整数(共 262 个),在解释器运行生命周期内都是全局单例对象。每次代码中给变量赋予该区间的整数时,解释器不会分配新内存,而是直接返回对应预置对象的内存指针。
三、is 运算符的底层逻辑与判定推导
要理解为什么小整数缓存会直接左右 is 的运算结果,必须厘清 is 与 == 的求值逻辑差异:
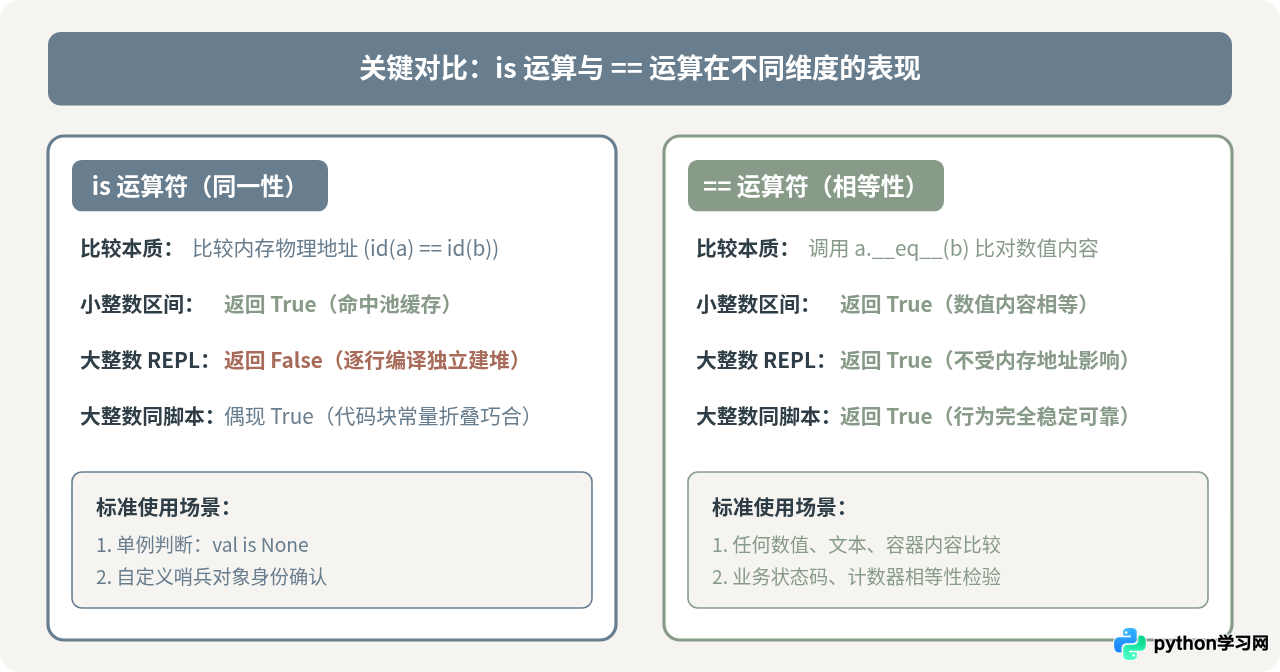
is运算符(Identity 测试):检验两个变量是否引用内存中的同一个物理对象。其执行效率极高,直接比对两个指针地址,相当于 CPython 内部的id(a) == id(b)。==运算符(Equality 测试):检验两个变量的数值或内容是否等价。它会调用对象的__eq__()特殊方法逐项比对数据内容。
当执行赋值与 is 运算时,解释器的内部判定推导流程如下:
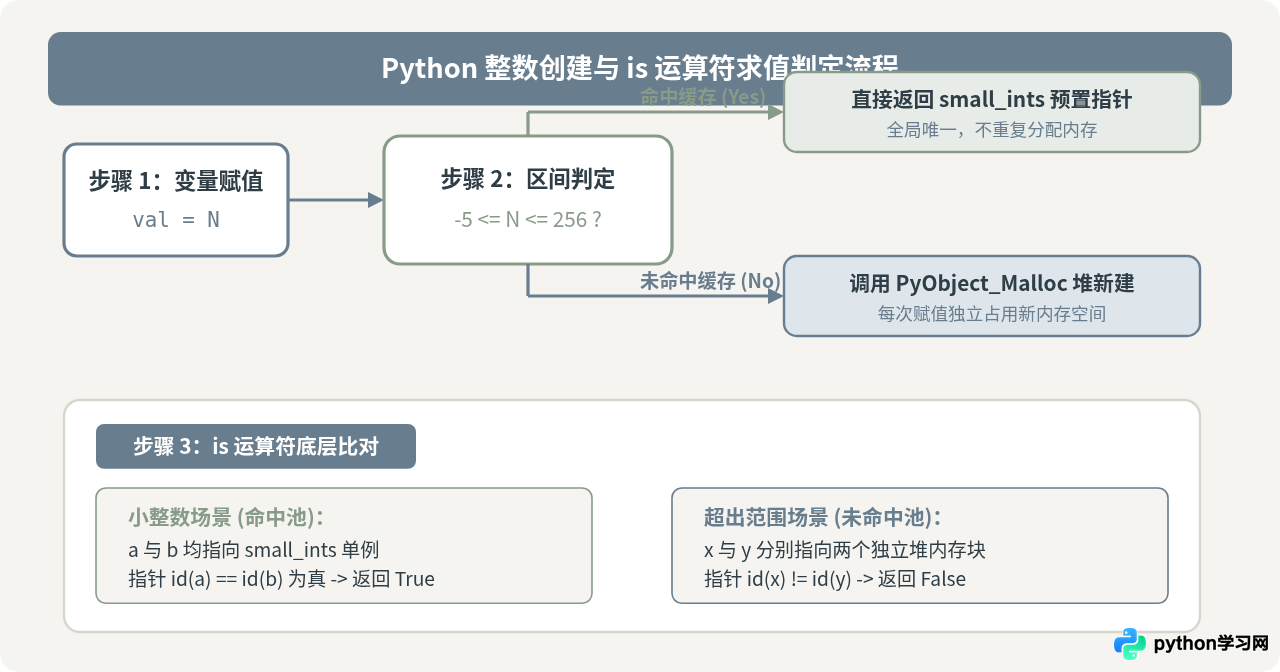
通过上述推导可以发现:小整数下 a is b 返回 True,完全是内存池复用带来的“副作用”,并非 is 本身具有数值比对的能力。
四、环境差异:为什么脚本执行与交互式命令行不同?
许多初学者还会遇到另一个反常现象:如果将同样的比较语句写在一个 .py 脚本文件中执行:
# test.py
x = 257
y = 257
print(x is y)
运行该脚本,终端输出的居然是 True!
这是否意味着小整数缓存的上限并非 256?答案是否定的。造成这一现象的原因是代码块(Code Block)的常量折叠与常量表优化:
- REPL 模式:在交互式命令行中,用户每输入一行,解释器就立即将其编译为一个独立的代码块(Code Object)并执行。由于
x = 257与y = 257属于两个独立编译周期,257 又超出了小整数缓存,因此分别在堆上创建了两个对象。 - 脚本或函数体:整个脚本模块或函数体被作为一个整体代码块统一编译。在编译期,Python 优化器会分析该代码块的常量池(
co_consts)。当发现同一代码块中重复出现了字面量257时,编译器复用了同一个常量对象。
这种常量折叠依赖于代码是否处于同一编译单元,如果跨越模块或通过动态计算(如 int("257")),这一优化便不复存在。因此,切勿将编译器优化当成稳定的语言保证。
五、业务开发中的隐蔽陷阱与正确规范
误用 is 比较整数会在实际项目中埋下极难排查的重大 Bug。例如以下代码:
def process_order(status_code):
    # 错误写法:利用 is 判断状态码
    if status_code is 200:
        return "成功"
    elif status_code is 500:
        return "服务器错误"
    return "未知状态"
这段代码在测试时传入 200 能够正常工作,因为 200 落在 [-5, 256] 内,命中全局缓存;但当生产环境传入 500 时,status_code is 500 极大概率判定为 False,导致业务逻辑直接落入“未知状态”异常分支。
避坑铁律:判断数值是否相等,必须始终使用 == 和 !=。在现代 Python(Python 3.8 及以上版本)中,若尝试对字面量使用 is 比较(例如 x is 1),解释器在编译期会直接抛出 SyntaxWarning: "is" with a literal. Did you mean "=="? 警示开发者纠正该错误。
六、总结与核心看板
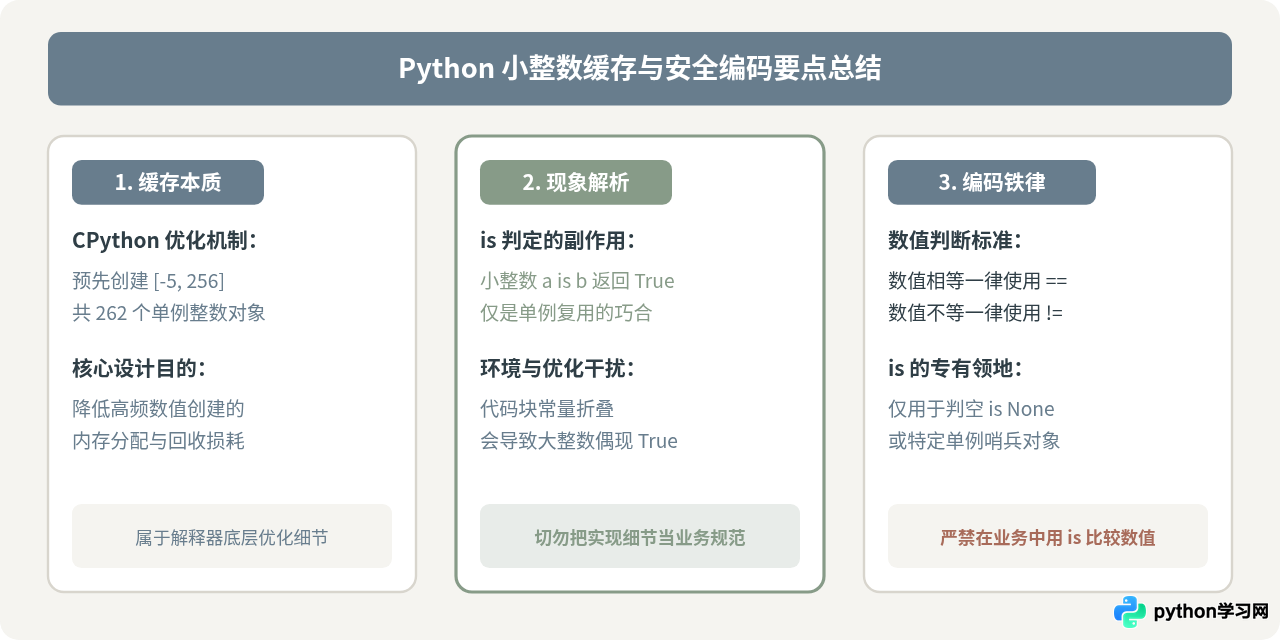
Python 中小整数缓存是为了提高虚拟机运行效率而采取的底层优化实现。它使得 [-5, 256] 的整数对象在全局范围内共享单例。理解该机制有助于看清对象生命周期与内存分配细节,但在编写业务代码时,绝不能依赖这一实现细节来判断数值相等。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









