


pandas分别写入excel的不同sheet方法
本文介绍如何使用pandas将多个DataFrame写入Excel的不同Sheet。重点指出常见错误:误用ExcelFile导致文件保存路径问题,并解析源码揭示其基于xlrd的实现机制。通过正确使用ExcelWriter可避免文件丢失,确保数据持久化。
2026-10-13
9
本文介绍如何使用pandas将多个DataFrame写入Excel的不同Sheet。重点指出常见错误:误用ExcelFile导致文件保存路径问题,并解析源码揭示其基于xlrd的实现机制。通过正确使用ExcelWriter可避免文件丢失,确保数据持久化。
本文介绍如何利用Python sklearn库中的KFold方法生成交叉验证数据集,并保存为CSV文件。文章指出直接使用KFold可能无法满足样本分布比例一致的需求,需分别对正负样本进行KFold处理后再合并。同时澄清了train和test是原始数据集的索引而非子数据集索引,并提供了相关代码示例。
本文精选5本适合不同基础的Python入门书籍,涵盖从零基础到项目实战的完整学习路径。推荐《Python基础教程》《与孩子一起学编程》《笨办法学Python》《Python编程入门》及《计算机编程导论》,帮助读者高效掌握字符串、列表等核心概念,并通过小项目巩固技能,是Python初学者不可错过的学习资源。
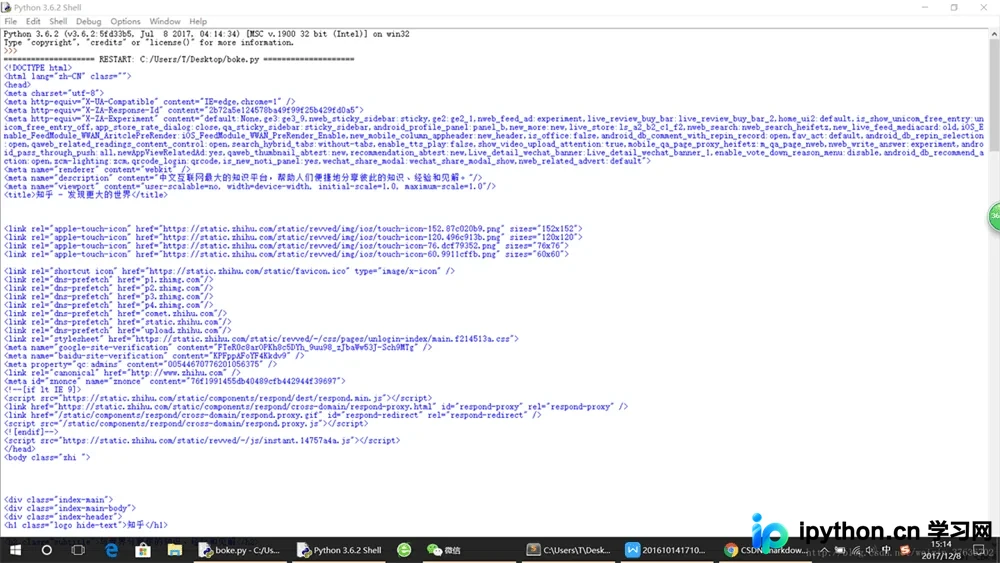
本文针对Python3环境提供爬虫入门指南,对比Python2差异,推荐边学边做。通过抓取知乎首页源码演示urllib.request.urlopen()用法,解析HTML并处理编码,介绍爬虫流程及数据提取存储方法,帮助初学者快速上手。
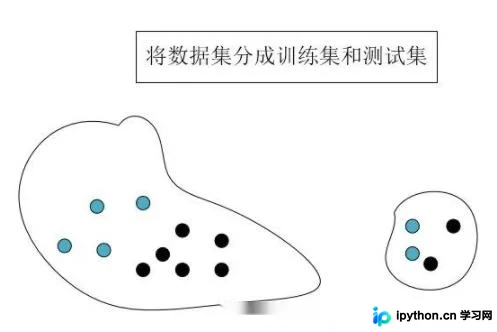
本文深入解析Python中StratifiedShuffleSplit函数的使用方法。该函数通过分层洗牌策略,在保持类别比例一致的前提下进行多次随机分割,适用于不平衡数据集的模型训练。文章详细说明了n_splits、test_size、train_size及random_state等关键参数的配置逻辑,并结合具体代码示例展示了如何生成满足特定比例的多组训练与测试集,帮助开发者优化模型评估流程。
本文介绍了如何在Python环境中利用KNN算法对Iris数据集进行分类。通过加载数据集、划分训练测试集、标准化处理以及模型训练与评估,展示了完整的分类流程。代码示例涵盖了从数据加载到结果输出的关键步骤,帮助读者快速掌握KNN在分类任务中的应用。
本文介绍如何使用Python的sklearn库中的train_test_split函数,将数据集按比例随机划分为训练集和测试集。文章详细解析了该函数的参数用法、返回值含义,并对比了直接传入特征标签与传入含标签数据框的不同处理方式,最后提供了一个自定义划分函数的实现示例,帮助开发者掌握数据预处理的核心技巧。
本文详细介绍如何在Django项目中集成LDAP进行用户身份验证。涵盖python_ldap与django-auth-ldap的安装配置,settings.py核心参数解析(如AUTH_LDAP_SERVER_URI、USER_DN_TEMPLATE),以及用户组同步、中文乱码处理等常见问题解决方案,帮助开发者实现基于AD/LDAP的统一认证管理。

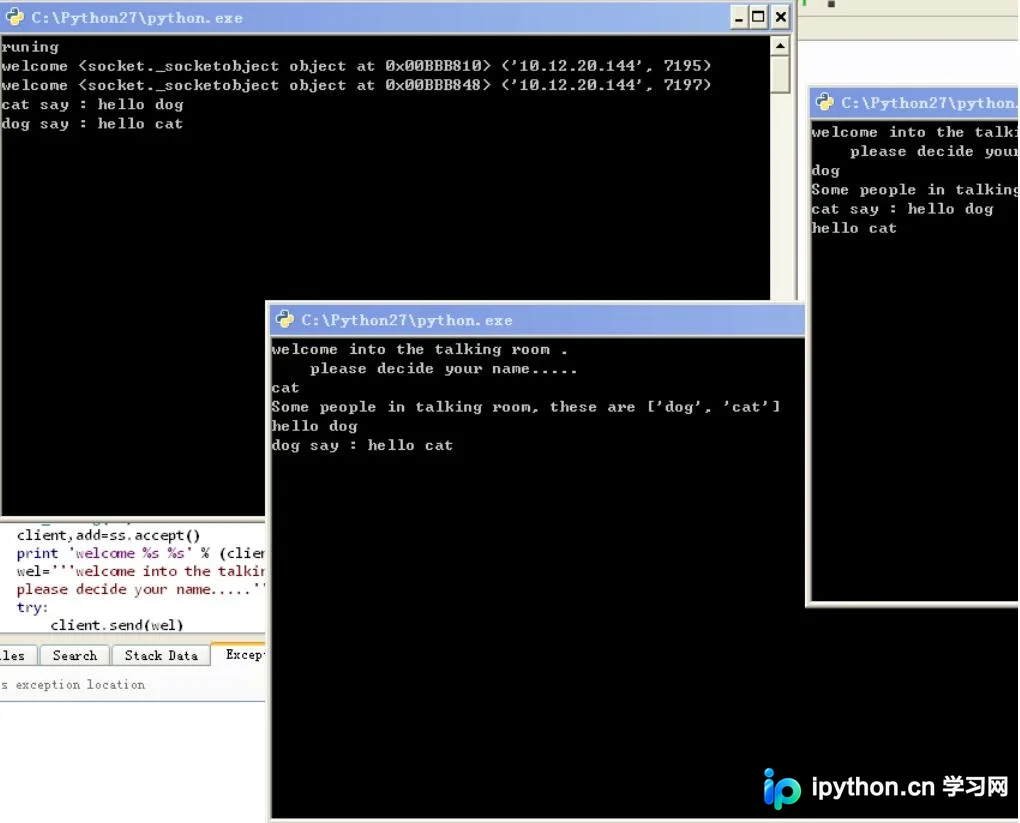
本文介绍使用Python标准库socket和select模块实现的简易多人聊天室。服务端负责管理连接与消息转发,客户端通过多线程分别处理接收与发送。启动服务端后,客户端连接并设置昵称即可加入聊天,所有消息经服务端广播至其他在线用户。
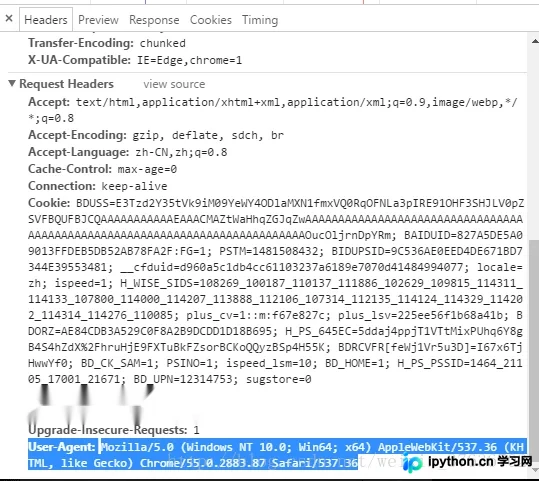
本文详解Python3中利用urllib模块应对网站反爬虫策略的方法。通过构造Request对象并添加包含User-Agent的headers字典,可模拟浏览器访问行为,有效绕过基于请求头鉴别的反爬检测。文中提供了完整的代码示例及API说明,帮助开发者实现更稳定的数据采集。
本文介绍在Python中使用Pandas库读取包含中文字符的CSV或文本文件时,如何通过正确设置encoding参数(如'gbk')来避免乱码或解码错误。通过具体代码示例展示读取含中文数据的文件方法,确保数据完整性和兼容性。
本文介绍利用Python处理超出内存限制的大型TXT文件排序方案。核心思路是将大文件按行数切割为多个小文件,分别排序后,通过归并排序算法合并结果。文章详细讲解了获取总行数、均等切割逻辑及多路归并的具体实现步骤,适用于海量数据离线处理场景。