

Python中StratifiedShuffleSplit函数详解:参数、原理与实战应用

本文深入解析Python中StratifiedShuffleSplit函数的使用方法。该函数通过分层洗牌策略,在保持类别比例一致的前提下进行多次随机分割,适用于不平衡数据集的模型训练。文章详细说明了n_splits、test_size、train_size及random_state等关键参数的配置逻辑,并结合具体代码示例展示了如何生成满足特定比例的多组训练与测试集,帮助开发者优化模型评估流程。
文章开篇首先介绍交叉验证的概念,这一机制同样适用于StratifiedShuffleSplit函数的应用场景。
1. 交叉验证 (Cross-validation)
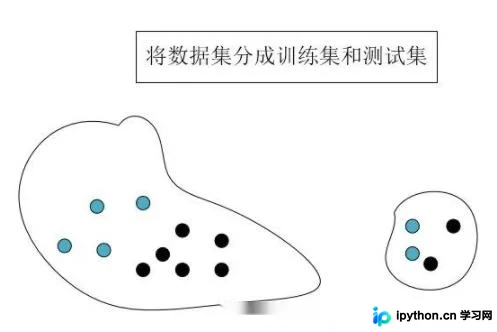
交叉验证的核心思想是在给定的建模样本中,抽取大部分数据用于模型训练以生成模型,同时保留小部分数据用于预测。通过计算这部分样本的预测误差并累加其平方和,可以评估模型性能。该过程持续进行,直到所有样本均被预测且仅被预测一次。最终,通过比较各组的预测误差,选择误差最小的一组作为最优训练模型。
具体流程如下图所示
2. StratifiedShuffleSplit函数的使用
官方文档参考
基本用法如下:
from sklearn.model_selection import StratifiedShuffleSplit
StratifiedShuffleSplit(n_splits=10,test_size=None,train_size=None, random_state=None)
2.1 参数说明
参数 n_splits 用于指定将训练数据划分为 train/test 对的组数,用户可根据实际需求进行设置,默认值为 10。
参数 test_size 和 train_size 用于设定 train/test 对中训练集与测试集所占的比例。具体示例如下:
假设共有 10 个数据样本 num 用于训练和测试集的划分
设置 train_size=0.8 且 test_size=0.2
计算得出训练样本数 train_num = num * train_size = 8,测试样本数 test_num = num * test_size = 2
即经过划分后,10 个数据中有 8 个作为训练数据,2 个作为测试数据
注意:需满足 train_num ≥ 2 且 test_num ≥ 2;此外,test_size 与 train_size 之和可以小于 1
参数 random_state 用于控制样本的随机打乱过程,确保结果的可复现性
2.2 函数作用描述
该函数生成指定数量的独立 train/test 数据集划分,将数据集分割为 n 组。
首先对样本进行随机打乱,随后根据设定的参数划分出对应的 train/test 对。
其创建的每一组划分均保证各类别的比例相同。例如,若第一组训练数据中类别比例为 2:1,则后续所有组的类别划分均严格维持这一比例
2.3 具体实现
from sklearn.model_selection import StratifiedShuffleSplit
import numpy as np
X = np.array([[1, 2], [3, 4], [1, 2], [3, 4],
 [1, 2],[3, 4], [1, 2], [3, 4]])#训练数据集8*2
y = np.array([0, 0, 1, 1,0,0,1,1])#类别数据集8*1

ss=StratifiedShuffleSplit(n_splits=5,test_size=0.25,train_size=0.75,random_state=0)#分成5组,测试比例为0.25,训练比例是0.75

for train_index, test_index in ss.split(X, y):
 print("TRAIN:", train_index, "TEST:", test_index)#获得索引值
 X_train, X_test = X[train_index], X[test_index]#训练集对应的值
 y_train, y_test = y[train_index], y[test_index]#类别集对应的值
运行结果如下:
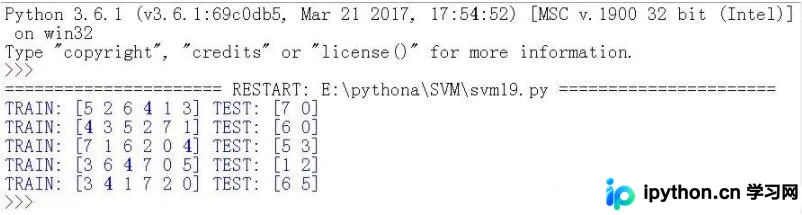
从结果可以看出:1. 训练集包含 6 个样本,测试集包含 2 个样本,这与预设参数相符;2. 五组划分中,每一组对应的类别比例保持一致
以上关于 Python 中数据集划分函数 StratifiedShuffleSplit 的使用详解即为全部内容,希望能对读者有所帮助,也欢迎大家继续支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









