

Python基础语法练习题精选:变量、循环与函数代码解析

一、变量与对象引用练习:掌握可变类型与内存行为
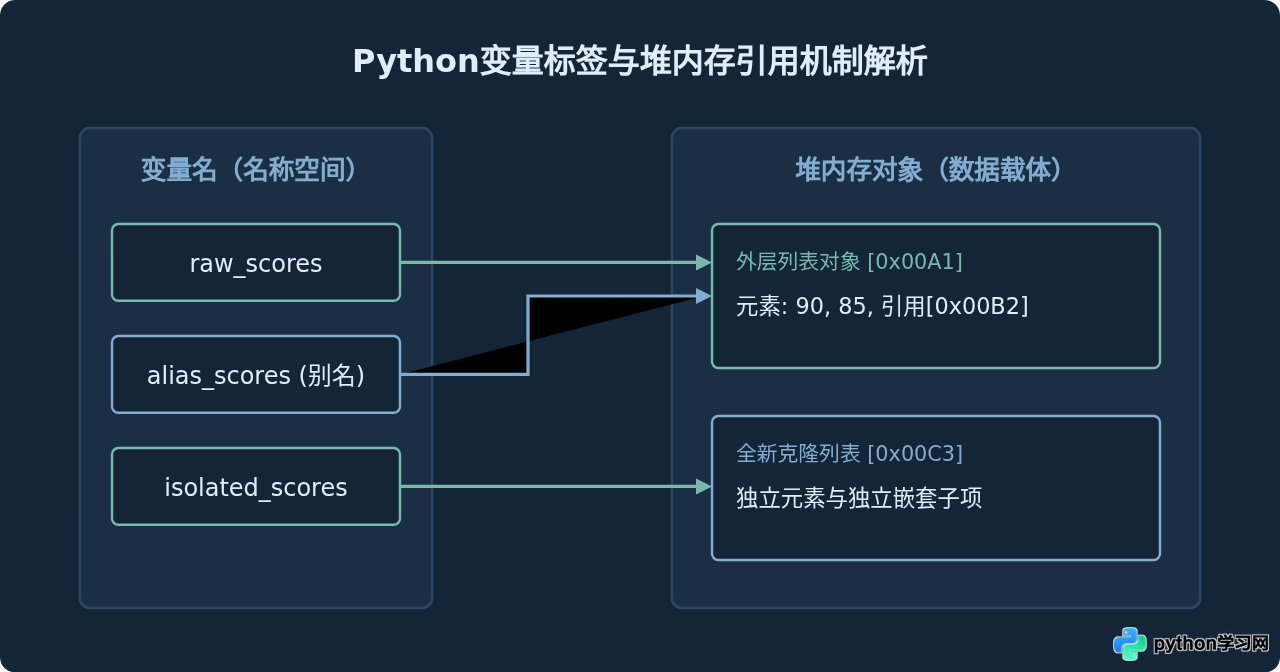
在 Python 中,“变量”本质上是一个贴在内存对象上的标签,赋值操作 = 负责建立标签与对象之间的绑定关系。理解这一点是避免数据意外篡改和幽灵 Bug 的前提。
【练习题 1】列表别名与浅拷贝陷阱
题目要求:给定一个包含学员成绩的嵌套列表,要求将数据备份到新变量中,并尝试修改原列表的子项,观察新变量是否会随之变化;随后给出真正隔离修改的解决方案。
# 练习代码:对比引用赋值、浅拷贝与深拷贝
import copy

# 1. 简单引用别名测试
raw_scores = [90, 85, [70, 75]]
alias_scores = raw_scores

# 修改原列表中的子列表
raw_scores[2][0] = 99
print(f"引用赋值后别名受影响: {alias_scores[2][0]}")  # 输出: 99

# 2. 浅拷贝 copy()
shallow_copy = raw_scores.copy()
raw_scores[2][1] = 88
print(f"浅拷贝后嵌套项依然受影响: {shallow_copy[2][1]}")  # 输出: 88

# 3. 完全隔离方案:深拷贝 deepcopy()
isolated_scores = copy.deepcopy(raw_scores)
raw_scores[2][0] = 60
print(f"原列表已变更为: {raw_scores[2][0]}")          # 输出: 60
print(f"深拷贝副本保持隔离: {isolated_scores[2][0]}")   # 输出: 99
代码解析:
第 5 行中 alias_scores = raw_scores 并没有开辟新的列表空间,只是创建了一个指向同一块内存地址的别名;
第 13 行的 raw_scores.copy() 创建了外层的新容器,但嵌套在内部的子列表 [70, 75] 依然指向原有对象;
只有第 18 行的 copy.deepcopy() 递归遍历并克隆了所有嵌套层级,实现了完全独立的数据副本。
二、循环与流程控制练习:条件判断与循环分支配合
for 循环与 while 循环负责自动化重复任务。很多初学者习惯用外置标志位(如 flag = True)来判断循环是否被中途打断,而忽略了 Python 原生支持的 for...else 与 while...else 结构。
【练习题 2】区间素数检测与 for-else 结构应用
题目要求:编写一段程序,遍历指定整数区间(例如 10 到 25),判断每个数字是否为素数。若是素数则打印该数字,若存在因数则在找到首个因数后立即终止当前数的检验,并打印其因数分解信息。
# 练习代码:使用 for...else 优化素数判断
start_num, end_num = 10, 25

print(f"正在分析区间 [{start_num}, {end_num}] 的素数状态:")

for num in range(start_num, end_num + 1):
    if num < 2:
        continue
    # 试除法遍历可能的因子
    for factor in range(2, int(num ** 0.5) + 1):
        if num % factor == 0:
            print(f"{num} 不是素数 (因数为 {factor} * {num // factor})")
            break
    else:
        # 仅当内层循环未触发 break 自然结束时执行
        print(f">>> {num} 是素数")
代码解析:
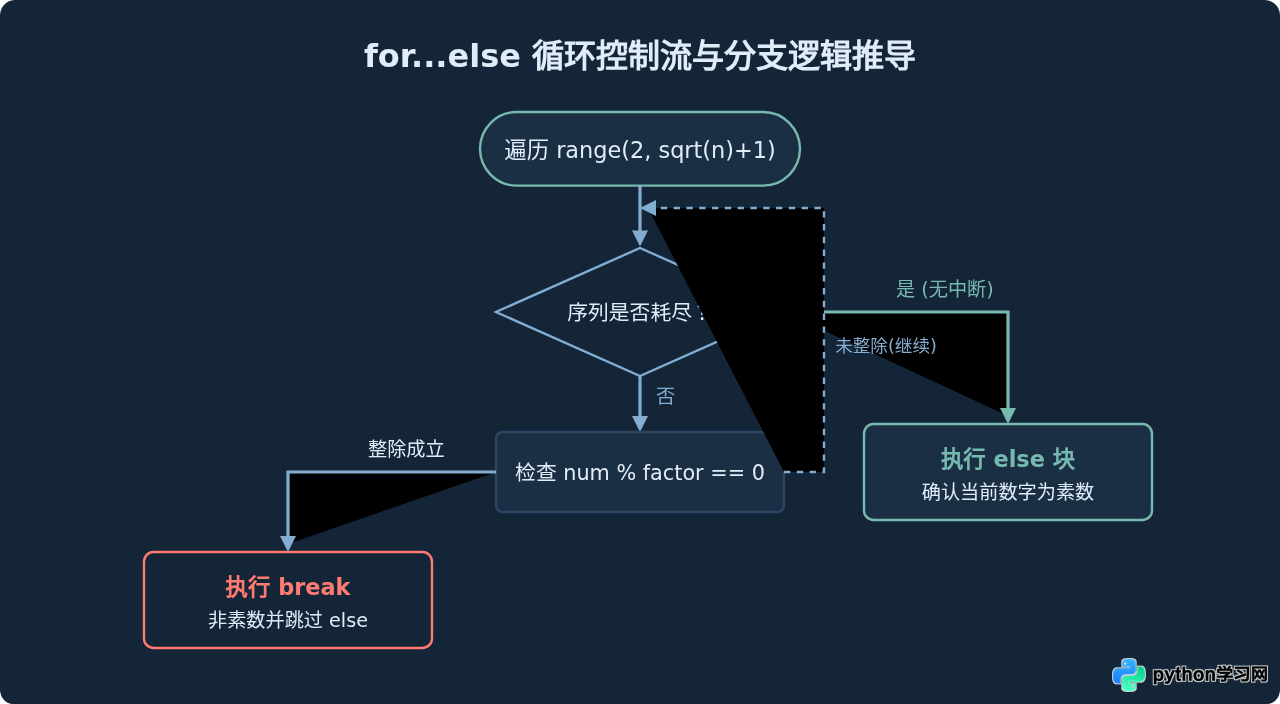
第 10 行的内层循环使用 int(num ** 0.5) + 1 确定试除上限,避免无意义的算力浪费;
当发现 num % factor == 0 时,执行 break 彻底跳出当前内层循环,防止继续冗余检查;
第 14 行的 else: 直接挂在 for 语句下方,而非 if 语句下方。只有当内层循环正常迭代完毕且未触发任何 break 时,才会执行该代码块。这一机制省去了定义额外状态变量的冗长步骤。
三、函数进阶练习:默认参数陷阱与 LEGB 作用域
函数是组织逻辑代码的基本单元。初学者常犯的典型错误包括:将可变对象作为函数形参的默认值,以及混淆局部变量和全局变量的查找层级。
【练习题 3】可变默认参数防御与闭包计数器
题目要求:实现一个向数据列表添加条目的函数,修复因为默认参数 target=[] 引发的共享污染;在此基础上编写一个独立的函数计数器,展示嵌套作用域(Enclosing Scope)的数据捕获。
# 练习代码:防御可变默认参数与闭包作用域实践

# 1. 错误示范与正确写法对比
def append_item_safe(item, container=None):
    """正确处理可变默认值:在函数体内动态初始化"""
    if container is None:
        container = []
    container.append(item)
    return container

print(append_item_safe("A"))  # 输出: ['A']
print(append_item_safe("B"))  # 输出: ['B'] (不会残留先前的 'A')

# 2. 嵌套函数与 nonlocal 作用域控制
def make_step_counter(initial_step=0):
    """生成带有闭包状态的步进计数器"""
    current = initial_step

    def step(increment=1):
        nonlocal current  # 明确声明绑定外层闭包变量
        current += increment
        return current

    return step

counter_tracker = make_step_counter(10)
print(f"第一次累加: {counter_tracker(5)}")   # 输出: 15
print(f"第二次累加: {counter_tracker(10)}")  # 输出: 25
代码解析:
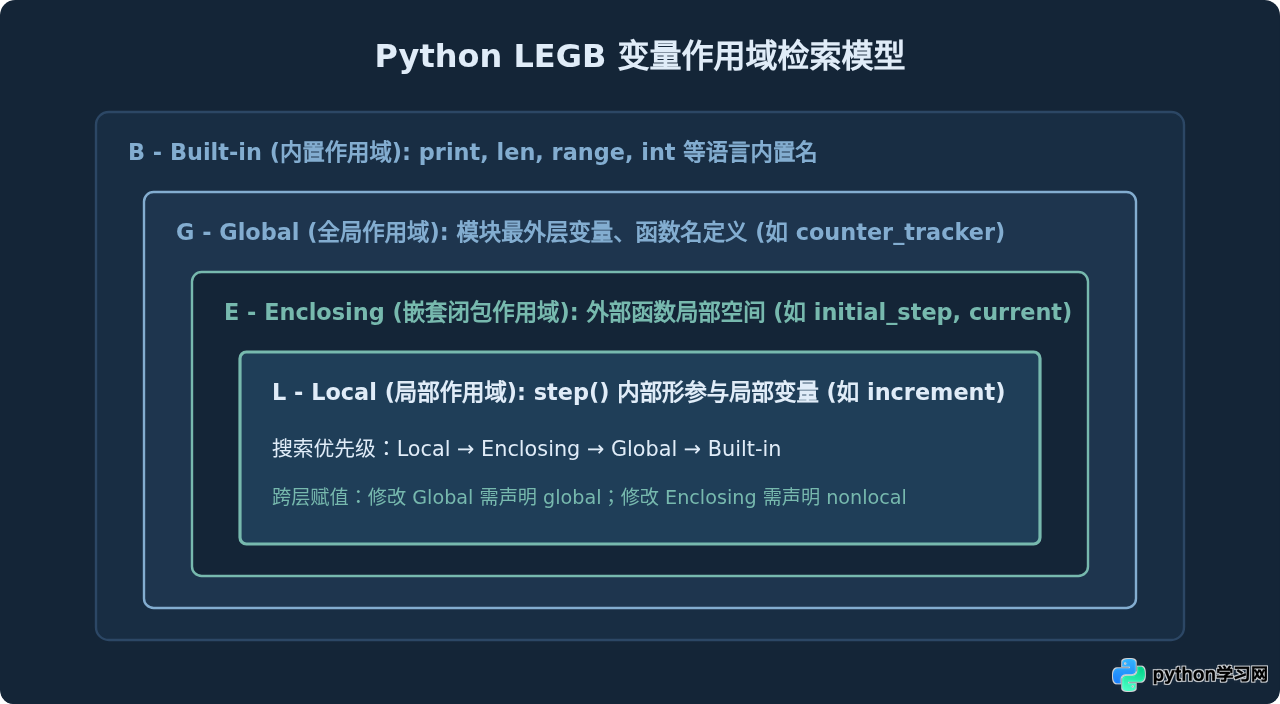
Python 中的函数形参默认值是在“模块加载并定义函数时”评估并初始化的,而不是在每次调用时新建。因此,如果直接写 container=[],多次调用将共同持有同一个列表对象。第 4-6 行使用 container=None 作为哨兵值,并在执行期动态开辟空列表,彻底杜绝了状态串扰。
在第 17 行的嵌套函数中,如果仅执行 current += increment,解释器会将其判定为当前局部变量赋值,因未在局部定义而引发 UnboundLocalError;使用 nonlocal current 即可正确指示解释器向上一层 Enclosing 作用域捕获变量。
四、综合实战练习:账单流水数据过滤器
将上述变量、循环与函数知识点融会贯通,是解决真实业务场景问题的关键。接下来我们完成一个综合练习:从原始日志中清洗流水账单数据,并按分类完成统计汇报。
【练习题 4】结构化数据清洗与分类汇总
题目要求:实现一个名为 analyze_transactions 的函数。接收一个包含交易字典的列表,过滤掉负数与无效记录,按交易类别汇总金额并返回统计字典,同时包含总交易笔数与交易均值。
# 练习代码:综合串联变量、循环、类型转换与函数设计

def analyze_transactions(records, min_valid_amount=0.0):
    """
    清洗并统计账单记录
    :param records: 包含 {'category': str, 'amount': float} 的字典列表
    :param min_valid_amount: 有效金额阈值,默认 0.0
    :return: 包含分类总额、笔数与平均值的汇总字典
    """
    category_summary = {}
    valid_count = 0
    total_volume = 0.0

    for item in records:
        # 1. 结构与有效性防御检查
        if not isinstance(item, dict):
            continue

        category = item.get("category", "未分类").strip()
        raw_amount = item.get("amount", 0.0)

        # 2. 类型转换与条件筛选
        try:
            amount = float(raw_amount)
        except (ValueError, TypeError):
            continue  # 忽略脏数据

        if amount <= min_valid_amount:
            continue

        # 3. 数据聚合与变量更新
        category_summary[category] = category_summary.get(category, 0.0) + amount
        total_volume += amount
        valid_count += 1

    # 4. 汇总均值计算
    average_amount = round(total_volume / valid_count, 2) if valid_count > 0 else 0.0

    return {
        "categories": category_summary,
        "valid_count": valid_count,
        "total_volume": round(total_volume, 2),
        "average_amount": average_amount
    }

# 测试数据集
raw_logs = [
    {"category": "餐饮", "amount": 45.5},
    {"category": "交通", "amount": 12.0},
    {"category": "餐饮", "amount": "88.0"},  # 字符串形式数值
    {"category": "退款", "amount": -20.0},   # 无效负值
    "INVALID_ENTRY",                          # 结构异常条目
    {"category": "娱乐", "amount": 120.0}
]

report = analyze_transactions(raw_logs)
print("分析汇总结果:", report)
输出示例:
分析汇总结果: {'categories': {'餐饮': 133.5, '交通': 12.0, '娱乐': 120.0}, 'valid_count': 4, 'total_volume': 265.5, 'average_amount': 66.38}在处理集合和字典的动态累加时,推荐使用 dict.get(key, default) 或者标准库中的 collections.defaultdict,能有效避免因 KeyError 导致的程序中断,使代码简洁且健壮。
五、知识结构回顾与学习全景
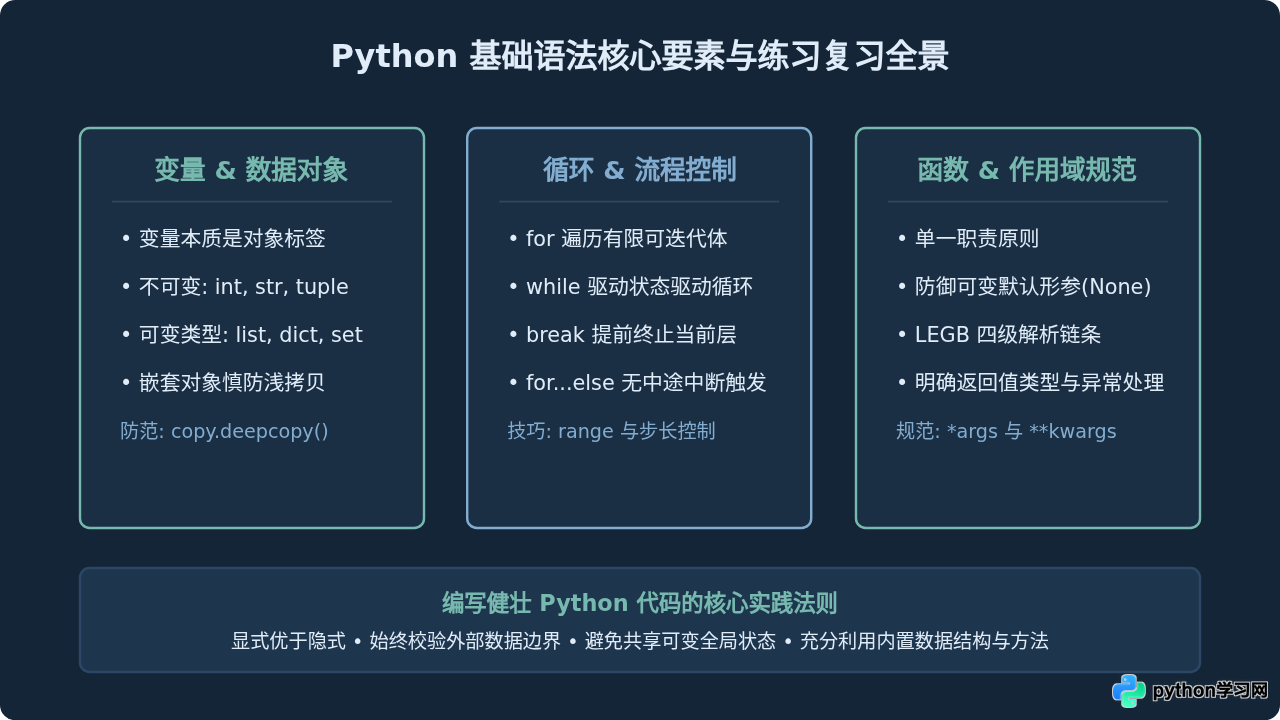
通过以上四道典型练习,我们可以清晰归纳出 Python 基础语法的协同运作逻辑:变量负责在堆栈中维护清晰的对象关系,循环负责按照明确边界高效遍历状态,而函数则负责封装单一职责并明确作用域隔离。
在日常练习过程中,建议读者先脱离集成开发环境的自动补全,手动在 Python 交互式命令行(REPL)中追踪每一步变量的 id() 变动、循环计数器增量以及函数返回值的解包过程。透彻掌握这些底层概念,后续无论是进阶面向对象编程、并发处理还是数据分析,都将打下坚实的基础。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









