

Python3爬虫入门:从知乎抓取源码到urllib模块详解

本文针对Python3环境提供爬虫入门指南,对比Python2差异,推荐边学边做。通过抓取知乎首页源码演示urllib.request.urlopen()用法,解析HTML并处理编码,介绍爬虫流程及数据提取存储方法,帮助初学者快速上手。
本文分享Python3网络爬虫的基础入门知识,供读者参考学习。
网络上多数爬虫教程仍基于Python2,但Python3已是主流趋势。由于Python2.x与Python3.x存在诸多差异,初学者直接学习Python2教程往往难以适应。因此,建立系统的学习方法和路线至关重要。笔者在实践一段时间后,整理出此学习过程与经验,旨在分享心得并巩固自身技能。
一、入门篇
此处提供Python3官方技术文档链接。需强调,技术文档主要用于查阅而非系统学习,死记硬背文档效率极低。建议采用“边学边做”的模式,在实践中掌握知识,否则即便熟记文档也难以完成实际项目。笔者曾在此处走过不少弯路,现推荐W3cscjool中的教程,该教程结合理论与实践,效果良好。
1. 少废话,先看东西
第一个示例:抓取知乎首页源代码。
#-*-coding:utf-8 -*-
import urllib.request
url = "http://www.zhihu.com"
page_info = urllib.request.urlopen(url).read()
page_info = page_info.decode('utf-8')
print(page_info)
运行结果如下:
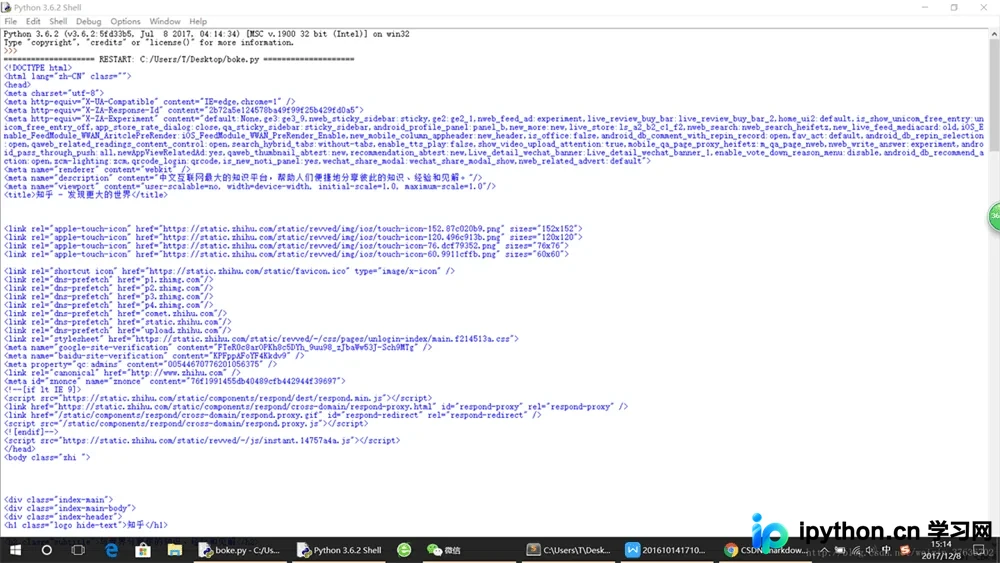
执行代码后,IDLE shell中会输出知乎网站首页的源代码内容。
爬虫定义:
网络爬虫(Web Spider),亦称网页蜘蛛,是一种依照既定规则自动抓取网站信息的程序或脚本。
简介:
“网络蜘蛛”这一名称形象地描述了其工作方式。若将互联网比作一张蜘蛛网,Spider便是在其中爬行的蜘蛛。网络蜘蛛通过网页链接地址寻找页面,从网站某一页面开始读取内容,提取页面中的其他链接地址,再通过这些链接寻找下一个页面,如此循环往复,直至抓取完该网站所有网页。
爬虫流程:
① 利用urllib的request模块打开URL,获取网页HTML文档;② 在浏览器中查看网页源代码以分析元素节点;③ 使用Beautiful Soup(后文介绍)或正则表达式提取所需数据;④ 将数据存储至本地磁盘或数据库(涵盖抓取、分析、存储三个环节)。
urllib和urllib2
在Python2.x中使用的urllib2库,在Python3.x中更名为urllib,并被拆分为多个子模块:urllib.request, urllib.parse和urllib.error。尽管多数函数名称保持不变,但使用新版urllib库时需注意哪些函数被移动到了子模块中。
urllib是Python的标准库,包含从网络请求数据、处理Cookie以及修改请求头和用户代理等元数据的函数。
urlopen用于打开并读取从网络获取的远程对象,可轻松读取HTML文件、图像文件或其他任何文件流。
url = "http://www.zhihu.com"
page_info = urllib.request.urlopen(url).read()
urllib.request是urllib的一个子模块,用于打开和处理一些复杂的网址。
decode('utf-8')用于将页面转换为utf-8编码格式,以避免出现乱码。
page_info = page_info.decode('utf-8')
print(page_info)
urllib.request.urlopen()方法实现打开URL,并返回一个http.client.HTTPResponse对象。通过http.client.HTTPResponse的read()方法获取response body,转码后最终通过print()打印输出。
如需了解更多Python相关内容,可查看本站专题:《Python Socket编程技巧总结》、《Python正则表达式用法总结》、《Python数据结构与算法教程》、《Python函数使用技巧总结》、《Python字符串操作技巧汇总》、《Python入门与进阶经典教程》及《Python文件与目录操作技巧汇总》。
希望本文所述内容对大家学习Python程序设计有所帮助。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









