

Python多进程join卡死怎么解决?使用timeout参数避免无限等待

在 Python 的 multiprocessing 模块中,默认调用 process.join() 会使主进程陷入无期限的阻塞挂起状态,直到该子进程完全退出。一旦子进程内部遭遇死循环、高耗时阻塞 I/O、跨进程资源死锁或数据管道溢出,子进程便无法自然终止,直接造成主进程在 join() 处永久卡死。最直接且稳健的解决方案是为 join() 显式指定超时时限 process.join(timeout=秒数),并在超时后探测 process.is_alive() 的状态。若子进程超时仍存活,则主动执行告警记录与 process.terminate() 强制打断,最后短时复核资源回收,从而彻底消除系统的不可控挂起风险。
一、为什么默认的 join() 会导致主进程永久卡死
多进程编程与多线程不同,每个进程都拥有独立的内存空间、文件描述符表和系统级进程号(PID)。主进程调用 p.join() 时,底层依赖操作系统内核的进程状态等待机制(在 Linux/macOS 上通常对应 waitpid() 系统调用)。默认情况下,如果不给 join() 传递参数,其超时参数为 None,这意味着主进程会无条件向内核交出调度权并挂起,直到收到对应子进程的退出信号。
在实际生产环境中,导致子进程无法退出并在 join() 处诱发卡死的典型根因包括:
- 不可控的长时间计算或外部阻塞:子进程中调用的第三方 C 扩展库、无超时的网络请求或锁死的磁盘文件读写,导致代码逻辑无法执行到末尾。
- 逻辑死循环与未处理异常:子进程运行逻辑中存在未设定退出条件的循环,或者异常捕获后未能正确跳出流程。
- 跨进程锁(Lock/Semaphore)死锁:子进程在持有跨进程锁的过程中崩溃或等待另一个永远不会释放的资源,引发互相等待。
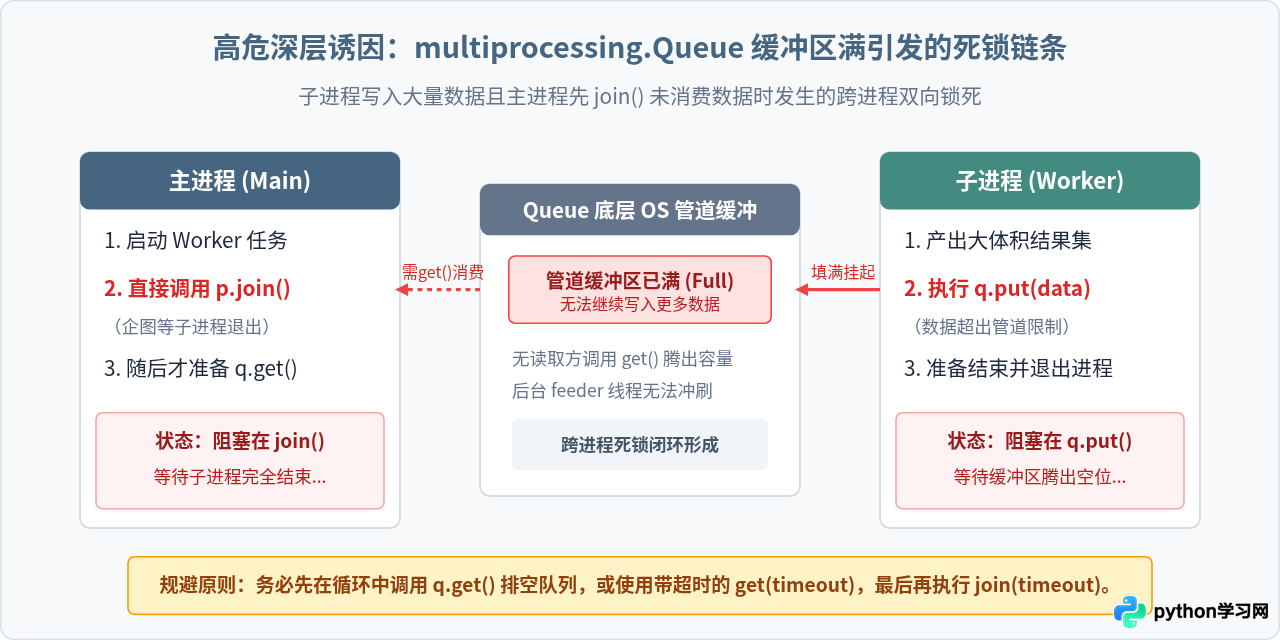
- 进程间通信缓冲满溢:子进程向
multiprocessing.Queue写入超出操作系统底层管道容量的数据,而主进程尚未消费该数据就先行调用join(),造成跨进程双向等待。
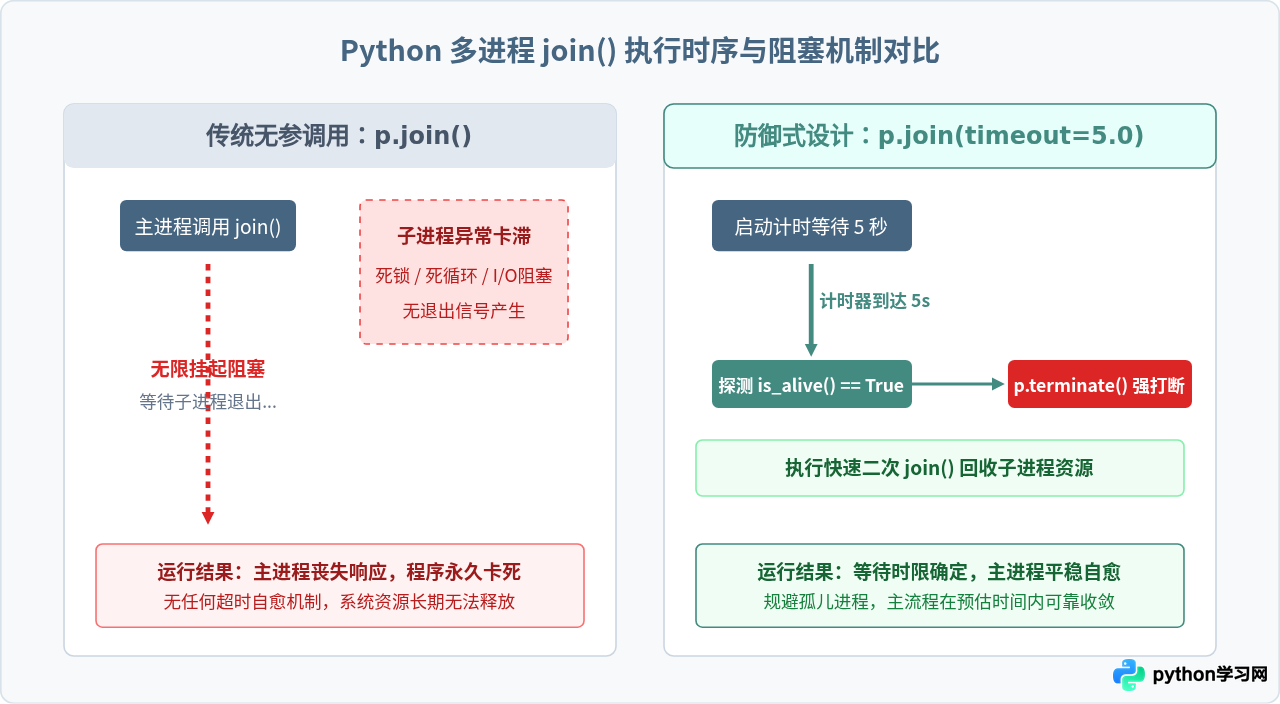
二、使用 timeout 参数的标准四步解决方案
为 join() 传入超时参数后,方法会在设定的秒数到达后立即解除阻塞,主进程重新获取控制权。然而,需要特别强调的是:p.join(timeout=N) 超时后并不会主动抛出任何异常,也不会自动杀死超时的子进程。如果只是写了 p.join(5) 却不做任何后续判断,超时的子进程依然会在后台继续空转,成为与主进程失联的悬挂进程。要构建真正健壮的超时处理,必须遵循以下四个标准步骤:
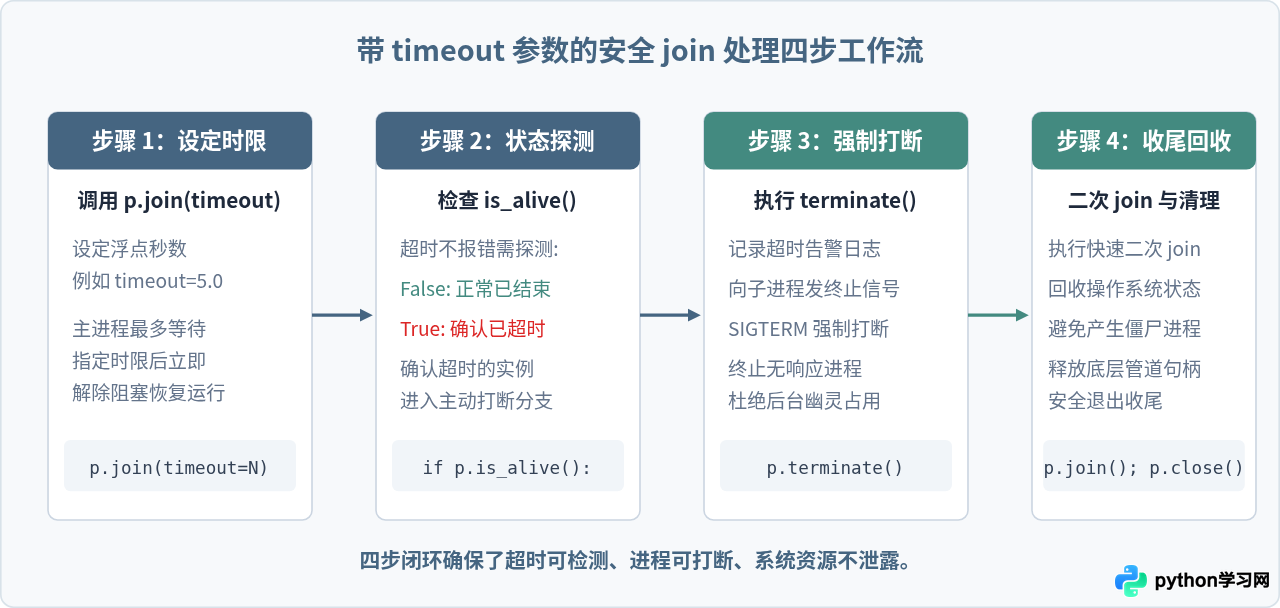
1. 步骤一:合理预估任务上限并设定超时参数
在启动进程 p.start() 之后,调用 p.join(timeout=N)。这里的 N 可以是正整数或浮点数,单位为秒。设置的数值应基于业务正常耗时的上限,通常设定为正常处理时长的 1.5 到 3 倍。主进程会在子进程退出或者到达指定时限后立即解除阻塞返回。
2. 步骤二:使用 is_alive() 探测子进程实际状态
当 p.join(timeout) 执行完毕向下流动时,主进程必须通过 p.is_alive() 进行状态二值探测:
- 如果返回
False,表示子进程在规定时间内已自然执行完毕退出,业务正常完成。 - 如果返回
True,明确说明已达到最大超时阈值且子进程仍滞留在内存中,程序进入超时应对逻辑。
3. 步骤三:主动干预与强制打断
对于超时的子进程,调用 p.terminate() 发送 SIGTERM 信号(在 Windows 上对应 TerminateProcess API)。在 Python 3.7 及更高版本中,若子进程依然没有退出,还可以进一步调用 p.kill() 发送更为强硬的 SIGKILL 信号。
4. 步骤四:二次短时 join 与 close 彻底清理
执行 terminate() 只是向子进程发送了终止信号,子进程在被操作系统回收时,其退出代码(Exit Code)仍然保存在内核的进程描述符中。如果主进程不再调用 join(),该子进程就会变成系统中的僵尸进程(Zombie Process / <defunct>)。因此,打断后必须再执行一次简短的 p.join(timeout=1.0) 完成收尸,并在 Python 3.7+ 中调用 p.close() 释放进程内部的系统资源句柄。
三、生产级完整代码示例与运行验证
以下为一个可直接执行的完整 Python 示例,模拟了正常任务与超时异常任务的并发处理,展示了完整的超时控制与异常回收体系:
import multiprocessing
import time
import os

def worker_task(task_name: str, duration: int):
    """
    模拟子进程工作函数
    :param task_name: 任务名称
    :param duration: 模拟执行耗时(秒)
    """
    pid = os.getpid()
    print(f"[子进程启动] 任务: {task_name}, PID: {pid}, 预计耗时: {duration}秒")
    try:
        # 模拟可能阻塞的计算或网络IO
        time.sleep(duration)
        print(f"[子进程完成] 任务: {task_name}, PID: {pid} 执行完毕")
    except Exception as e:
        print(f"[子进程异常] 任务: {task_name}, PID: {pid} 遭遇错误: {e}")

def run_process_with_timeout(name: str, run_time: int, max_wait: float):
    """
    带超时保护的子进程执行器
    """
    print(f"\n--- 开始调度任务: {name} (超时阈值: {max_wait}秒) ---")
    p = multiprocessing.Process(target=worker_task, args=(name, run_time))
    p.start()

    # 第一步:指定超时时限的 join
    p.join(timeout=max_wait)

    # 第二步:探测是否仍在运行
    if p.is_alive():
        print(f"[超时告警] 任务 {name} (PID: {p.pid}) 超过最大限制 {max_wait}秒,仍处于存活状态!")

        # 第三步:强制打断
        print(f"[强制清理] 正在发送 terminate 信号终止子进程 {p.pid}...")
        p.terminate()

        # 第四步:二次短时等待回收僵尸资源
        p.join(timeout=1.0)
        print(f"[清理完毕] 子进程 {p.pid} 已回收,退出码: {p.exitcode}")
    else:
        print(f"[正常退出] 任务 {name} (PID: {p.pid}) 在超时时限内顺利完成,退出码: {p.exitcode}")

    # 关闭进程句柄,释放系统资源(Python 3.7+)
    if hasattr(p, 'close'):
        p.close()

if __name__ == "__main__":
    multiprocessing.freeze_support()

    # 场景 1:任务在 2 秒内完成,预设超时 4 秒(正常场景)
    run_process_with_timeout("正常数据汇总", run_time=2, max_wait=4.0)

    # 场景 2:任务需要 10 秒,预设超时 3 秒(触发超时终止)
    run_process_with_timeout("卡滞的外部同步", run_time=10, max_wait=3.0)

    print("\n所有主控流程执行完毕,主进程安全退出。")
示例运行结果说明
运行上述代码时,控制台将输出清晰的阶段日志。可以看到在任务二发生卡死时,主进程在设定的 3.0 秒准时苏醒,执行清理并平稳退出,未发生任何全局阻塞:
--- 开始调度任务: 正常数据汇总 (超时阈值: 4.0秒) ---
[子进程启动] 任务: 正常数据汇总, PID: 34102, 预计耗时: 2秒
[子进程完成] 任务: 正常数据汇总, PID: 34102 执行完毕
[正常退出] 任务: 正常数据汇总 (PID: 34102) 在超时时限内顺利完成,退出码: 0

--- 开始调度任务: 卡滞的外部同步 (超时阈值: 3.0秒) ---
[子进程启动] 任务: 卡滞的外部同步, PID: 34103, 预计耗时: 10秒
[超时告警] 任务: 卡滞的外部同步 (PID: 34103) 超过最大限制 3.0秒,仍处于存活状态!
[强制清理] 正在发送 terminate 信号终止子进程 34103...
[清理完毕] 子进程 34103 已回收,退出码: -15

所有主控流程执行完毕,主进程安全退出。
terminate() 发送的是 SIGTERM 信号,子进程的退出码通常为负值(例如 -15 对应信号 15)。这是子进程被主动打断的标准退出表现。
四、引发 join 卡死的深层诱因:Queue 缓冲区死锁剖析
除了子进程自身的业务死循环外,很多开发者遇到最隐蔽的 join() 卡死问题,实际上源于多进程队列 multiprocessing.Queue 的底层机制。
在 Python 中,multiprocessing.Queue 并不是纯粹的内存列表,它依赖操作系统底层的管道(Pipe)与后台刷新线程(Feeder Thread)工作。操作系统为管道分配的缓冲区是有限的(在大多数 Linux 系统上通常为 64KB)。如果子进程往队列中放入了大量数据(例如大字典或大图片),且数据体积超过了管道缓冲区容量,子进程的 q.put() 操作就会被内核挂起,等待读取端消费并释放管道空位。
p.join() 等待子进程退出,打算在 join() 之后再去 q.get() 读取数据。这就形成了死锁:子进程在等主进程取数据以腾出管道空位;主进程在等子进程结束才开始取数据。
五、多进程超时控制的选型与决策指南
在实际工程中,除了直接控制单个 multiprocessing.Process 外,很多项目还会使用进程池 multiprocessing.Pool 或标准库的 concurrent.futures.ProcessPoolExecutor。在不同的多进程模型下,超时参数的调用点完全不同:
| 多进程管理模型 | 典型同步方法 | 超时参数使用方式 | 超时处理动作 |
|---|---|---|---|
| Process 单实例 | p.join() |
p.join(timeout=秒数) |
检查 p.is_alive(),若存活则 p.terminate(),随后二次 join。 |
| multiprocessing.Pool | pool.join()(无 timeout 参数) |
对任务调用 res = pool.apply_async(...),随后使用 res.get(timeout=秒数) |
捕获 multiprocessing.TimeoutError 异常,必要时执行 pool.terminate() 重置进程池。 |
| ProcessPoolExecutor | future.result() |
future.result(timeout=秒数) |
捕获 concurrent.futures.TimeoutError 异常,取消尚未开始的任务并记录告警。 |
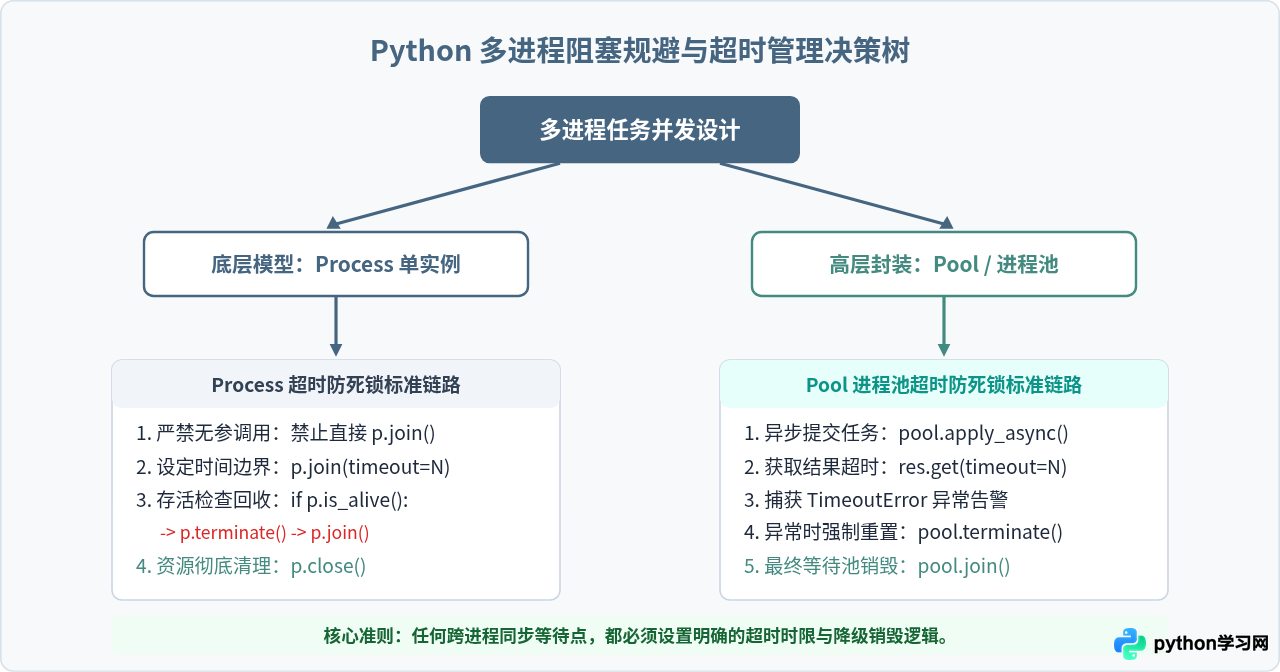
六、核心总结与日常排查备忘清单
解决 Python 多进程 join() 卡死的关键,在于打破“假设子进程一定会正常结束”的脆弱假设。在编写任何多进程代码时,建议对照以下备忘清单检查:
- 等待必设时限:只要调用
join(),就必须指定timeout参数(如p.join(timeout=10.0)),永远不要在无监控保护的生产环境中使用裸join()。 - 超时必查存活:调用带有 timeout 的 join 之后,紧随
if p.is_alive():进行判断,未超时的正常流转,超时的进入异常处置流。 - 打断必做收尾:对超时子进程执行
terminate()之后,务必再加一段短时join(timeout=1.0),读取子进程退出状态,杜绝僵尸进程污染系统进程表。 - 通信先读后等:如果使用了
Queue交换大批量数据,务必先在循环中消费数据,或者在子进程中将大结果存入临时文件/数据库仅传递指针,防止管道缓冲满溢引发的底层死锁。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









