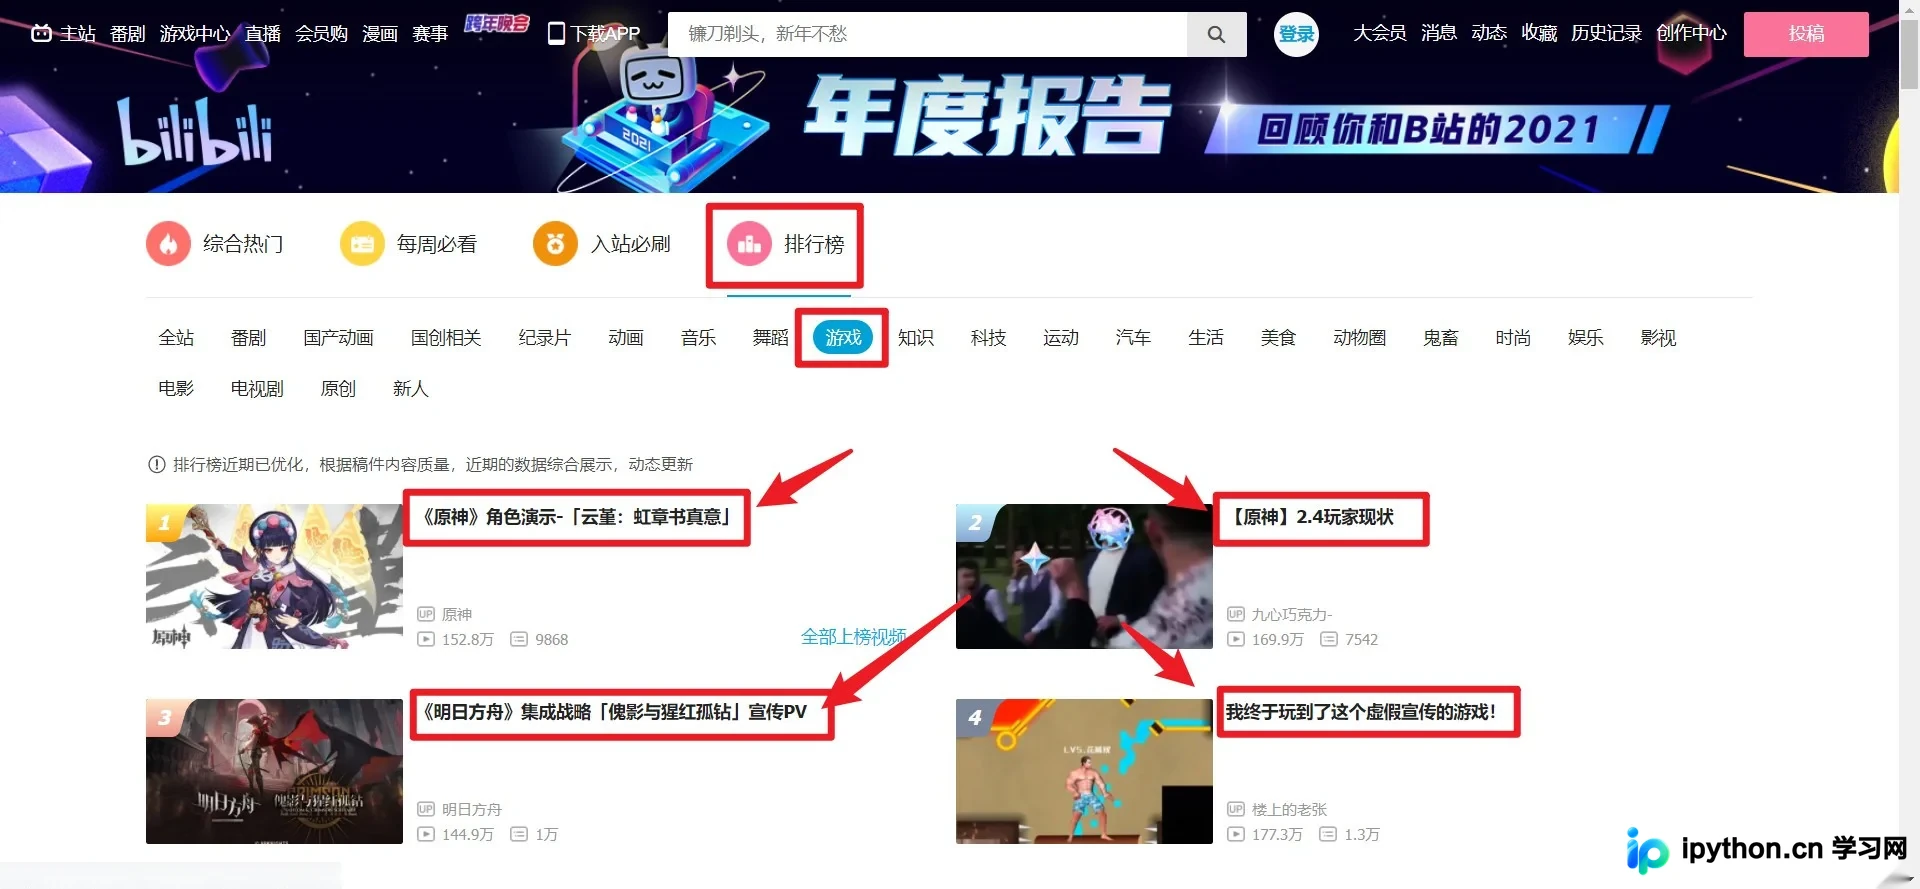
Python爬虫实战:抓取Bilibili游戏排行榜标题与链接
本文介绍如何使用Python的Requests和BeautifulSoup库,从Bilibili游戏排行榜页面抓取视频标题及对应链接。通过逐步优化代码,解决HTML解析、链接协议补全(http:)及数据提取问题,最终实现简洁高效的数据爬取,适合Python初学者参考学习。
2026-10-12
6

本文介绍如何使用Python的Requests和BeautifulSoup库,从Bilibili游戏排行榜页面抓取视频标题及对应链接。通过逐步优化代码,解决HTML解析、链接协议补全(http:)及数据提取问题,最终实现简洁高效的数据爬取,适合Python初学者参考学习。
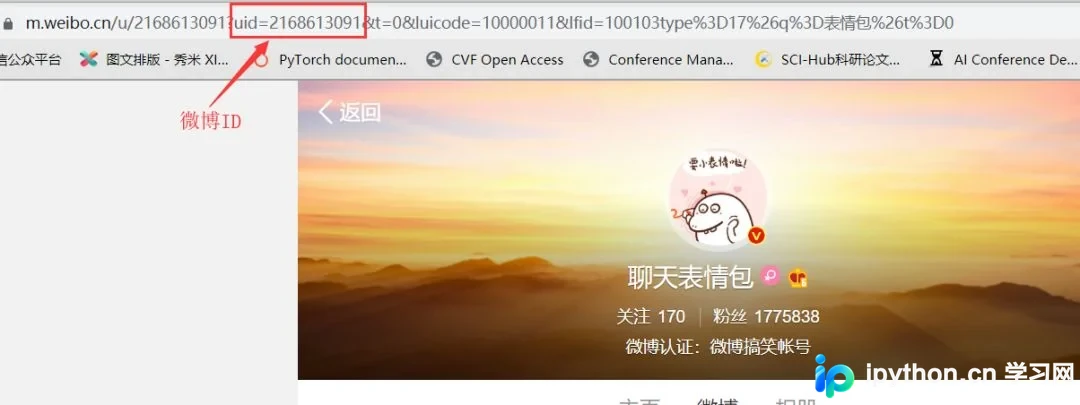
本文介绍使用Python 3.6.4通过DecryptLogin模块模拟登录微博,并抓取指定用户发布的表情包图片。文章详细讲解了环境搭建、异步爬取被封禁的教训、以及采用随机延迟和独立UA请求等反封禁策略。通过XPath提取用户信息及图片链接,并对HTTP链接错误进行后处理,最终实现稳定下载。
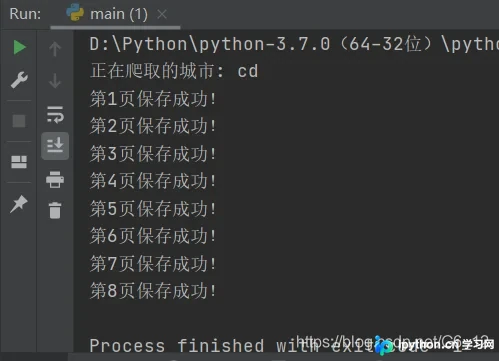
本文详细介绍如何利用Python的urllib.request库实现贝壳找房房源数据的自动化爬取。教程涵盖请求库引入、URL构建、随机代理IP配置及反爬策略(如随机休眠),并通过完整代码示例演示如何批量保存不同城市的多页网页数据,为后续大数据分析提供数据源。
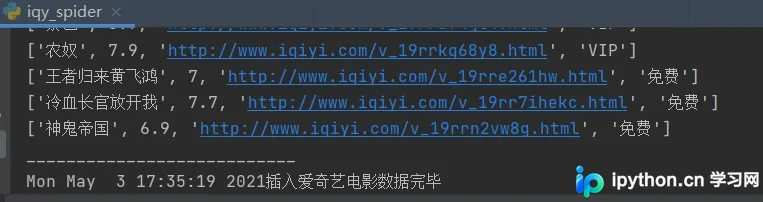
本文详细介绍使用Python爬取爱奇艺电影片库首页数据的完整流程。通过Requests获取HTML,结合Lxml和BeautifulSoup解析电影标题、评分及链接等关键信息。代码示例展示了如何连接MySQL数据库,将抓取到的电影数据批量插入数据库,并包含异常处理与事务提交机制,为影视数据抓取与存储提供实用参考。
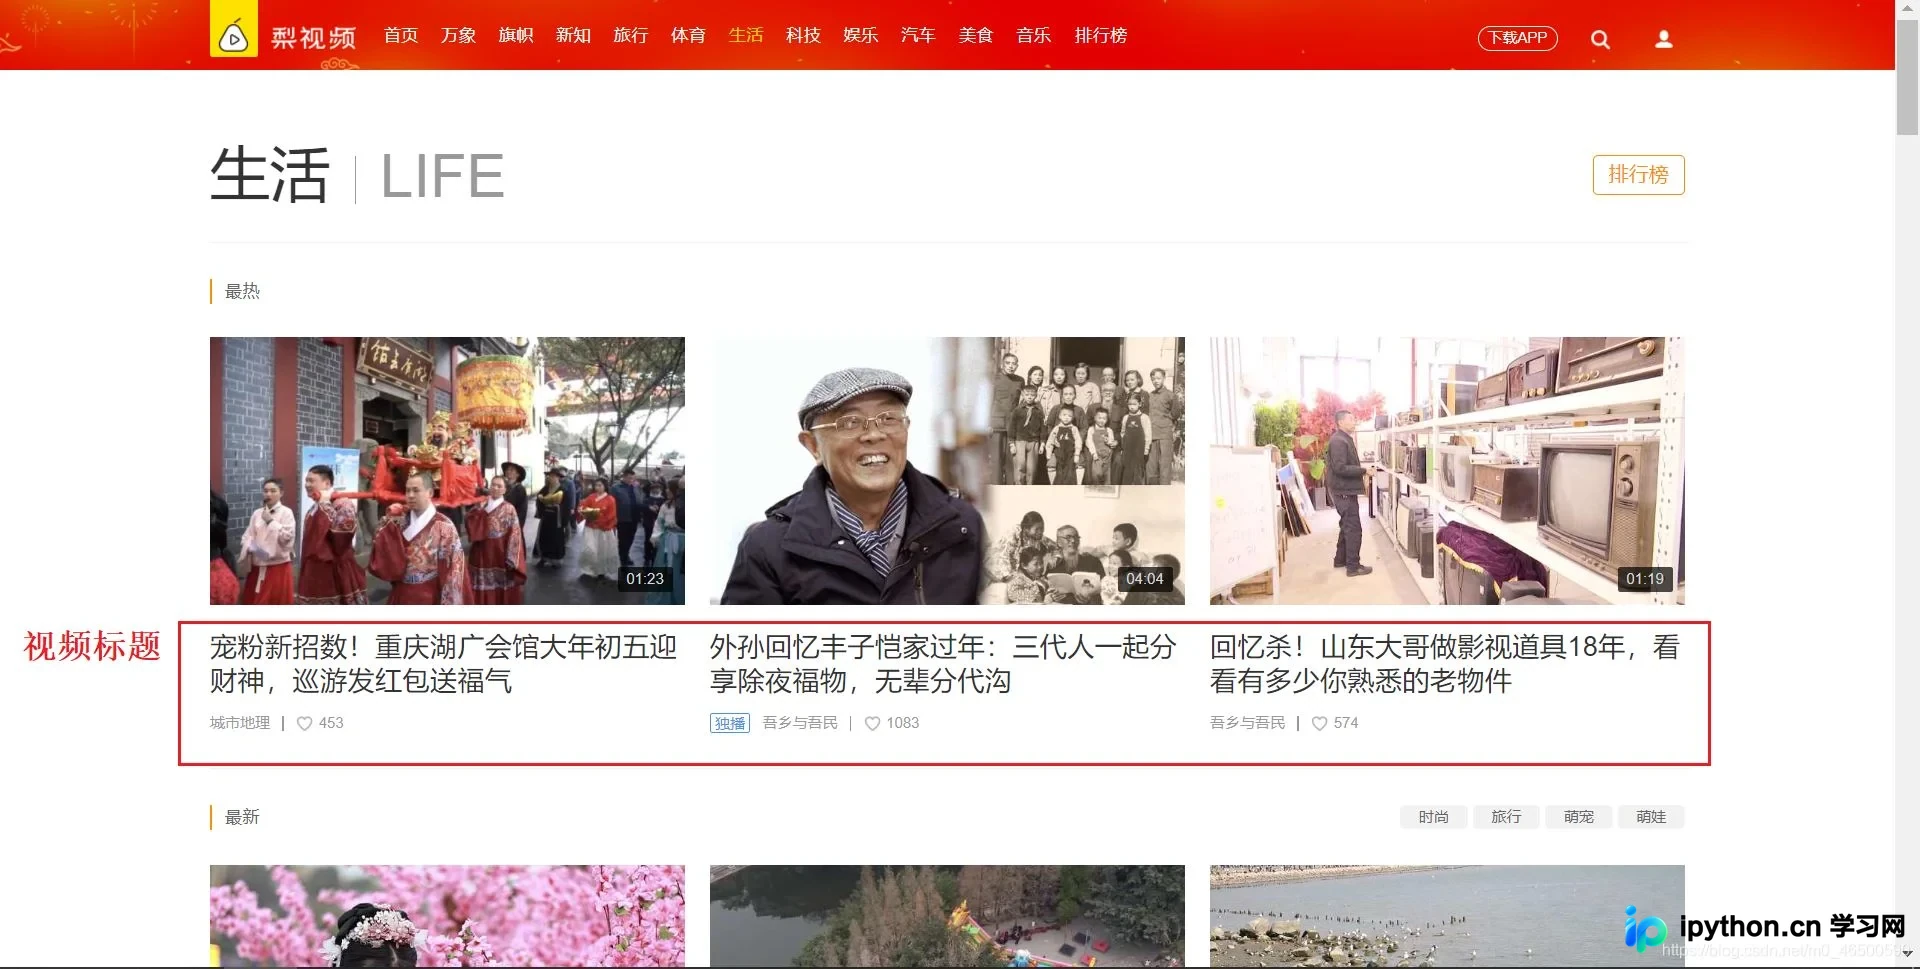
本文基于Scrapy框架解析梨视频网站的数据抓取流程。针对视频标题与描述分属不同页面的特点,通过自定义parse方法与meta参数传递Item对象,实现跨页面数据解析。结合items定义字段与pipeline管道类,完成数据的清洗、持久化存储及多管道优先级处理,提供完整的代码示例与配置说明。
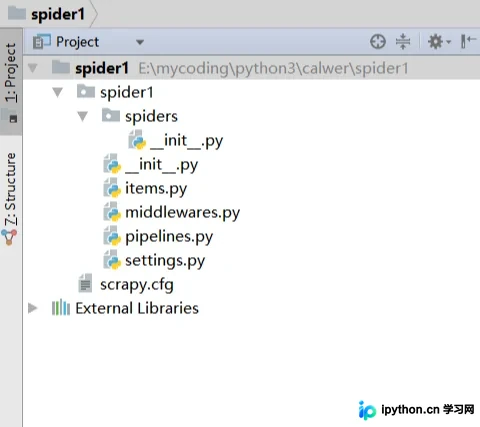
本文详细讲解如何利用Python Scrapy框架搭建电影数据爬虫。内容涵盖项目初始化命令、核心文件功能解析、Spider类的定义规范(包括name、allowed_domains等属性),以及通过XPath提取电影名称与评分的具体代码实现,帮助开发者快速掌握Scrapy基础用法。
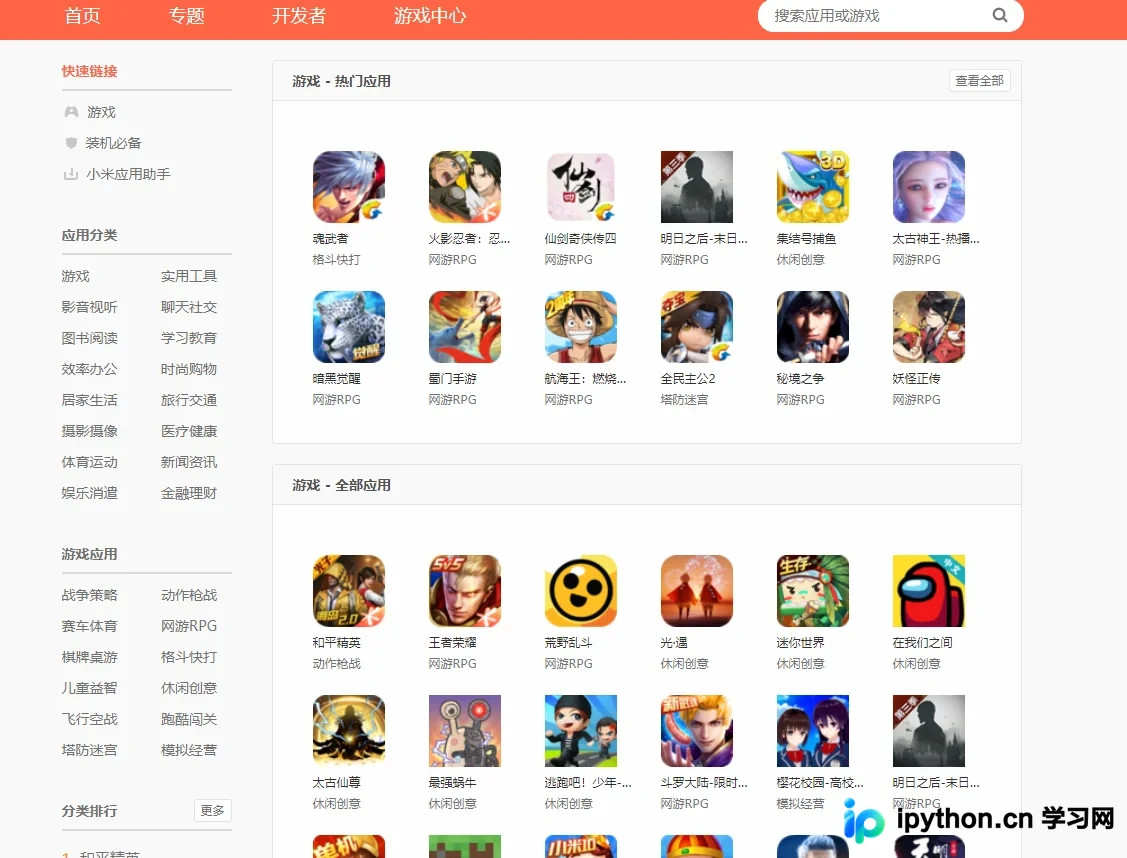
本文详解如何利用Python多线程技术高效抓取小米应用商店数据。通过分析动态加载接口,使用requests、threading和queue库构建爬虫,实现聊天社交类应用名称与链接的快速批量获取,并展示控制台输出结果及执行时间统计。
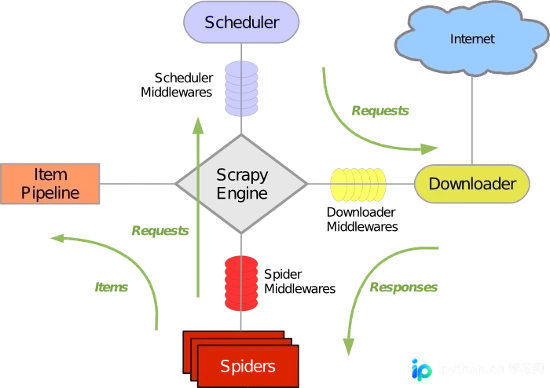
本文详细解析Python爬虫框架Scrapy的核心架构与运行机制。文章系统介绍了Scrapy Engine、Scheduler、Downloader、Spiders及Item Pipeline等关键组件的功能,并梳理了从URL请求到数据存储的完整数据处理流程。同时探讨了基于Twisted的事件驱动模型及各类中间件的作用,帮助开发者深入理解Scrapy的高效抓取原理。
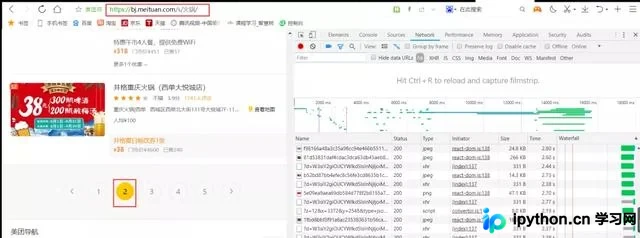
本文详解如何使用Python爬取美团美食数据。通过分析北京火锅搜索的URL结构,利用F12开发者工具定位Ajax异步加载的JSON接口。重点解析offset、limit等分页参数规律,构造请求循环抓取多页数据,并保存为本地文本文件,提供完整的代码实现与注意事项。
本文详细解析Python网络爬虫的基本工作原理及系统架构。从发起请求、获取响应、解析内容到保存数据四个步骤阐述抓取流程,并深入剖析调度器、URL管理器、下载器、解析器及存储器五大核心模块的功能与协作机制,旨在帮助开发者构建高效、模块化的爬虫系统。

本文详细介绍如何利用Python3的urllib库编写爬虫程序,从百度贴吧页面中提取邮箱地址和QQ号码。内容涵盖基础抓取代码逻辑、正则表达式匹配技巧,以及重点解析如何配置HTTP代理(Proxy)以规避访问限制。通过实例代码演示全局Opener设置与局部调用的区别,帮助开发者掌握更灵活的代理控制方法,提升爬虫稳定性。
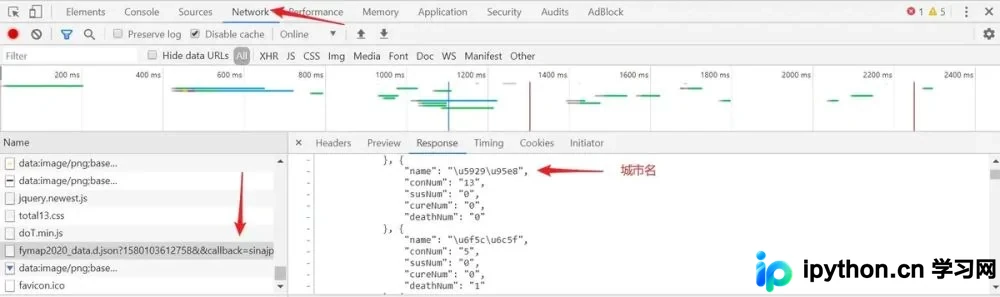
本文介绍如何利用Python抓取实时疫情数据,并通过pyecharts库绘制可视化地图。通过Chrome开发者工具定位JSON接口,解析包含确诊、治愈及死亡人数的数据,最终生成支持省、市级别的交互式疫情分布图,帮助直观掌握各地疫情状况。