

Python爬虫实战:抓取Bilibili游戏排行榜标题与链接

本文介绍如何使用Python的Requests和BeautifulSoup库,从Bilibili游戏排行榜页面抓取视频标题及对应链接。通过逐步优化代码,解决HTML解析、链接协议补全(http:)及数据提取问题,最终实现简洁高效的数据爬取,适合Python初学者参考学习。
本教程演示如何利用Python爬虫技术,获取Bilibili网站游戏类排行榜中的所有视频名称及其跳转链接。
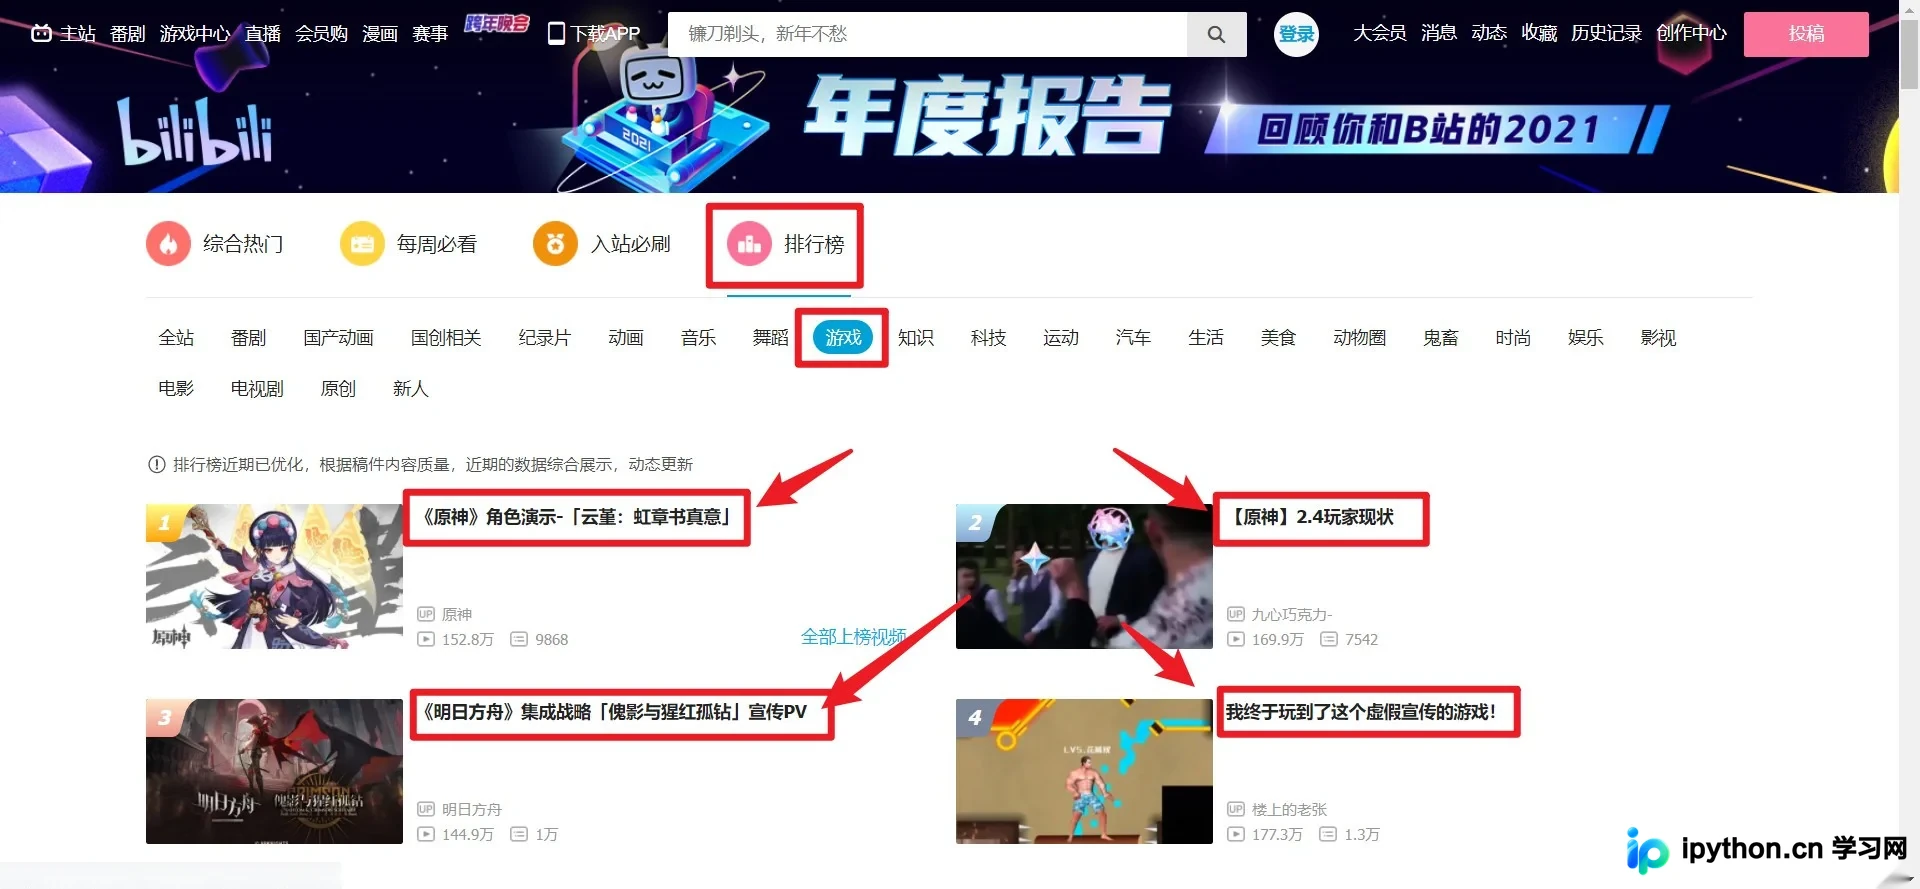
首先导入requests用于发起网络请求,以及BeautifulSoup用于解析HTML文档。
import requests
from bs4 import BeautifulSoup
接下来,我们需要构造目标网站的URL,发送请求并获取网页内容,随后进行解析并将结果打印输出。
e = requests.get('https://www.bilibili.com/v/popular/rank/game')   #当前网站链接
html = e.content
soup = BeautifulSoup(html,'html.parser')    #解析html
print(soup)
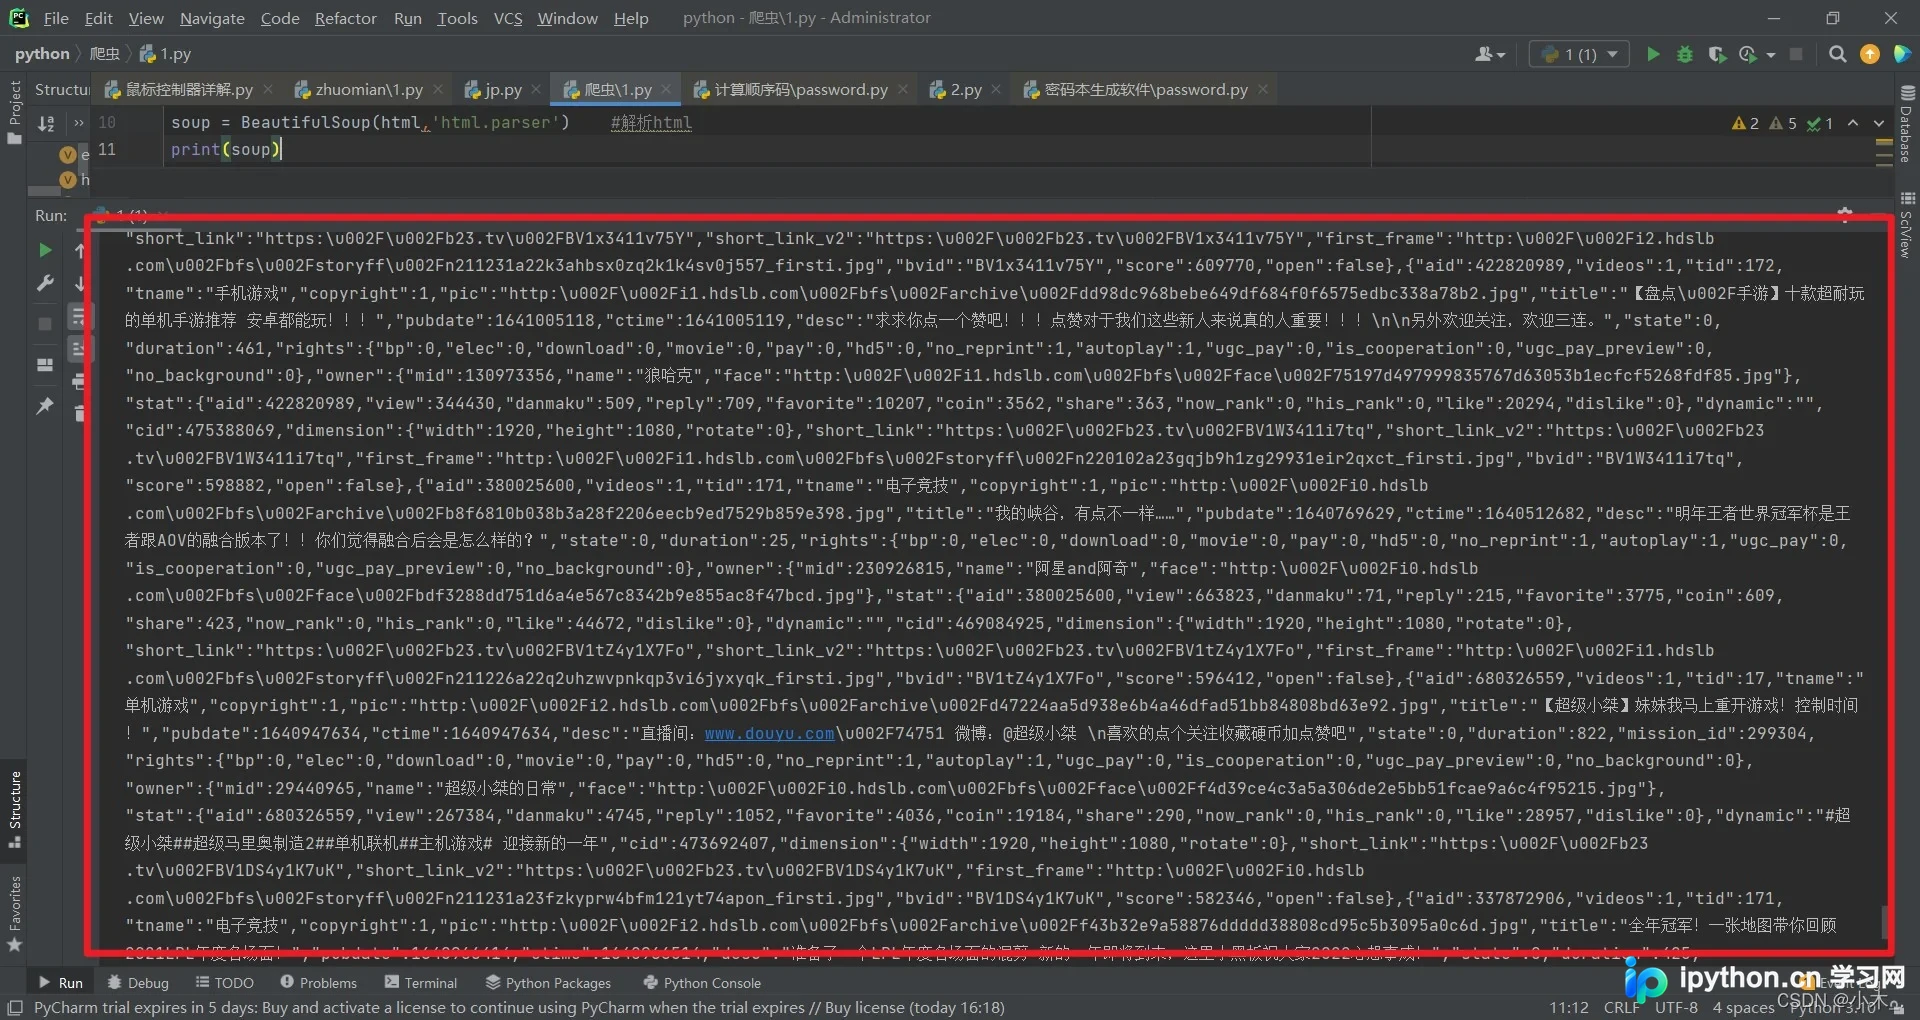
初步运行代码后,输出的HTML源码较为冗长且杂乱,不够直观。为了提高代码的可读性和效率,我们对代码进行优化。
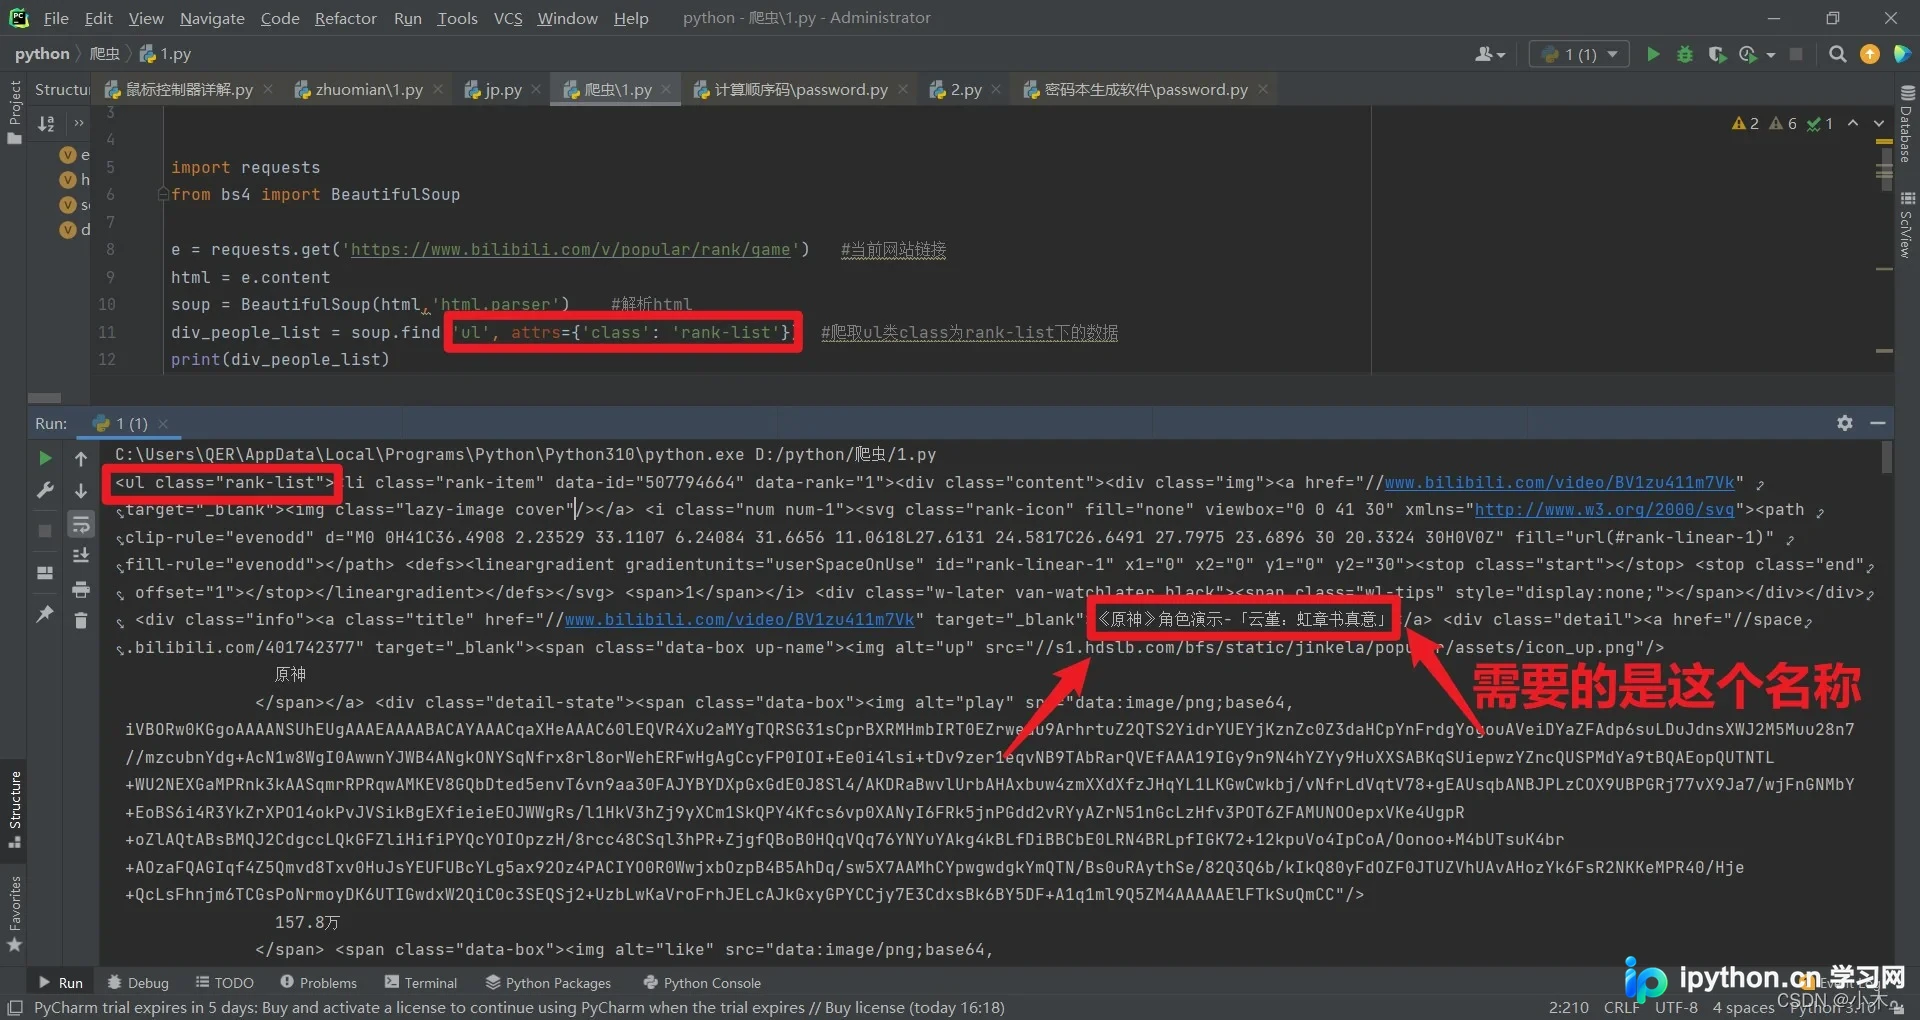
在原有基础上添加特定逻辑,专门针对目标数据类别进行提取,使代码结构更加简洁清晰。
div_people_list = soup.find('ul', attrs={'class': 'rank-list'}) #爬取ul类class为rank-list下的数据
观察优化后的输出结果,发现虽然部分数据已提取,但格式仍不够简洁明了。
继续完善代码逻辑,具体实现如下:
ca_s = div_people_list.find_all('a', attrs={'class': 'title'}) #爬取a类class为title下的数据
此时,视频链接和标题已成功提取,但仔细观察会发现存在细节瑕疵。
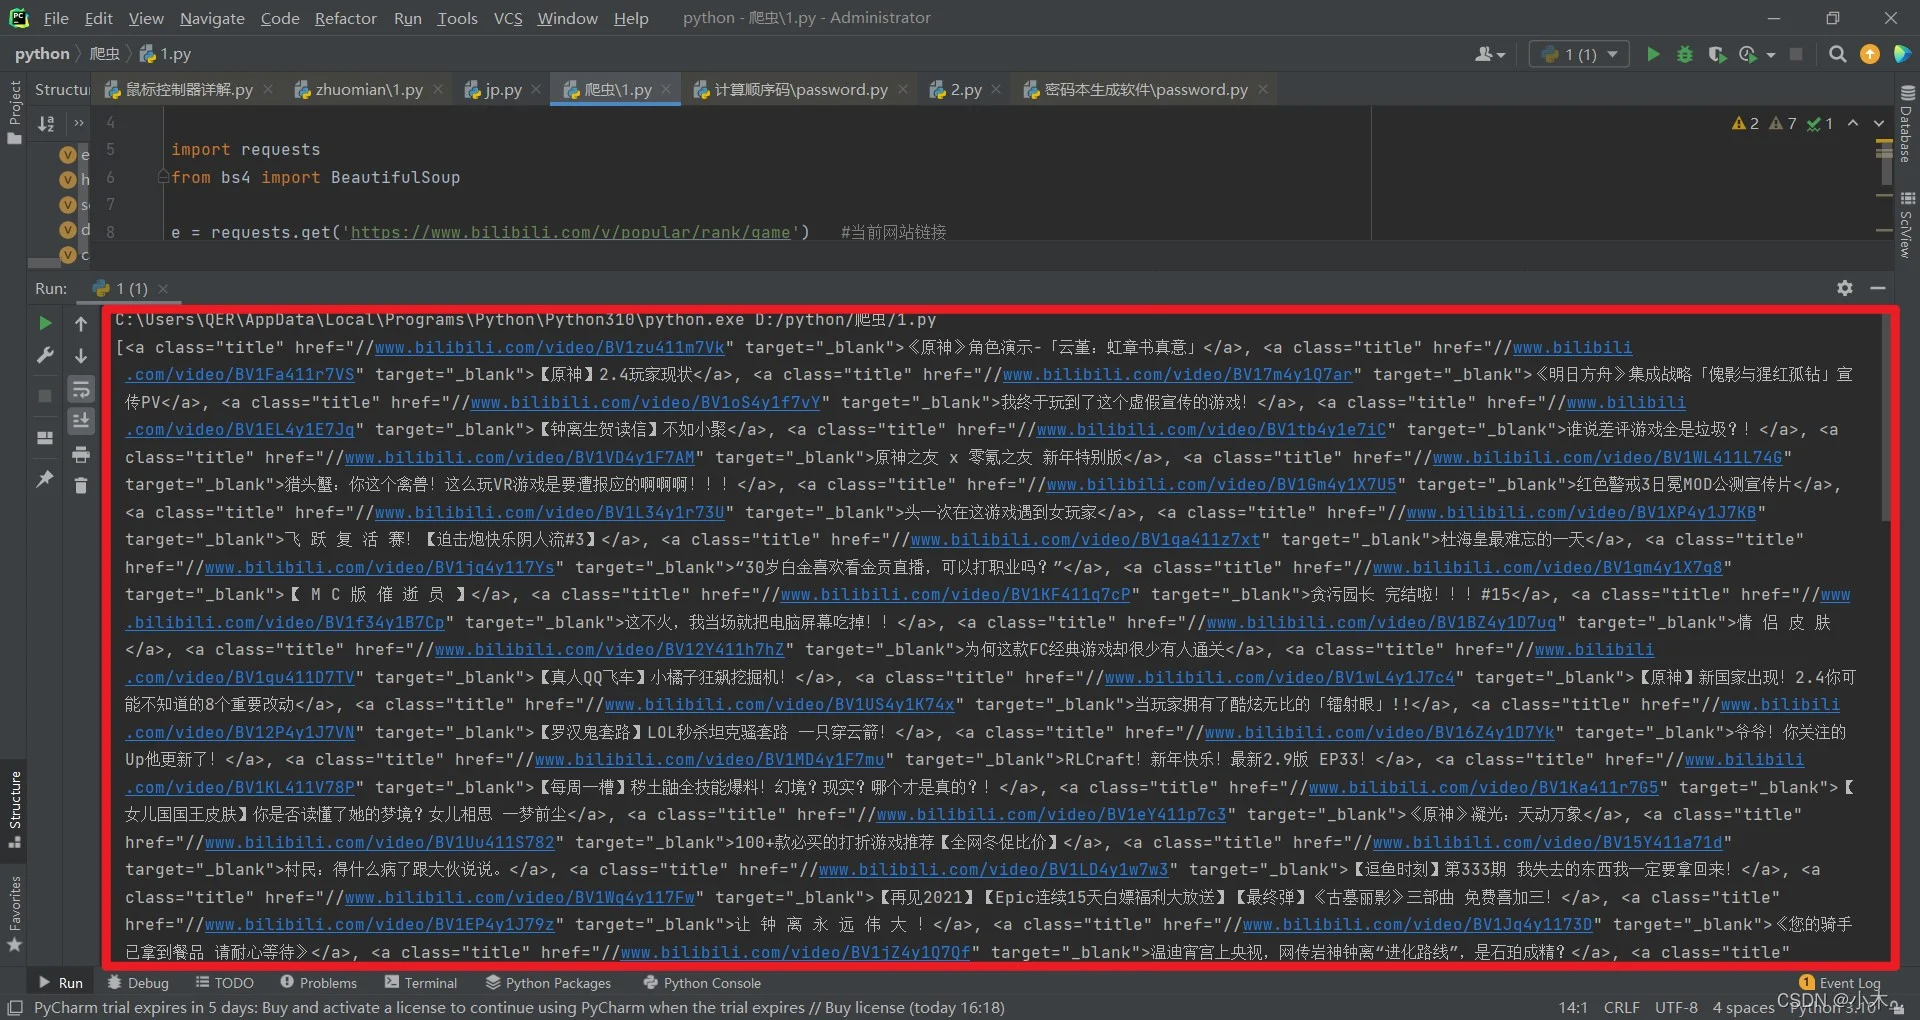
我们添加代码遍历提取结果,逐个打印标题和链接。注意,此时提取的链接格式为//www.bilibili.com/video/BV1yZ4y1D7ef。
由于上述链接缺少前缀协议(http:),直接点击可能导致错误。因此,我们需要在链接前手动拼接'http:',确保链接完整后可正常访问,并打印最终结果。
for t in ca_s:
    url = t['href']
    name = t.get_text()
    print(name+'\t点击链接直接观看链接:'+f'http:{url}')
运行优化后的代码,可以看到视频标题和完整的可点击链接均已成功爬取并显示。
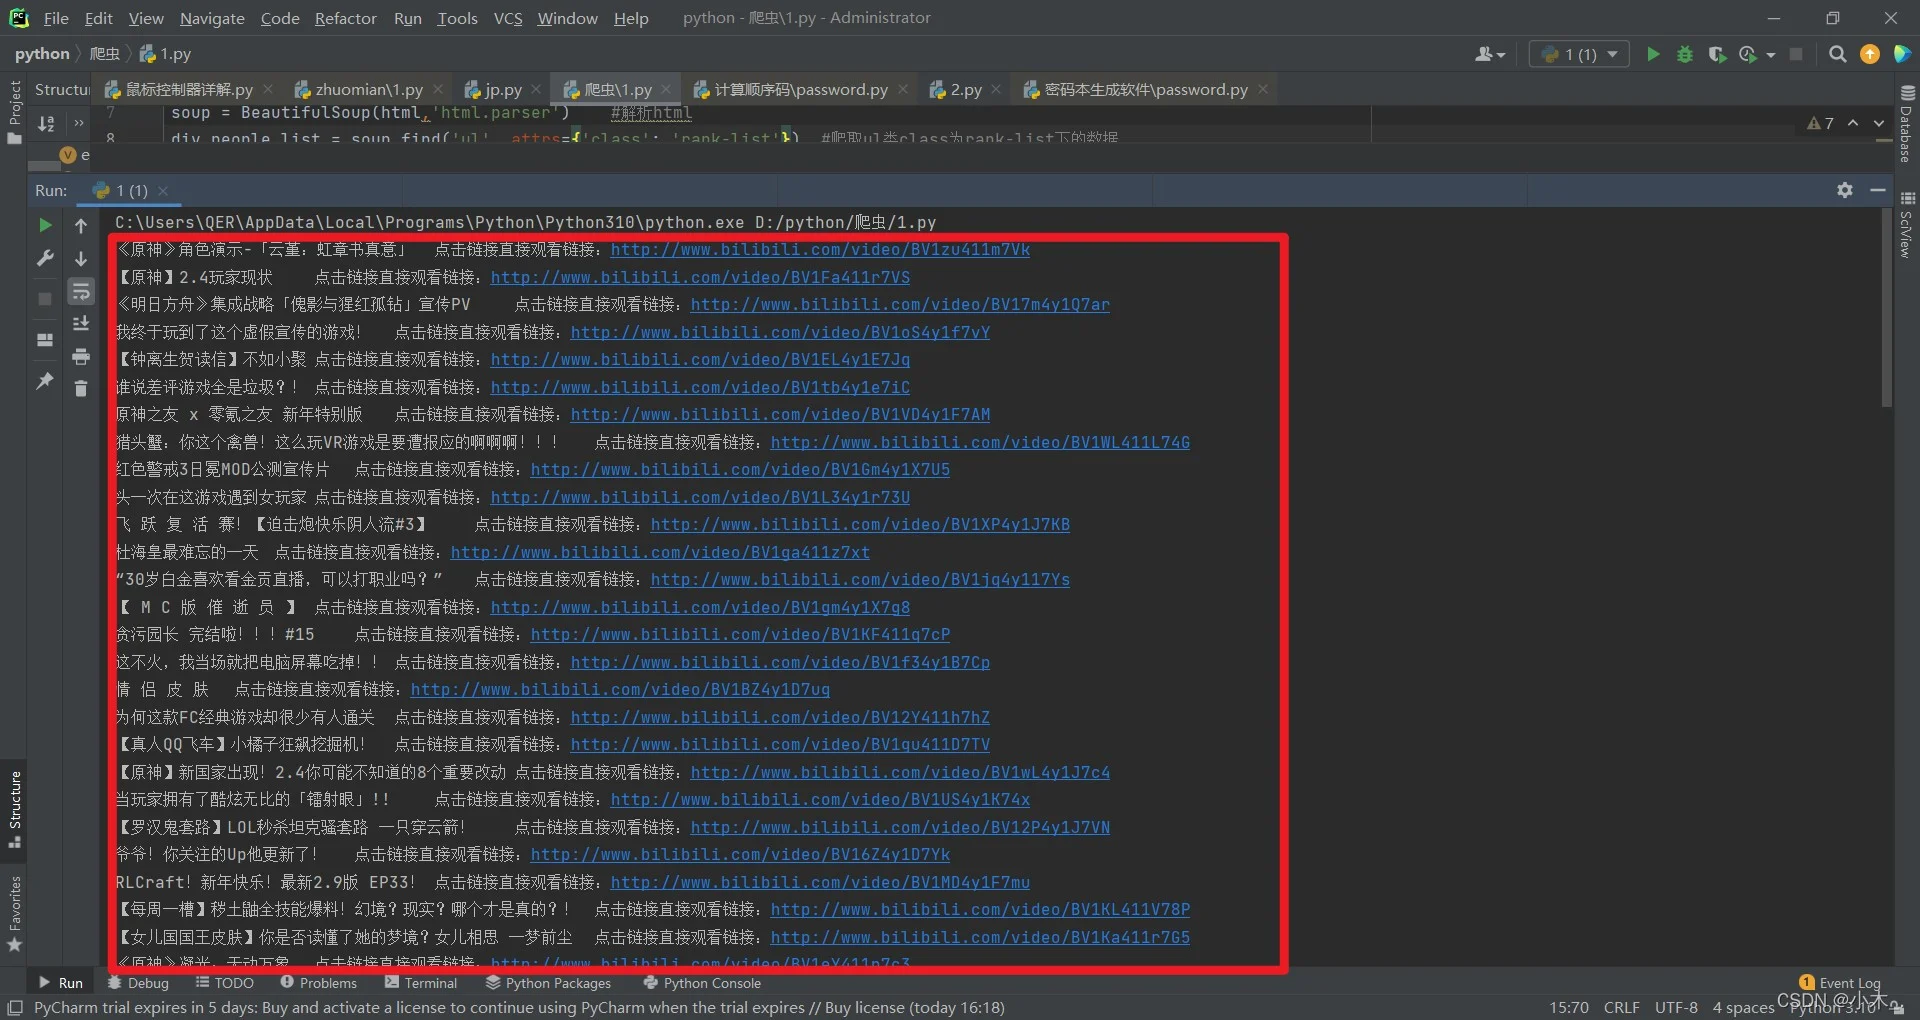
以下是完整的实现代码:
import requests
from bs4 import BeautifulSoup

e = requests.get('https://www.bilibili.com/v/popular/rank/game')   #当前网站链接
html = e.content
soup = BeautifulSoup(html,'html.parser')    #解析html
div_people_list = soup.find('ul', attrs={'class': 'rank-list'})  #爬取ul类class为rank-list下的数据
ca_s = div_people_list.find_all('a', attrs={'class': 'title'})   #爬取a类class为title下的数据

#挨个传输到t,然后打印数据
for t in ca_s:
    url = t['href']
    name = t.get_text()
    print(name+'\t点击链接直接观看链接:'+f'http:{url}')
至此,关于使用Python爬虫获取Bilibili网页基本内容的教程介绍完毕。如需了解更多相关Python爬取Bilibili内容的技巧,欢迎查阅本站往期文章或继续浏览后续内容。感谢大家的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









