

Python实现酷狗音乐TOP500及飙升榜数据抓取教程
本文详细介绍使用Python获取酷狗音乐TOP500榜单中歌曲MP3格式下载地址的方法,提供完整代码示例。针对部分页面规律失效导致无法完整爬取的问题,文章提供了转向爬取酷狗飙升榜100首的替代方案,包含API请求与网页解析两种实现路径,帮助开发者解决数据抓取中的跳转与完整性难题。
2026-10-13
6

本文详细介绍使用Python获取酷狗音乐TOP500榜单中歌曲MP3格式下载地址的方法,提供完整代码示例。针对部分页面规律失效导致无法完整爬取的问题,文章提供了转向爬取酷狗飙升榜100首的替代方案,包含API请求与网页解析两种实现路径,帮助开发者解决数据抓取中的跳转与完整性难题。
本文针对Python3爬虫抓取网页时出现的中文乱码问题,提供基于urllib库的编码处理方案。通过获取系统默认编码并手动解码响应内容,可有效解决数据展示异常,确保抓取结果正确显示中文。
本文介绍如何使用Python的requests库进行数据抓取。通过对比Java等语言,突出Python在集成工具库方面的便捷性。详细讲解了设置请求参数、Headers、代理以及处理不同响应格式(文本、JSON、二进制)的具体代码示例,帮助开发者快速上手网络爬虫开发。
本文汇总了基于Python3抓取多种非HTML文档的方法。涵盖TXT文件的正则检索、CSV文件的远程读取与字典解析、利用pdfminer3k提取PDF文本,以及通过解压DOCX文件并解析XML获取Word内容。文章提供具体代码示例,解决编码、远程加载及格式转换等常见问题,辅助开发者完善数据采集能力。
本文详细介绍如何利用Python的Requests库获取网页源码,并结合BeautifulSoup解析HTML结构以提取表格数据。通过定义检查链接、获取内容及保存文件三个核心函数,实现将网页中的表格信息清洗后写入本地CSV文件的完整流程,适合初学者参考学习。
本文介绍使用Python进行淘宝商品价格定向爬取的完整流程。通过requests库获取HTML源码,利用正则表达式提取价格和商品标题,并格式化输出结果。代码包含异常处理机制,适合初学者学习网络爬虫基础与数据解析技巧。
本文详解Python即时网络爬虫项目的启动背景,作者从C++转向Python的考量,以及“即时”在系统部署、数据流和模块集成层面的定义。项目旨在通过模块化提取器解决80%的数据抓取工作量,实现快速部署与批量数据收割。
本文介绍使用Python抓取多页天涯论坛帖子的实战技巧。重点解析BeautifulSoup中find_all与select的选择器差异,演示如何利用zip函数合并作者与内容数据,并构建双层URL结构实现分页抓取,同时探讨多属性筛选的可行性。
本文详细解析使用Python3爬取淘宝商品信息的完整代码流程。通过requests获取网页源码,利用正则表达式精准提取价格、名称、地址及图片链接,并展示如何遍历多页数据并格式化输出结果。代码包含异常处理机制,适合初学者理解网络爬虫的基本逻辑与实现细节。
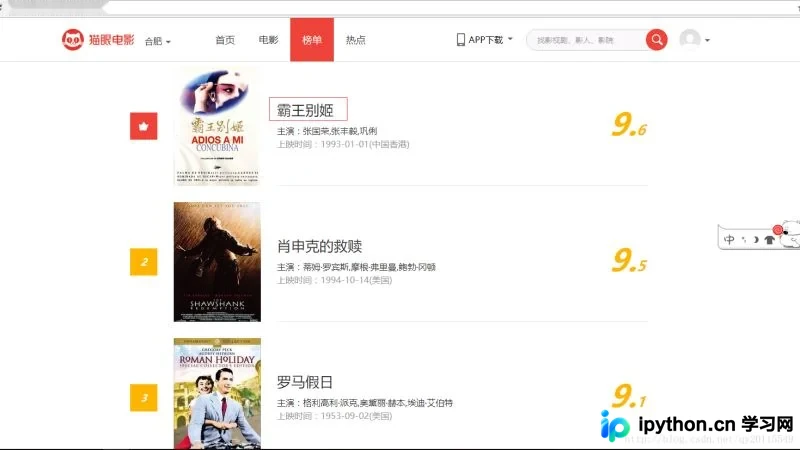
本文详细介绍如何使用Python的requests模块发起HTTP请求获取HTML源码,并结合BeautifulSoup库解析网页结构。通过抓取猫眼电影Top100榜单的具体案例,演示安装依赖、构造请求及提取电影标题与链接的完整流程,提供可直接运行的代码示例。
本文详细介绍如何利用Python解析HTML网页内容并生成Word文档。通过安装setuptools和python-docx组件,结合sgmllib与urllib获取数据,实现了从网页抓取到文档生成的自动化流程。文中提供了完整的代码示例及安装步骤,适用于需要批量处理网页数据并导出为Word格式的场景。
本文详细演示了使用Python进行数据抓取与分析的完整流程。通过requests获取页面,利用BeautifulSoup和XPath解析HTML及JS动态数据,并将结果存入MongoDB。文章涵盖分类网址获取、产品详情页抓取、数据清洗入库及异常处理等核心步骤,提供具体代码实现供参考。