Python爬虫实战:使用Requests与BS4抓取新浪新闻
本文详细介绍如何使用Python编写爬虫程序抓取新浪新闻。通过安装requests和bs4库,模拟浏览器请求获取原始数据,并解决常见的乱码问题。接着利用浏览器开发者工具定位HTML标签,结合BeautifulSoup解析提取新闻标题、发布时间及链接,最终实现结构化数据的自动采集。
2026-10-13
6

本文详细介绍如何使用Python编写爬虫程序抓取新浪新闻。通过安装requests和bs4库,模拟浏览器请求获取原始数据,并解决常见的乱码问题。接着利用浏览器开发者工具定位HTML标签,结合BeautifulSoup解析提取新闻标题、发布时间及链接,最终实现结构化数据的自动采集。
本文详细介绍利用Python爬虫下载网页中图片、文档等资源的三种方法。通过解析网页源码获取资源URL,分别演示了使用urllib.urlretrieve直接下载、requests库同步全量下载以及开启stream参数进行分块写入的实现代码。重点解析了分块下载在处理大文件时节省内存的优势,并提供了批量下载多个资源的通用逻辑思路。
本文详解Python爬虫中如何使用代理IP防止IP被封。通过urllib.request的ProxyHandler构建自定义opener,并调用install_opener设置全局代理,使urlopen默认使用代理IP。文中涵盖HTTP/HTTPS代理设置、端口配置及常见连接拒绝错误的排查方法,帮助开发者实现稳定的数据抓取。
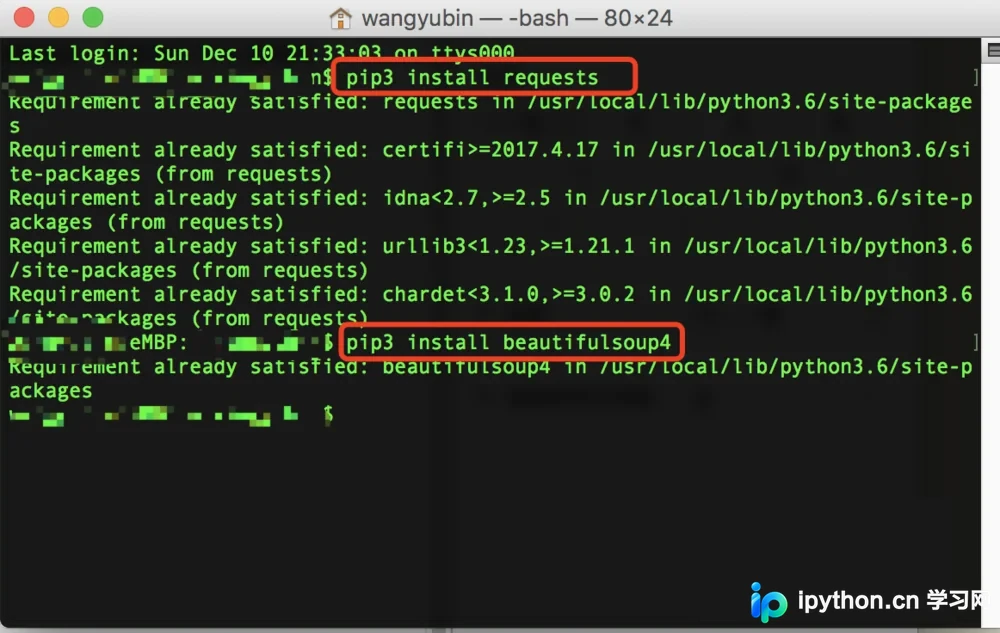
本文详细介绍Python中BeautifulSoup库的安装方法及基础使用。通过PyCharm自动安装bs4库,并演示如何将HTML源码转换为BeautifulSoup对象。文章解析了HTML标签的层级结构,讲解如何提取title等节点信息,并对比多种属性访问方式,帮助初学者快速掌握网页数据抓取的核心技巧。
本文介绍如何使用Python标准库urllib2模块发起URL请求并获取返回信息。通过urllib.urlencode处理参数,利用Request构建请求对象,最后调用urlopen读取响应内容。示例展示了如何向指定URL发送POST数据并打印返回结果,适用于基础的网络交互场景。
本文分享一段Python爬取链家租房信息的完整代码,涵盖从网页请求、数据解析到数据库存储的全流程。通过封装获取列表页链接与详情页信息的函数,结合SQL Server数据库操作,实现自动化数据采集。代码包含关键逻辑说明及错误处理思路,适合Python初学者参考学习。
本文针对Python3环境提供爬虫入门指南,对比Python2差异,推荐边学边做。通过抓取知乎首页源码演示urllib.request.urlopen()用法,解析HTML并处理编码,介绍爬虫流程及数据提取存储方法,帮助初学者快速上手。
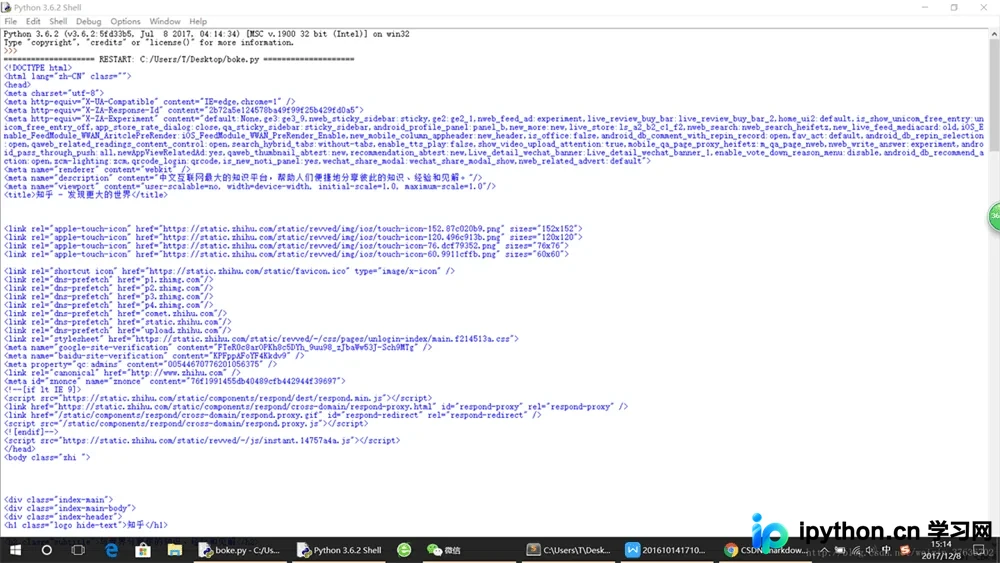
本文详细介绍如何使用Python3结合Requests和BeautifulSoup模块爬取赶集网列表数据。文章涵盖环境配置、模块安装及核心代码实现,通过构造请求头模拟浏览器访问,解析HTML并提取标题信息,帮助开发者快速掌握基础爬虫技巧。
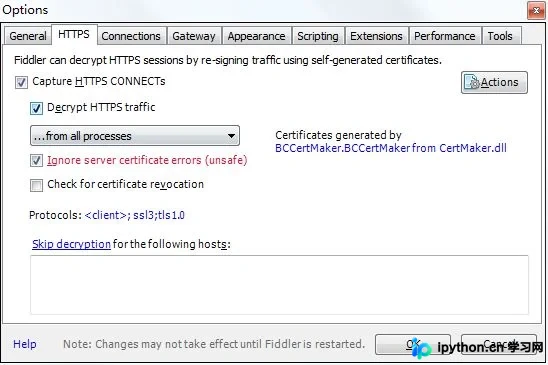
本文详细讲解如何使用Python3配合Fiddler工具抓取手机APP接口数据。内容涵盖Fiddler安装配置、手机代理设置、证书信任及抓包测试,并以王者荣耀盒子APP为例,演示如何解析英雄与装备接口数据,最终提供完整的Python爬取代码供参考。
本文介绍如何利用Python编写脚本爬取淘宝商品销量信息。通过指定关键词和分页参数,程序可自动获取商品列表并计算总销量。支持在代码中通过特定标记约束作者、时期等属性,适用于电商数据分析场景。
本文提供一段Python代码,演示如何抓取网易云音乐歌曲的热评。通过构造请求头与参数,利用requests库获取数据,并解析JSON提取用户昵称及评论内容,最终保存至本地文本文件。
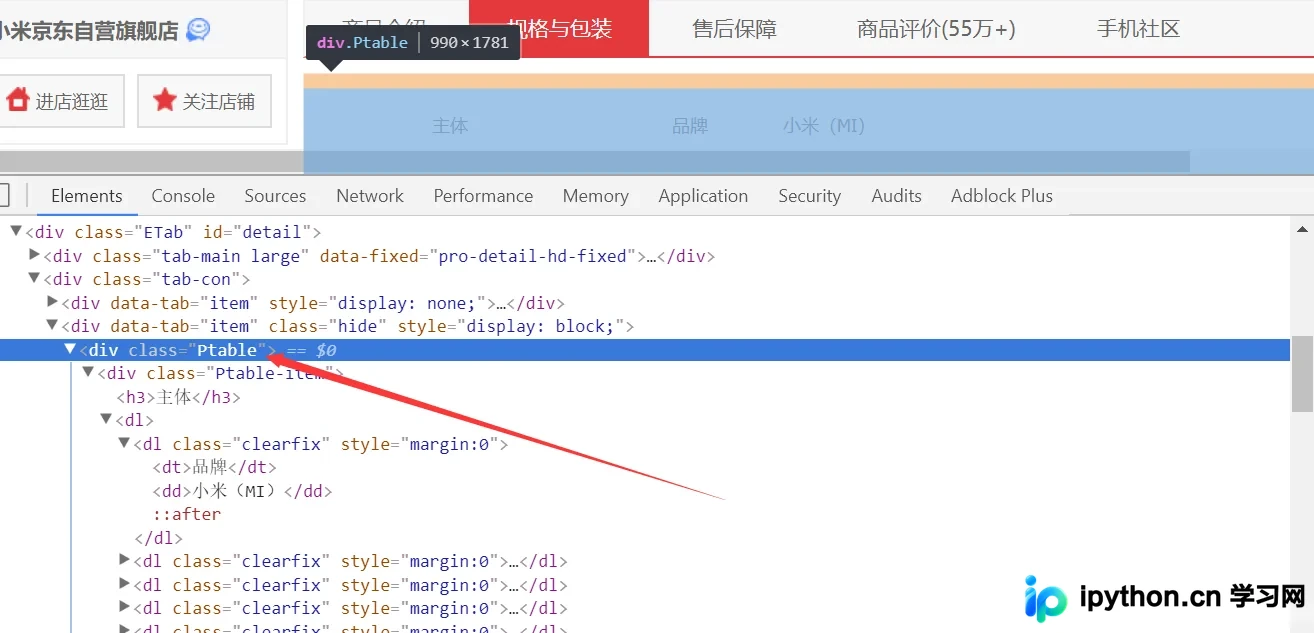
本文演示如何使用Python的requests库获取京东商品页面源码,并结合BeautifulSoup解析HTML结构。通过定位特定class的div容器,提取dl、dt和dd标签中的键值对数据,最终使用pandas构建DataFrame存储商品参数信息。