

Python爬虫实战:基于urllib.request爬取贝壳找房房源数据

发布时间:2026-10-12| 3人浏览过
本文详细介绍如何利用Python的urllib.request库实现贝壳找房房源数据的自动化爬取。教程涵盖请求库引入、URL构建、随机代理IP配置及反爬策略(如随机休眠),并通过完整代码示例演示如何批量保存不同城市的多页网页数据,为后续大数据分析提供数据源。
一、爬虫是什么?
在进行大数据分析或数据挖掘时,数据源通常来源于提供统计数据的网站、文献或内部资料。然而,这些渠道有时难以满足我们对数据的具体需求,而手动从互联网中搜集数据又耗费大量精力。此时,利用爬虫技术可以自动从互联网中获取感兴趣的数据内容,将其作为数据源进行更深层次的分析,从而挖掘出更多有价值的信息。在使用爬虫之前,首先需要掌握相关库(如或),这些库是专门为执行数据爬取任务而设计的。
二、使用步骤
1.引入库
代码如下(示例):
import os
import urllib.request
import random
import time
class BeikeSpider:
    def __init__(self, save_path="./beike"):
        """
        贝壳爬虫构造函数
        :param save_path: 网页保存目录
        """
2.读入数据
代码如下 :
# 网址模式
        self.url_mode = "http://{}.fang.ke.com/loupan/pg{}/"
        # 需爬取的城市
        self.cities = ["cd", "sh", "bj"]
        # 每个城市爬取的页数
        self.total_pages = 20
        # 让爬虫程序随机休眠5-10秒
        self.sleep = (5, 10)
        # 网页下载保存根目录
        self.save_path = save_path
        # 设置用户代理,是爬虫程序伪装成浏览器
        self.headers = {"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/89.0.4389.114 Safari/537.36"}
        # 代理IP的信息
        self.proxies = [
            {"https": "123.163.67.50:8118"},
            {"https": "58.56.149.198:53281"},
            {"https": "14.115.186.161:8118"}
        ]

        # 创建保存目录
        if not os.path.exists(self.save_path):
            os.makedirs(self.save_path)
   def crawl(self):
        """
        执行爬取任务
        :return: None
        """
该处使用的url网络请求的数据。
3.随机选择一个ip地址构建代理服务器
 for city in self.cities:
            print("正在爬取的城市:", city)
            # 每个城市的网页用单独的目录存放
            path = os.path.join(self.save_path, city)
            if not os.path.exists(path):
                os.makedirs(path)

            for page in range(1, self.total_pages+1):
                # 构建完整的url
                url = self.url_mode.format(city, page)
                # 构建Request对象, 将url和请求头放入对象中
                request = urllib.request.Request(url, headers=self.headers)

                # 随机选择一个代理IP
                proxy = random.choice(self.proxies)
                # 构建代理服务器处理器
                proxy_handler = urllib.request.ProxyHandler(proxy)
                # 构建opener
                opener = urllib.request.build_opener(proxy_handler)
                # 使用构建的opener打开网页
                response = opener.open(request)
                html = response.read().decode("utf-8")
                # 网页保存文件名(包含路径)
                filename = os.path.join(path, str(page)+".html")

                # 保存网页
                self.save(html, filename)
                print("第%d页保存成功!" % page)

                # 随机休眠
                sleep_time = random.randint(self.sleep[0], self.sleep[1])
                time.sleep(sleep_time)
该处除随机选择ip地址以外还会限制爬取数据的速度,避免暴力爬取。
4.运行代码
def save(self, html, filename):
        """
        保存下载的网页
        :param html: 网页内容
        :param filename: 保存的文件名
        :return:
        """

        f = open(filename, 'w', encoding="utf-8")
        f.write(html)
        f.close()

    def parse(self):
        """
        解析网页数据
        :return:
        """
        pass

if __name__ == "__main__":
    spider = BeikeSpider()
    spider.crawl()
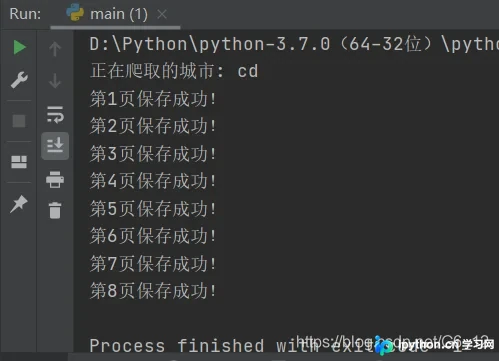
运行结果就会这样,会保存在你的文件夹中。
总结
这里对文章进行总结:今天分析这波代码目的是为了让大家清晰明亮的了解python爬虫的运作,和大家一起学习 以上就是今天要讲的内容,本文仅仅简单介绍了pandas的使用,而urllib.request提供了大量能使我们快速便捷地爬取数据。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









