

Python爬虫实战:解析美团美食数据接口与抓取流程

本文详解如何使用Python爬取美团美食数据。通过分析北京火锅搜索的URL结构,利用F12开发者工具定位Ajax异步加载的JSON接口。重点解析offset、limit等分页参数规律,构造请求循环抓取多页数据,并保存为本地文本文件,提供完整的代码实现与注意事项。
1.分析美团美食网页的url参数构成
1)搜索要点
以美团美食为例,设定地址为北京,搜索关键词为火锅。
2)爬取的url
https://bj.meituan.com/s/%E7%81%AB%E9%94%85/
3)说明
该URL包含自动编码中文的功能,其中“火锅”二字被转换为一串不可读的代码%E7%81%AB%E9%94%85。
通过观察城市与关键词在URL中的构造方式,可以解析出“bj”代表北京,“/s/”后跟随的是搜索关键词。
由此即可掌握当前URL的构造逻辑。
2.分析页面数据来源(F12开发者工具)
打开F12开发者工具并刷新当前页面。观察发现,切换到第二页时URL并未变化,网站也未进行整页刷新跳转。这正是Web中Ajax技术的典型特征:在保持页面不刷新、URL不变的前提下加载数据。
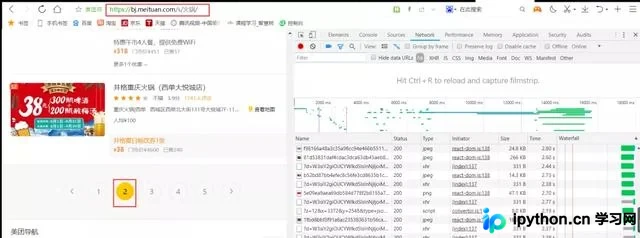
此时,需要在开发者工具中定位XHR(XMLHttpRequest)列表,找到对应当前页面数据的响应文件。
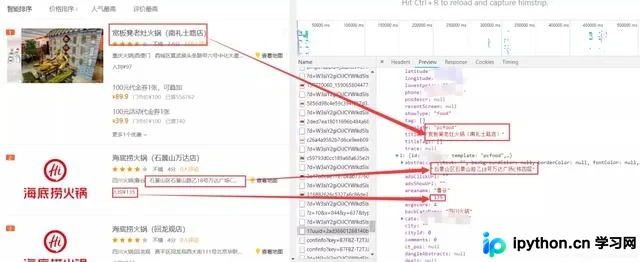
分析可知,数据交互采用JSON格式。接下来需分别分析第二页与第三页JSON文件的请求地址。
第二页请求地址:https://apimobile.meituan.com/group/v4/poi/pcsearch/1?uuid=xxx&userid=-1&limit=32&offset=32&cateId=-1&q=%E7%81%AB%E9%94%85
第三页请求地址:https://apimobile.meituan.com/group/v4/poi/pcsearch/1?uuid=xxx&userid=-1&limit=32&offset=64&cateId=-1&q=%E7%81%AB%E9%94%85
对比发现,offset参数在每次翻页时增加32;limit参数表示单次请求的数据量;offset代表数据请求的起始元素索引;q为搜索关键词。URL中poi/pcsearch/1后的“1”代表北京城市的ID编号。
3.构造请求抓取美团美食数据
接下来直接构造HTTP请求,通过循环访问每一页的数据,最终实现代码如下。
import requests
import re


def start():
  for w in range(0, 1600, 32):
  #页码根据实际情况x32即可,我这里是设置50页为上限,为了避免设置页码过高或者数据过少情况,定义最大上限为1600-也就是50页,使用try-except来检测时候异常,异常跳过该页,一般作为无数据跳过该页处理
    try:
    # 注意uuid后面参数空余将uuid后xxx替换为自己的uuid参数
      url = 'https://apimobile.meituan.com/group/v4/poi/pcsearch/1?uuid=xxx&userid=-1&limit=32&offset='+str(w)+'&cateId=-1&q=%E7%81%AB%E9%94%85'
      #headers的数据可以在F12开发者工具下面的requests_headers中查看,需要实现选择如下headers信息
      #必要情况 请求频繁 建议增加cookie参数在headers内
      headers = {
        'Accept': '*/*',
        'Accept-Encoding': 'gzip, deflate, br',
        'Accept-Language': 'zh-CN,zh;q=0.9',
        'Connection': 'keep-alive',
        'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/70.0.3538.25 Safari/537.36 Core/1.70.3741.400 QQBrowser/10.5.3863.400',
        'Host': 'apimobile.meituan.com',
        'Origin': 'https://bj.meituan.com',
        'Referer': 'https://bj.meituan.com/s/%E7%81%AB%E9%94%85/'
      }
      response = requests.get(url, headers=headers)
      #正则获取当前响应内容中的数据,因json方法无法针对店铺特有的title键值进行获取没所以采用正则
   titles = re.findall('","title":"(.*?)","address":"', response.text)
     addresses = re.findall(',"address":"(.*?)",', response.text)
     avgprices = re.findall(',"avgprice":(.*?),', response.text)
     avgscores = re.findall(',"avgscore":(.*?),',response.text)
     comments = re.findall(',"comments":(.*?),',response.text)
     #输出当前返回数据的长度 是否为32
     print(len(titles), len(addresses), len(avgprices), len(avgscores), len(comments))
     for o in range(len(titles)):
     #循环遍历每一个值 写入文件中
       title = titles[o]
       address = addresses[o]
       avgprice = avgprices[o]
       avgscore = avgscores[o]
       comment = comments[o]
       #写入本地文件
       file_data(title, address, avgprice, avgscore, comment)

#文件写入方法
def file_data(title, address, avgprice, avgscore, comment):
  data = {
        '店铺名称': title,
        '店铺地址': address,
        '平均消费价格': avgprice,
        '店铺评分': avgscore,
        '评价人数': comment
      }
  with open('美团美食.txt', 'a', encoding='utf-8')as fb:
    fb.write(json.dumps(data, ensure_ascii=False) + '\n')
    #ensure_ascii=False必须加因为json.dumps方法不关闭转码会导致出现乱码情况
if __name__ == '__main__':
  start()
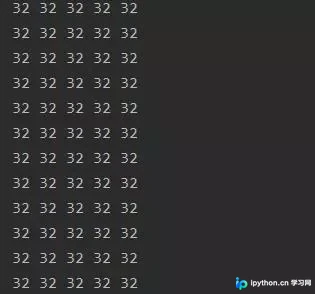
运行结果如下:
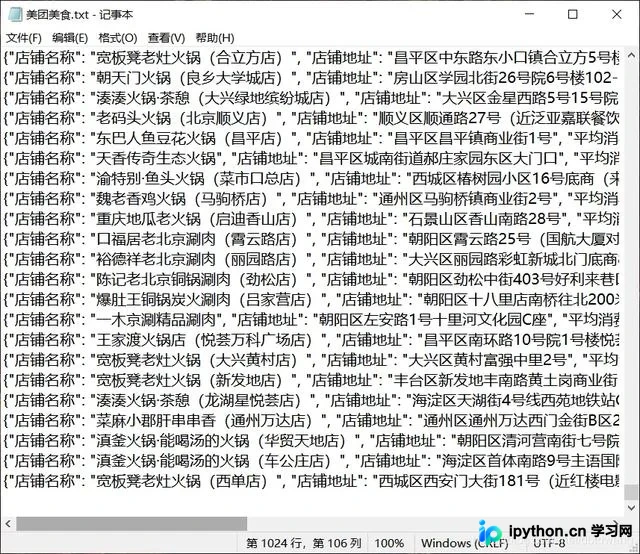
本地文件:
4.总结
根据搜索词或城市的不同,只需修改URL中对应的参数即可。同时需注意更新headers中的指定参数。该方法简单,通过多加练习即可熟练掌握Ajax类型数据的抓取技巧。
以上就是Python爬虫实例——爬取美团美食数据的详细内容,更多关于Python爬虫爬取美食数据的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









