

Python爬虫中URL参数GBK2312编码处理解析
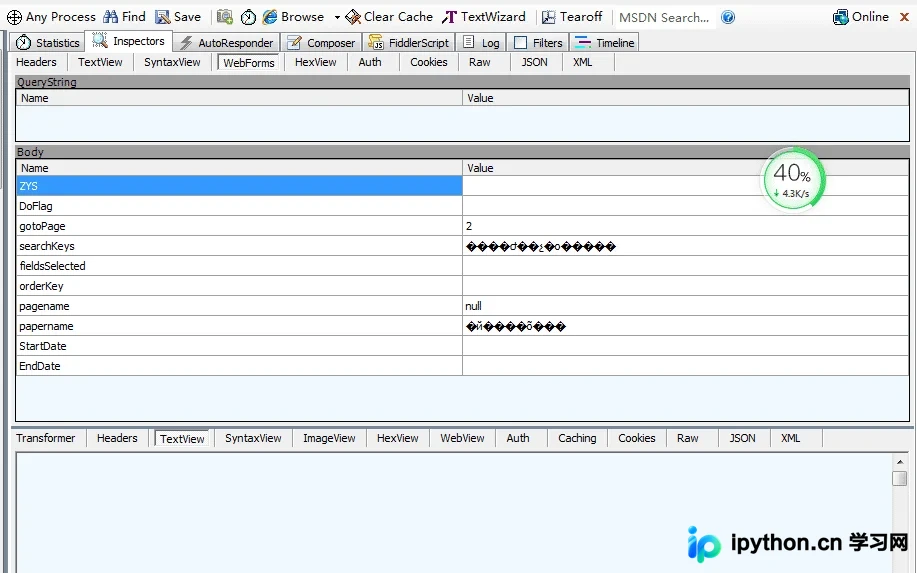
本文解析Python爬虫抓取网站时遇到的URL参数乱码问题。通过示例展示如何将中文字符串按GBK2312编码后进行百分号编码,利用urllib.quote函数生成符合要求的URL参数格式,帮助开发者解决中文请求参数乱码困扰。
2026-10-14
7

本文解析Python爬虫抓取网站时遇到的URL参数乱码问题。通过示例展示如何将中文字符串按GBK2312编码后进行百分号编码,利用urllib.quote函数生成符合要求的URL参数格式,帮助开发者解决中文请求参数乱码困扰。
本文详解如何使用Python的urllib库爬取网页,并结合BeautifulSoup解析HTML以提取所有URL链接。通过实例代码展示如何遍历a标签、处理相对路径及验证链接有效性,帮助开发者快速掌握网页数据抓取的核心技巧。
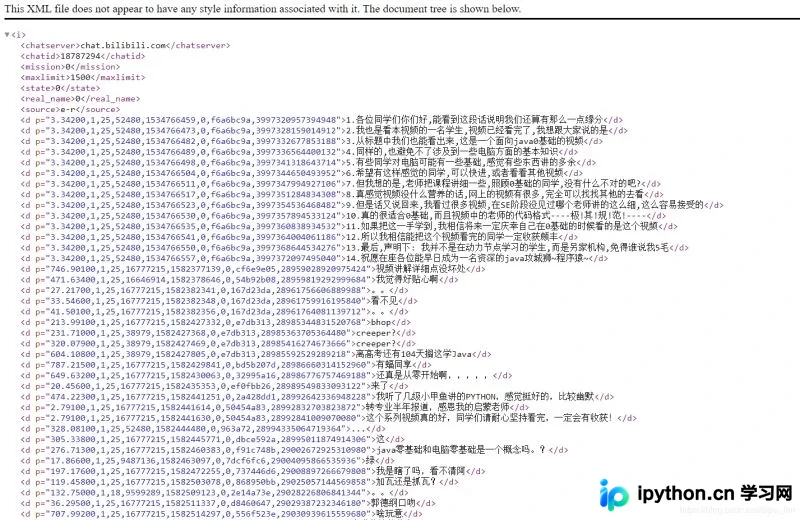
本文详细解析如何通过Python脚本获取Bilibili视频弹幕数据,并逆向分析其中的用户UID加密机制。文章介绍了获取弹幕CID的两种接口方式,重点阐述了利用CRC32算法生成的16进制校验码,通过构建无符号整型彩虹表来反查用户UID的技术方案,并结合Python与PHP实现了完整的查询工具。
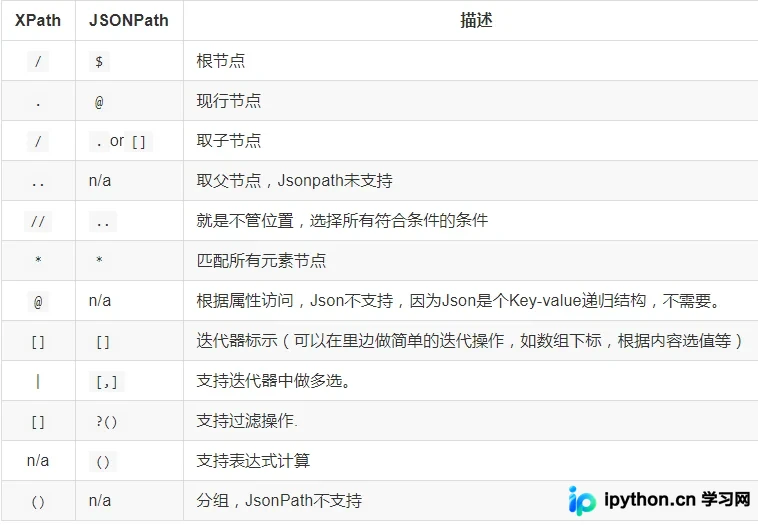
本文详解Python中JSON数据格式及JSONPath信息抽取工具。通过对比JSONPath与XPath语法,展示如何利用jsonpath库从拉勾网和城市数据中提取信息,并结合lxml处理糗事百科HTML内容。文章提供完整代码示例,涵盖JSON字符串转换、列表提取及文件保存操作,帮助开发者掌握Web数据抓取核心技巧。
双十一期间“明降暗升”现象频发,本文介绍使用Python构建定时监控工具的方法。通过requests库抓取天猫、京东等平台数据,结合Windows任务计划或Linux crontab实现定时执行,并利用pyecharts绘制价格变化折线图。工具支持多平台比价,帮助消费者识别先涨后降的虚假优惠,还原商品真实价格走势。
本文介绍利用Python和OpenCV库进行简单验证码降噪的完整流程。内容涵盖图像灰度化处理、二值化阈值设定以及基于8邻域算法的噪声过滤方法,并提供完整的Python实现代码,帮助开发者解决爬虫中常见的简单图形验证码识别问题。
本文探讨Python爬虫中URL包含字典或列表等非字符串参数时的编码问题。通过对比直接urlencode与先进行json序列化再urlencode两种方法,展示Python2环境下生成的URL差异,并建议当直接编码导致访问失败时,采用json序列化方式以确保参数正确解析。
本文详解如何使用Python原生Socket库发送HTTP及HTTPS请求。针对开发中常见的400 Bad Request和301重定向问题,分析了请求头格式、分段发送及HTTP与HTTPS协议差异(端口80与443)的影响,提供了基于Socket实现底层网络请求的完整代码示例与调试技巧。

本文详解Scrapy框架应对常见反爬机制的策略。涵盖通过中间件随机User-Agent、处理Referer与Cookies、利用X-Forwarded-For伪装代理,以及配置带认证的代理IP。针对动态加载内容,介绍通过Ajax接口分析或结合Selenium与PhantomJS模拟浏览器渲染的方法,并提供相关代码实现与注意事项。
本文介绍如何使用Python3和requests模块抓取B站视频的历史弹幕数据。通过Chrome开发者工具分析网络请求,定位rolldate和dmroll接口,获取弹幕ID及时间戳。利用正则表达式解析返回的XML数据,按日期保存弹幕内容至本地文件,为后续词云或情感分析提供数据支持。
本文详细解析Python爬虫开发中涉及的HTTP请求方法,重点对比GET与POST在参数传递、数据长度及安全性上的核心差异。通过典型请求示例,帮助开发者理解HEAD、PUT、DELETE等方法的适用场景,为构建高效稳定的网络爬虫提供基础理论支持。
本文解答Python爬虫是否容易学习的问题,解析网络爬虫的基本概念与工作原理。详细介绍企业数据、购买渠道及公开数据等来源,阐述基于URL、HTML和HTTP协议的抓取流程,并提供使用urllib库获取视频链接的Python代码示例,帮助初学者掌握基础爬虫技能。