

Python爬虫实战:JSON与JSONPath数据提取详解

发布时间:2026-10-14| 4人浏览过
本文详解Python中JSON数据格式及JSONPath信息抽取工具。通过对比JSONPath与XPath语法,展示如何利用jsonpath库从拉勾网和城市数据中提取信息,并结合lxml处理糗事百科HTML内容。文章提供完整代码示例,涵盖JSON字符串转换、列表提取及文件保存操作,帮助开发者掌握Web数据抓取核心技巧。
JSON与JSONPath基础概述
JSON(JavaScript Object Notation)是一种轻量级的数据交换格式,旨在提升人类阅读与编写的便捷性,同时便于机器进行解析和生成。该格式广泛应用于数据交互场景,例如网站前端与后端之间的数据传递。
JSONPath是一个用于从JSON文档中抽取指定信息的工具库,支持多种编程语言实现,包括JavaScript、Python、PHP和Java。
在JSON数据处理中,JSONPath的作用类似于XML中的XPath。
JSONPath与XPath语法对比
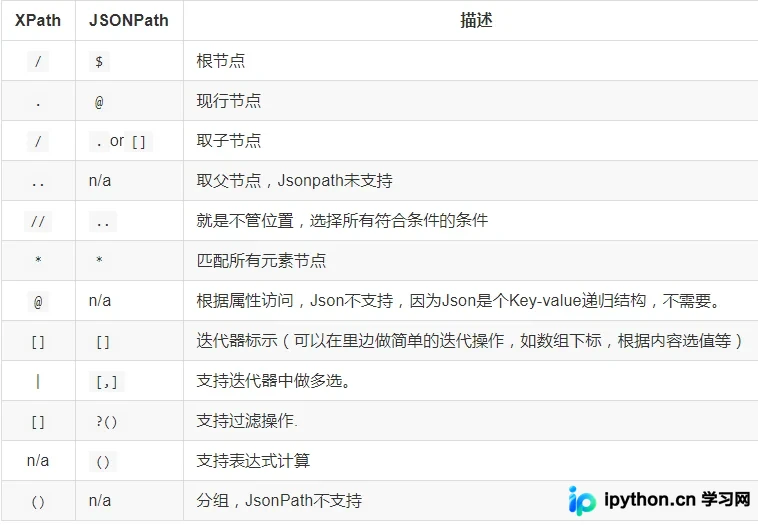
JSONPath与XPath的语法存在对应关系,具体对比如下。
JSON结构清晰、可读性强且复杂度低,易于匹配。下表展示了JSONPath与XPath用法的对应情况。
相关推荐:《Python相关教程》
实战案例:拉勾网城市数据爬取
以下示例演示如何利用JSONPath爬取拉勾网提供的全部城市数据。
#!/usr/bin/env python
# -*- coding:utf-8 -*-
import urllib2
# json解析库,对应到lxml
import json
# json的解析语法,对应到xpath
import jsonpath
url = "http://www.lagou.com/lbs/getAllCitySearchLabels.json"
headers = {'User-Agent':'Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/60.0.3112.101 Safari/537.36'}
request = urllib2.Request(url, headers = headers)
response = urllib2.urlopen(request)
# 取出json文件里的内容,返回的格式是字符串
html = response.read()
# 把json形式的字符串转换成python形式的Unicode字符串
unicodestr = json.loads(html)
# Python形式的列表
city_list = jsonpath.jsonpath(unicodestr, "$..name")
#for item in city_list:
#  print item
# dumps()默认中文为ascii编码格式,ensure_ascii默认为Ture
# 禁用ascii编码格式,返回的Unicode字符串,方便使用
array = json.dumps(city_list, ensure_ascii=False)
#json.dumps(city_list)
#array = json.dumps(city_list)
with open("lagoucity.json", "w") as f:
  f.write(array.encode("utf-8"))
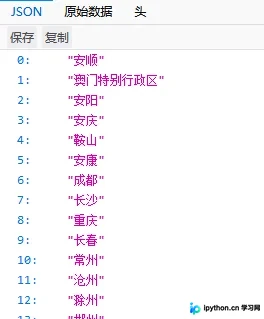
运行结果如下。
接下来演示如何爬取糗事百科的内容。
此处利用XPath的模糊查询功能定位目标元素。
代码逻辑用于获取每个帖子中的具体内容。
最后将提取的数据保存至json文件中。
实战案例:糗事百科内容抓取与存储
#!/usr/bin/env python
# -*- coding:utf-8 -*-
import urllib2
import json
from lxml import etree
url = "http://www.qiushibaike.com/8hr/page/2/"
headers = {'User-Agent':'Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/60.0.3112.101 Safari/537.36'}
request = urllib2.Request(url, headers = headers)
html = urllib2.urlopen(request).read()
# 响应返回的是字符串,解析为HTML DOM模式 text = etree.HTML(html)
text = etree.HTML(html)
# 返回所有段子的结点位置,contains()模糊查询方法,第一个参数是要匹配的标签,第二个参数是标签名部分内容
node_list = text.xpath('//div[contains(@id, "qiushi_tag")]')
items ={}
for node in node_list:
  # xpath返回的列表,这个列表就这一个参数,用索引方式取出来,用户名
  username = node.xpath('./div/a/@title')[0]
  # 取出标签下的内容,段子内容
  content = node.xpath('.//div[@class="content"]/span')[0].text
  # 取出标签里包含的内容,点赞
  zan = node.xpath('.//i')[0].text
  # 评论
  comments = node.xpath('.//i')[1].text
  items = {
    "username" : username,
    "content" : content,
    "zan" : zan,
    "comments" : comments
  }
  with open("qiushi.json", "a") as f:
    f.write(json.dumps(items, ensure_ascii=False).encode("utf-8") + "
")
以上为本文的全部内容,希望对读者的学习有所帮助,欢迎继续支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









