

Python爬虫基于lxml解决数据编码乱码问题
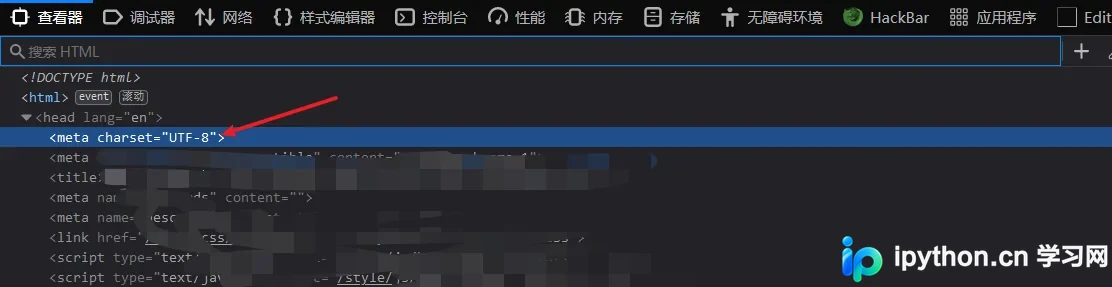
在使用Python lxml库解析HTML数据时,常因网页编码与程序解码不一致导致中文显示为乱码。本文介绍通过XPath定位节点后,利用encode('ISO-8859-1').decode('UTF-8')方法进行编码转换的技巧,有效解决数据抓取中的字符显示异常问题。
2026-10-14
5

在使用Python lxml库解析HTML数据时,常因网页编码与程序解码不一致导致中文显示为乱码。本文介绍通过XPath定位节点后,利用encode('ISO-8859-1').decode('UTF-8')方法进行编码转换的技巧,有效解决数据抓取中的字符显示异常问题。
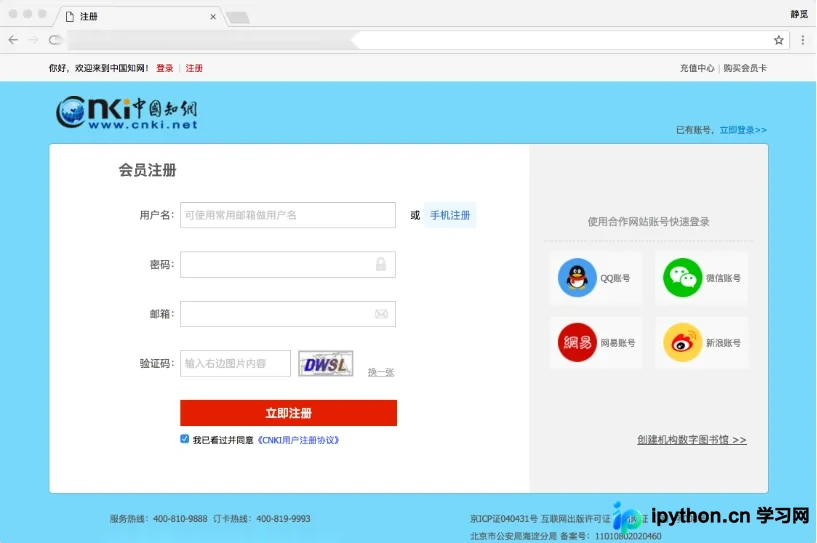
本文详细讲解在Python3爬虫中如何使用Tesserocr库识别简单的图形验证码。内容涵盖从获取验证码图片、直接调用OCR接口,到通过灰度转换和二值化处理去除干扰线条以提高识别准确率的全过程。结合知网注册页面实例,提供完整的代码示例与参数设置说明,帮助开发者解决验证码识别难题。
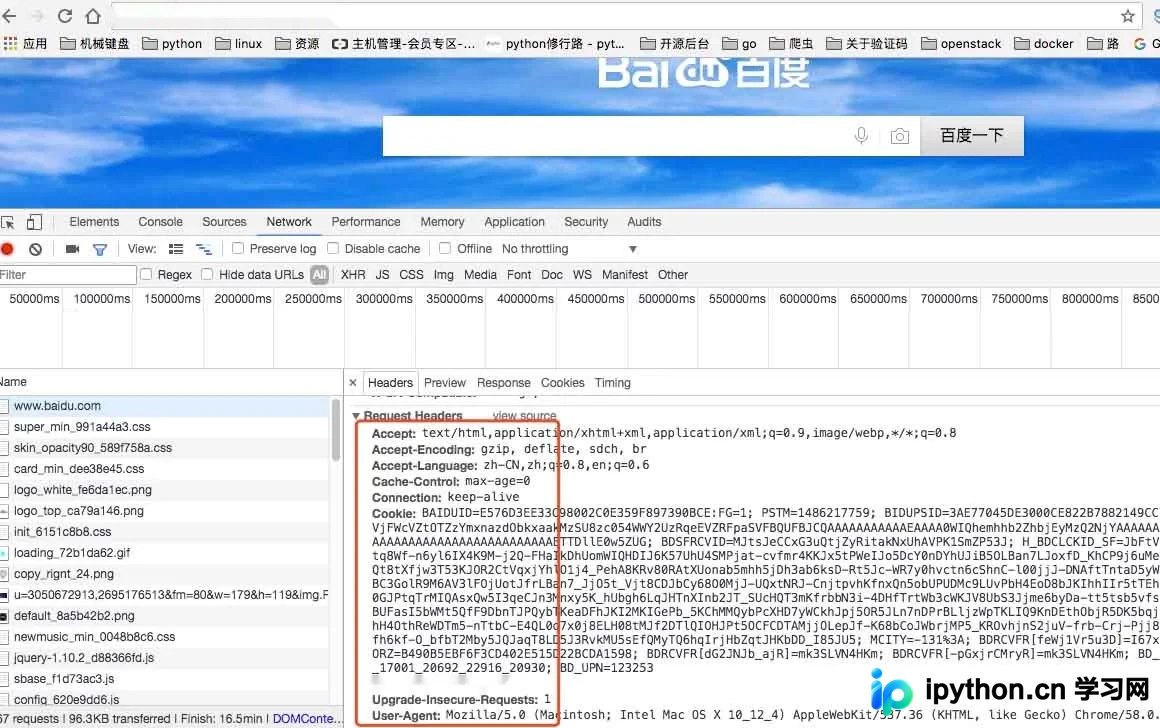
本文深入解析Python爬虫的核心原理,涵盖发起请求、获取响应、解析内容及保存数据四大基本流程。详细阐述HTTP Request与Response的结构,包括GET/POST等请求方式及状态码含义,并介绍正则、BeautifulSoup等数据解析技术,以及针对JS渲染数据的Selenium等解决方案。
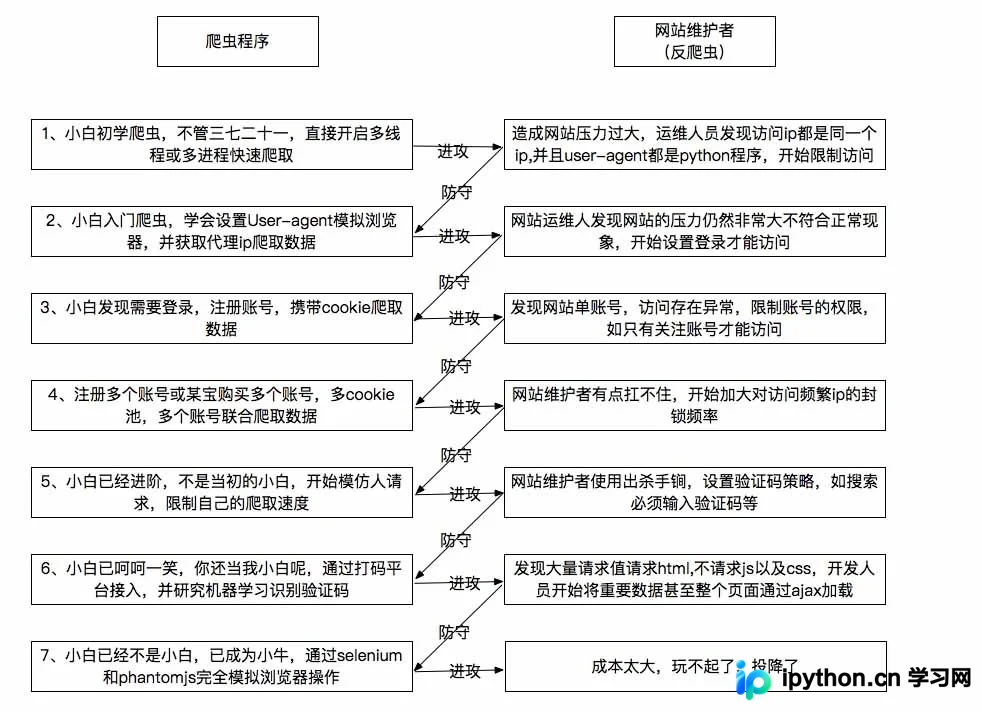
本文深入解析Python爬虫与反爬虫的对抗机制,涵盖自动获取数据原理、常见反爬策略如IP封禁的成本与误伤风险,以及数据保护与商业竞争背景下的防御目的。通过梳理实战中的攻防策略,帮助开发者理解如何在获取数据与防止滥用之间取得平衡,适用于Python及相关技术栈的开发者参考。
本文解析Python爬虫选用MongoDB的核心原因。MongoDB采用文档存储方式,直接支持JSON和List结构,无需预定义表结构即可随时创建集合。其模式自由特性允许每条记录字段长度不一致,完美适配爬虫获取的杂乱非结构化数据。此外,MongoDB具备高性能、易部署、支持动态查询及多语言接口等优势,是处理海量爬虫数据的理想选择。
本文详细解析Python3爬虫中携带Cookie的两种核心方法:直接写入Header头部和使用requests库的cookies参数。通过哈工大ACM站点的登录实战,演示如何利用urllib和cookiejar实现自动登录及后续页面访问,帮助开发者解决身份验证相关的爬虫需求。
本文详细解析使用Scrapy框架爬取拉勾网Python相关职位信息的完整流程。从分析搜索结果页的Ajax请求入手,提取职位ID与ShowID,拼接详情页URL。针对反爬机制,通过携带Cookie和模拟POST请求解决访问限制,并配置随机User-Agent中间件。最终实现职位详情数据的自动化抓取与JSON存储,提供完整的代码实现与配置说明。
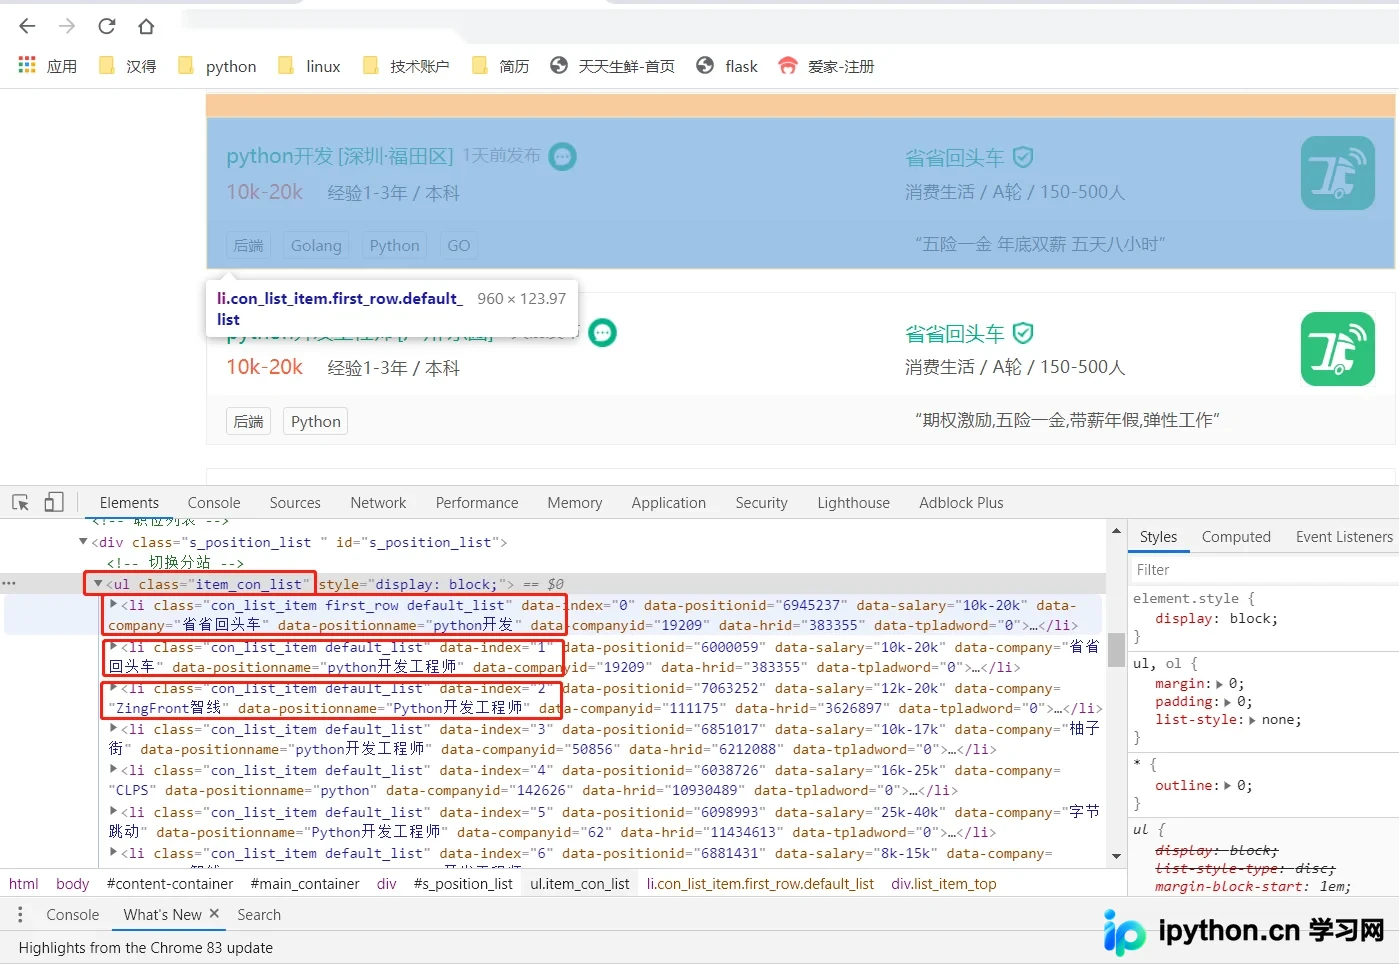
本文深入解析Python3爬虫中Ajax技术的应用。通过微博下拉刷新实例,阐述Ajax异步加载数据的原理,包括发送请求、解析内容及渲染网页三个核心步骤。重点介绍JavaScript中XMLHttpRequest对象的实现机制,并指导如何利用Python模拟Ajax请求以获取动态数据,为高效抓取网页内容提供技术支撑。
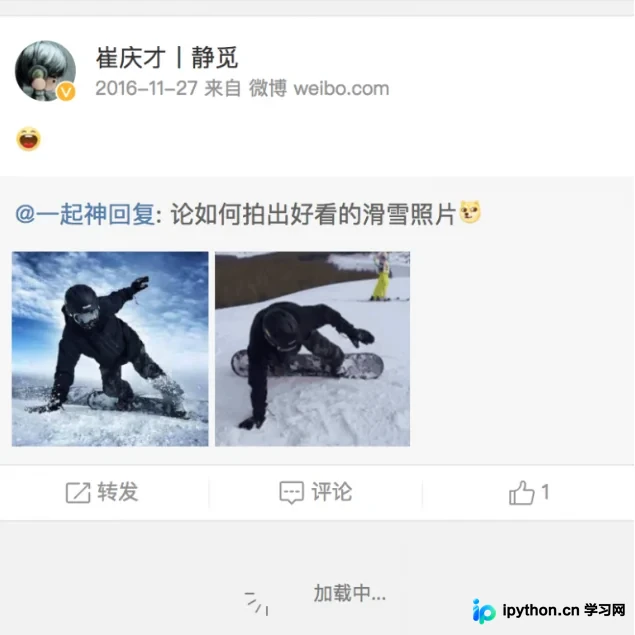
本文详解如何使用Chrome开发者工具分析微博等网站的Ajax动态加载内容。通过Network面板定位XHR类型请求,解析Request Headers中的XMLHttpRequest标识及JSON响应数据,并结合XHR筛选功能高效捕获所有异步请求,为Python程序模拟请求和提取数据奠定基础。
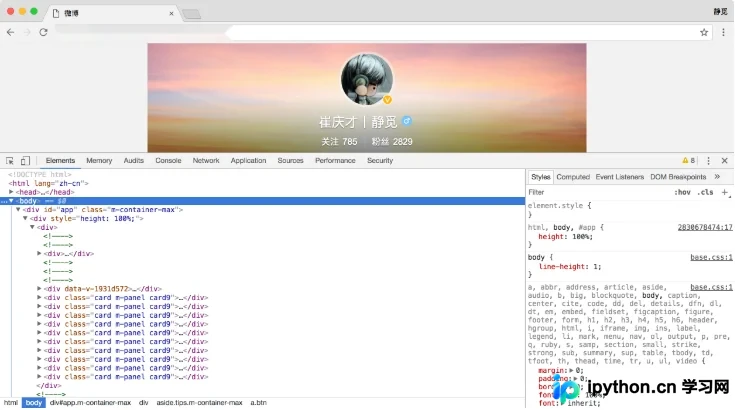
本文介绍如何利用 Python 抓取知乎指定回答下的视频。通过浏览器开发者工具分析网络请求,定位视频播放接口,解析包含普清、标清及高清链接的 JSON 数据,并编写完整代码实现自动下载功能。
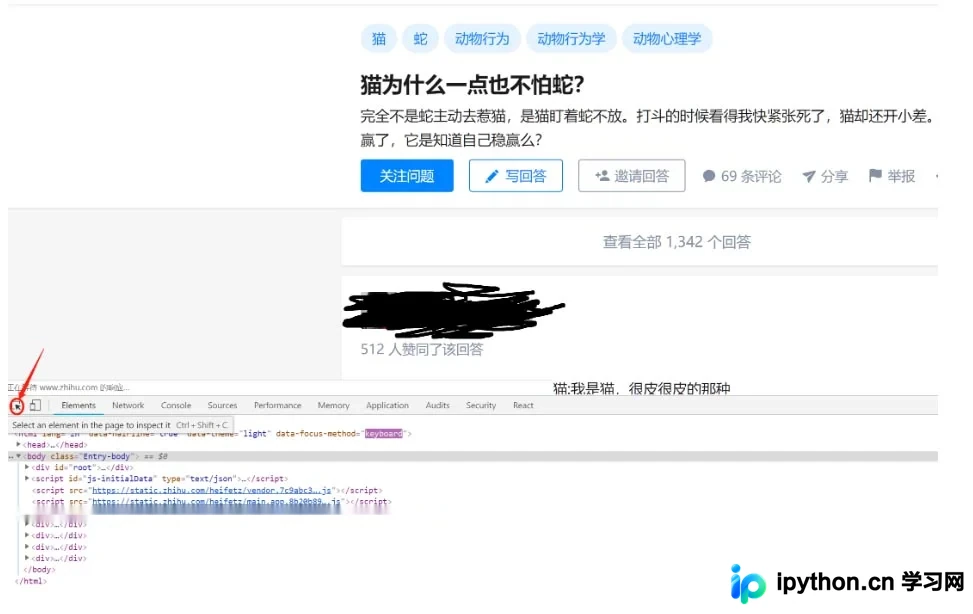
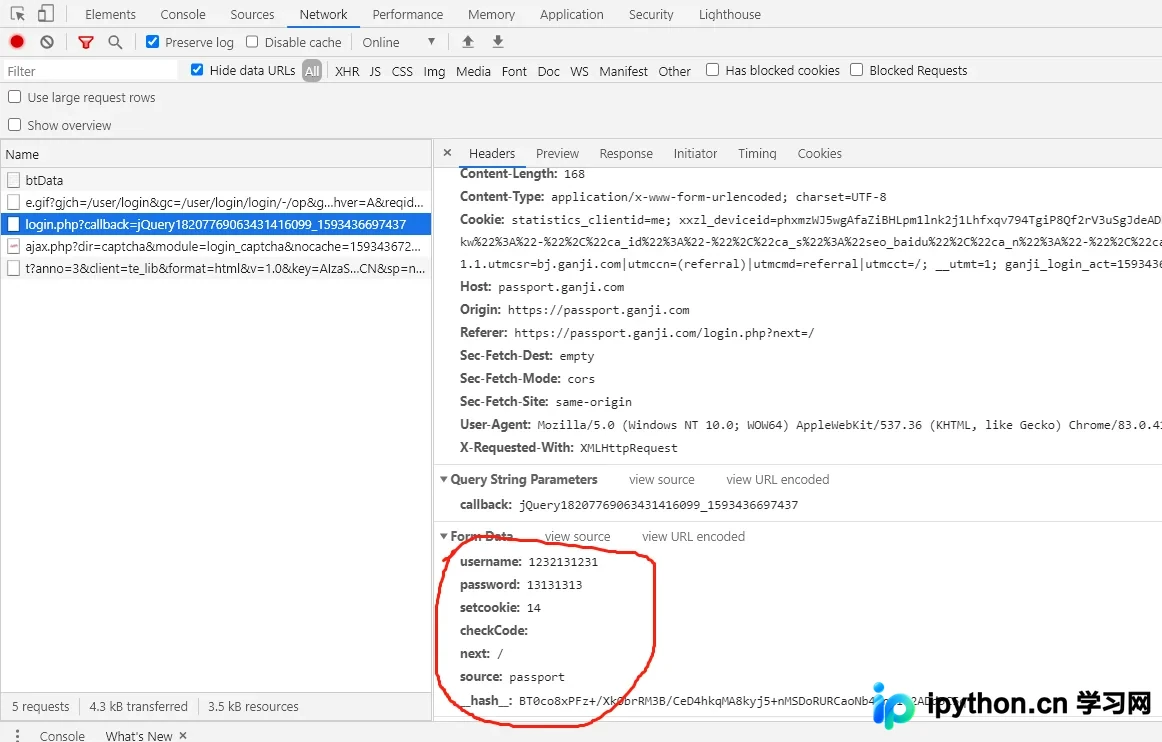
本文详细讲解如何使用Scrapy框架模拟登录赶集网。通过分析登录接口的POST请求参数,包括setcookie、__hash__及验证码机制,提供完整的Python代码实现。内容涵盖项目创建、Spider编写、表单数据构造及登录后的处理流程,帮助开发者掌握动态参数提取与自动登录技巧。
本文介绍在Python爬虫中遇到Cloudflare邮箱加密时的解决方案。通过分析前端JS代码,提取基于异或运算的解密逻辑,并使用Python的execjs库加载并调用该JS函数,成功还原加密后的邮箱地址,实现自动化采集。