Python爬取爱奇艺非VIP视频实战:URL解析与数据抓取
本文详解如何利用Python爬取爱奇艺非VIP视频。通过构造搜索URL并分析分页规律,使用requests获取页面源码,结合BS4库解析HTML标签提取视频链接、标题及描述信息。针对作者信息位置不固定的问题,采用try-except机制进行容错处理,确保数据抓取的完整性与稳定性。
2026-10-13
6

本文详解如何利用Python爬取爱奇艺非VIP视频。通过构造搜索URL并分析分页规律,使用requests获取页面源码,结合BS4库解析HTML标签提取视频链接、标题及描述信息。针对作者信息位置不固定的问题,采用try-except机制进行容错处理,确保数据抓取的完整性与稳定性。
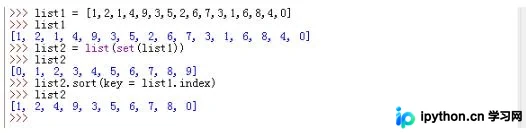
本文介绍如何在Python中对列表进行去重操作,同时保持元素原有的出现顺序。通过结合set集合去重与list.sort方法利用index排序,可解决set默认按值排序的问题。此外,文章还补充了Python爬虫中利用集合实现链接去重的完整代码示例,帮助开发者高效处理数据。
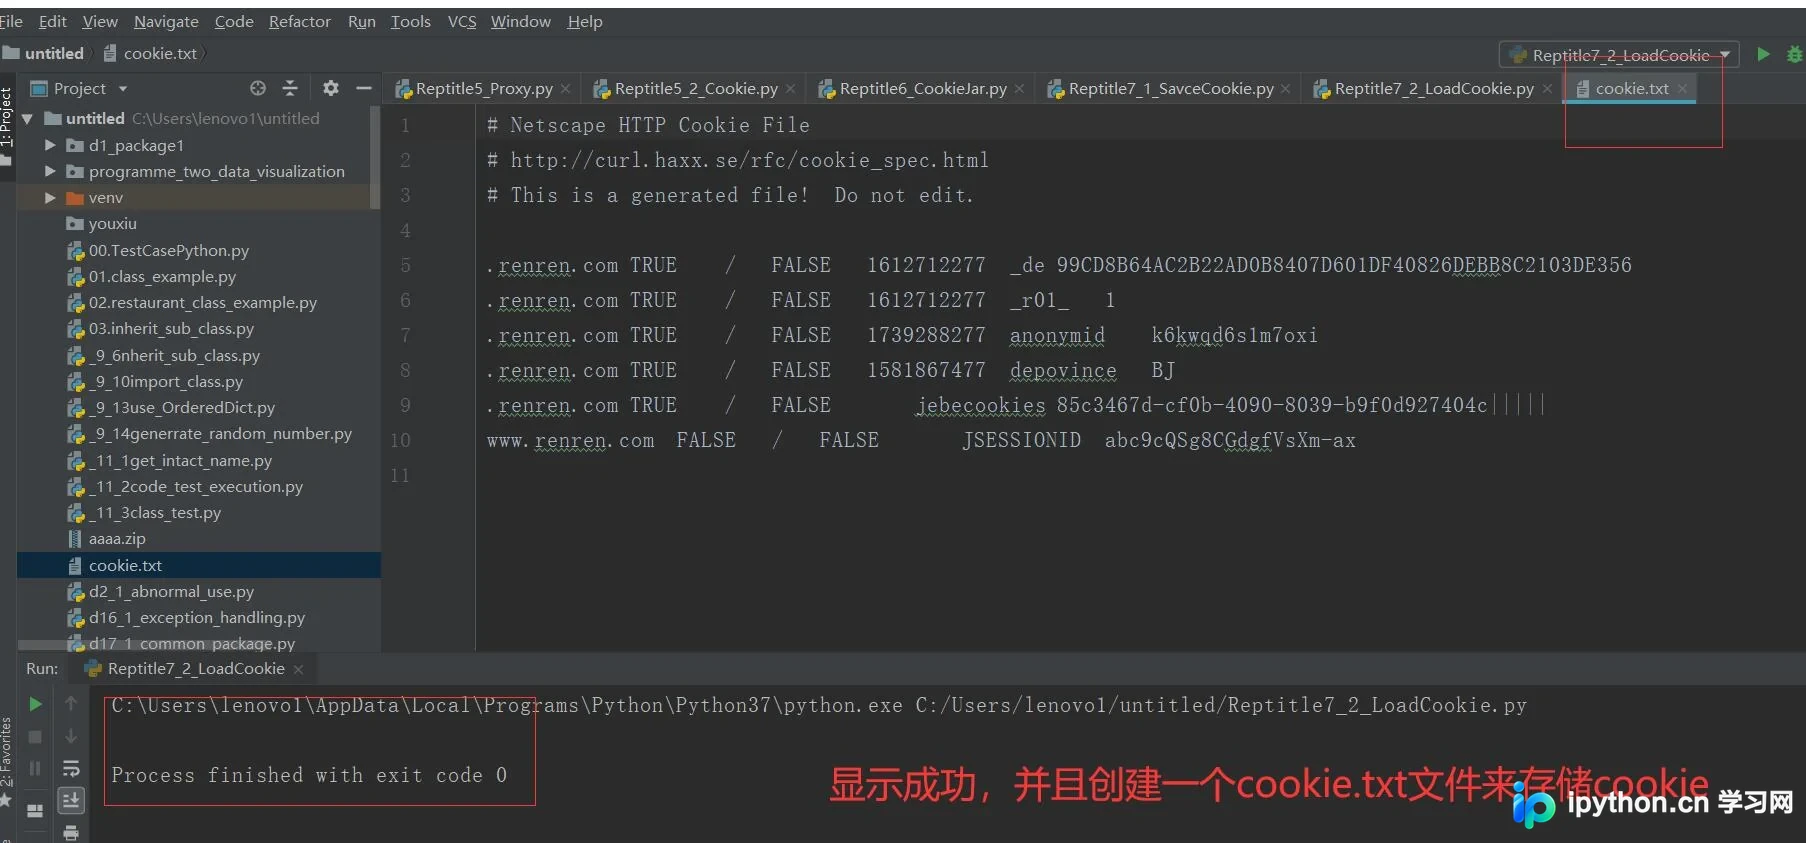
本文详解Python爬虫中Cookie的持久化保存与读取方法,利用FileCookieJar类实现登录状态的文件存储。同时介绍如何处理HTTPS请求中的SSL证书验证问题,通过替换默认上下文环境来忽略不信任的SSL证书,确保爬虫程序在复杂网络环境下的稳定运行。
本文详细介绍在Scrapy框架中实现网站登录的三种常见方式。第一种通过预置Cookies直接访问;第二种手动解析网页获取隐藏字段后发送POST请求;第三种利用FormRequest.from_response自动处理表单提交。文章提供完整代码示例,帮助开发者掌握不同场景下的登录策略。
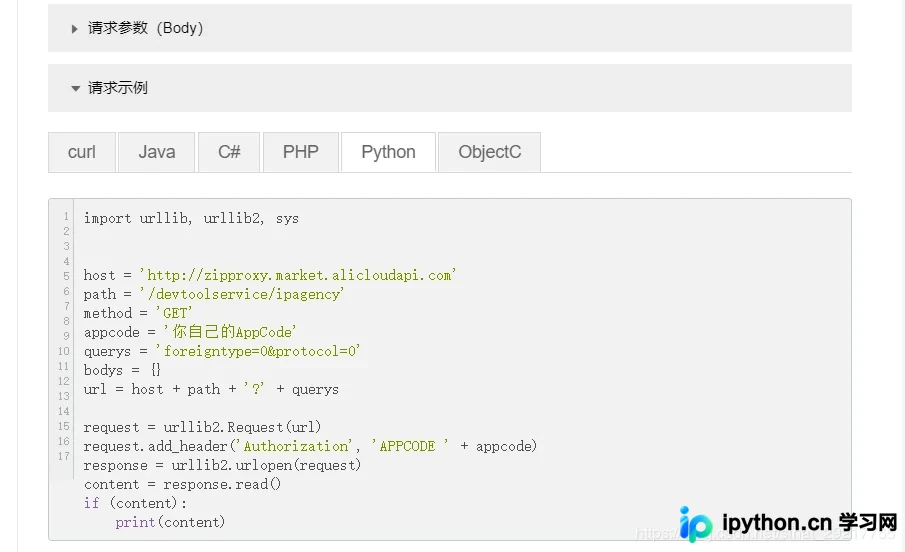
本文详细讲解在Python3 Scrapy框架中配置IP代理的方法。针对阿里云IP代理参数变更及公共IP池不可用的问题,提出结合阿里云API生成有效IP池并在middlewares.py中通过process_request动态设置request.meta['Proxy-Authorization']的解决方案,确保爬虫稳定运行。
本文介绍如何使用Python结合Redis数据库构建IP代理池。通过apscheduler库实现定时爬取IP,并采用两层检测机制确保代理有效性:先将IP存入Redis db0进行初步验证,成功者转入db1进行二次检测。代码包含IP的增删改查及定时调度逻辑,为网络爬虫提供稳定的代理支持。
本文详解Selenium中get_cookies()与add_cookie()函数的使用方法。通过获取当前浏览器Cookie并保存为JSON文件,后续爬虫任务可直接读取该文件并利用add_cookie()注入Cookie,从而绕过登录验证。该方法特别适用于验证码识别困难或需要高频定时爬取且不想频繁登录的场景,有效提升爬虫稳定性和效率。
本文解析Python爬虫中通过设置User-Agent模拟浏览器访问的方法。通过urllib2构造请求对象并添加Headers,实现伪装浏览器身份进行数据抓取,同时展示获取响应状态码、URL及头部信息的技巧,帮助开发者规避基础反爬限制。
本文详解Python爬虫中常见的UnicodeDecodeError异常原因,并提供两种通用解码策略:通过HTML标签提取charset自动解码,以及遍历utf-8、gbk等常用编码并配合errors='replace'参数尝试解析。通过对比数据完整性,推荐以实际数据表现选择最佳编码方式,有效解决网页抓取中的乱码问题。

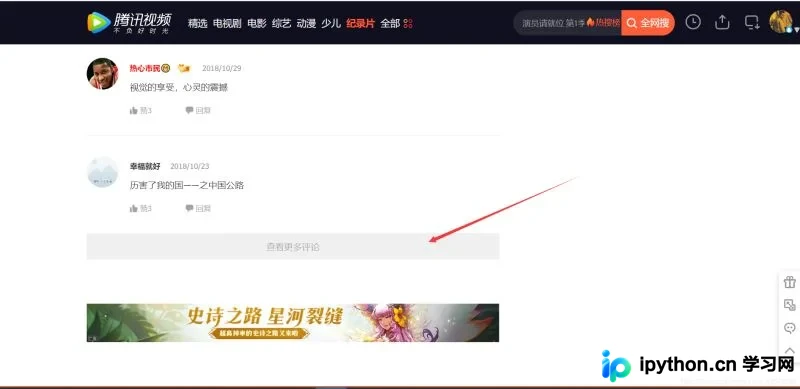
本文详解如何使用Python爬取腾讯视频纪录片评论。通过Fiddler抓包分析Ajax异步加载机制,解析评论接口URL规律,重点推导cursor参数的获取逻辑。结合Python代码实现自动翻页抓取,完整展示从环境配置、接口分析到代码编写的全过程,帮助开发者掌握动态网页数据抓取的核心技巧。
本文详细介绍如何使用Python的pyquery库爬取豆瓣电影信息。通过示例代码展示如何获取电影源代码、解析链接并提取观看地址。文章包含完整代码逻辑及输入“天气之子”、“独立日”等电影名的运行结果截图,强调仅上映电影可获取观看链接,为Python学习者提供实用的爬虫参考。
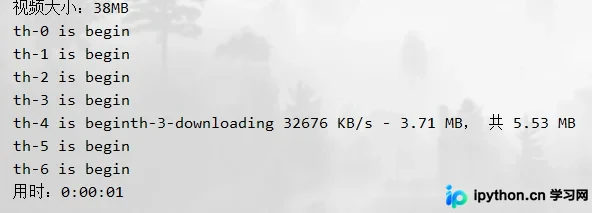
本文介绍使用Python实现多线程下载视频的方法。通过解析视频文件大小动态计算线程数,最大支持10个线程以提升下载速度。文章指出获取视频原链是主要难点,涉及反爬机制,建议结合爬虫技术解决。代码包含进度显示与错误处理,适合需要快速下载大文件场景。