
TensorFlow中通过assign更新变量值的正确方式
本文介绍在TensorFlow中如何正确更改变量的值。核心方法是使用tf.assign()创建更新操作,并必须在Session中通过run()执行该操作才能在图中生效。直接对Python变量赋值无效,且若传入非Tensor类型会导致AttributeError。
2026-10-13
7


本文介绍在TensorFlow中如何正确更改变量的值。核心方法是使用tf.assign()创建更新操作,并必须在Session中通过run()执行该操作才能在图中生效。直接对Python变量赋值无效,且若传入非Tensor类型会导致AttributeError。
本文详细解析如何使用TensorFlow复现经典的AlexNet模型。重点还原了论文中双GPU并行的原始网络结构,而非常见的单GPU合并版本。文章涵盖模型定义、参数加载及测试流程,通过具体代码示例展示如何对渣土车等常见物体进行图像分类识别,适合希望深入理解AlexNet架构及熟悉TensorFlow操作的开发者参考。
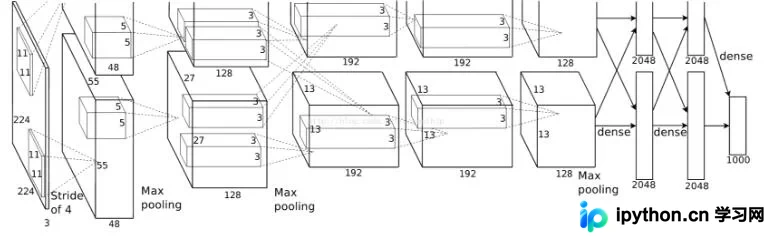
本文详解 Python 多核并行计算方案。针对 CPython 的 GIL 限制,对比 threading 与 multiprocessing,推荐 Pool 及 imap 系列函数实现高效并行。重点解析在 TensorFlow 等 GPU 工具中,因父进程导入导致的 CUDA 初始化错误,并提供通过 Process target 或 Pool initializer 在子进程内延迟导入的两种修复策略。
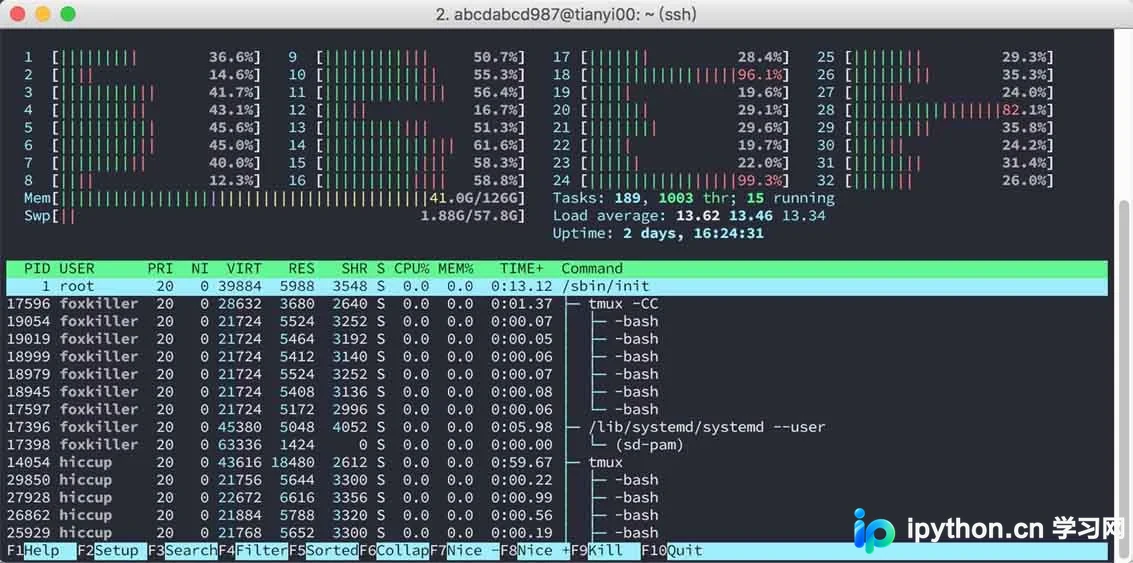
本文介绍如何使用 TensorFlow 实现一个简单的逻辑回归模型。通过定义占位符、变量、损失函数及优化器,演示了从数据生成到模型训练的全过程。代码包含权重初始化、Sigmoid 激活函数应用及 Adam 优化器配置,并附带训练误差曲线可视化,帮助理解逻辑回归在分类任务中的基本实现原理。
本文介绍如何将TensorFlow模型的网络定义与权重参数合并导出为单个文件。通过`convert_variables_to_constants`将变量转换为常量,并使用`tf.train.write_graph`保存为`.pb`文件。文章提供了完整的代码示例,涵盖模型导出、加载以及使用自定义输入进行推理的具体操作步骤。
本文详细介绍TensorFlow中tf.get_collection函数的使用方法。该函数用于从指定collection中获取全部变量并返回列表,主要包含key和scope两个参数。文章通过具体代码示例,展示了其与tf.get_variable和tf.add_to_collection的配合使用方式,帮助开发者掌握变量集合的管理技巧。
本文深入解析Python中tf.nn.dynamic_rnn函数的核心参数及返回值,详细阐述time_major、sequence_length等关键配置对计算性能的影响。通过单层与多层BasicRNNCell的完整代码示例,直观展示outputs与states张量的形状变化及数据流向,帮助开发者掌握RNN模型构建与调试技巧。
本文深入解析Python生态中十大核心库,涵盖数据处理、机器学习与可视化领域。从Pandas的数据清洗到NumPy的高效数组计算,再到Scikit-learn的建模与TensorFlow、Keras的深度神经网络实现,最后介绍Gradio、SciPy、Statsmodels、Plotly及Seaborn在模型部署、科学计算与动态可视化中的关键作用,助您构建完整的AI工作流。
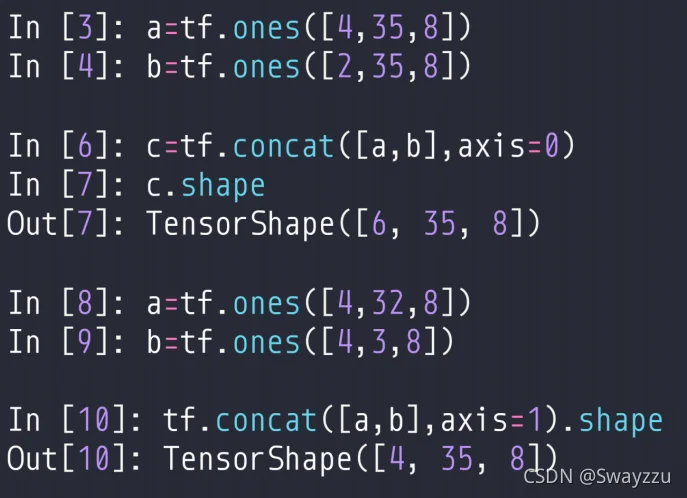
本文详解TensorFlow中数据合并与分割的核心函数,包括tf.concat、tf.split和tf.stack的维度处理规则。同时介绍数据统计操作,如tf.norm求范数、reduce系列求极值与均值,以及tf.argmax和tf.unique的使用方法与注意事项,帮助开发者掌握张量操作基础。
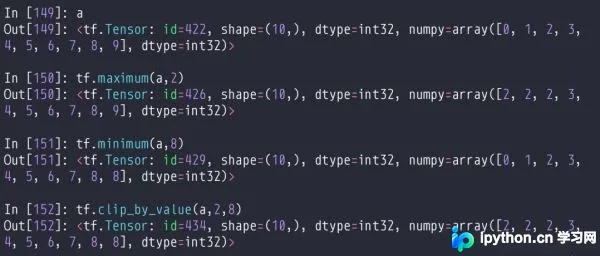
本文详细介绍TensorFlow中张量的核心高阶操作。涵盖按数值和范数进行张量裁剪以解决梯度爆炸问题,利用sort、argsort及topk进行数据排序与Top-K准确率计算。此外,解析tf.where条件筛选、tf.scatter_nd索引更新及tf.meshgrid网格生成等常用函数的具体用法与参数细节。
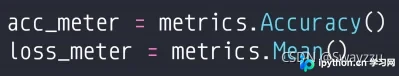
本文介绍TensorFlow中Keras高层接口的核心应用。首先详解metrics模块,涵盖创建、更新、获取及重置状态的完整流程,用于训练过程中的数据跟踪。其次讲解快捷训练接口,包括compile配置优化器与损失函数,以及fit、evaluate和predict的具体用法与参数设置,帮助开发者高效完成模型训练与评估。
本文介绍使用TensorFlow构建卷积神经网络(CNN)处理MNIST手写数字数据集的完整流程。网络包含两层卷积与池化及全连接层,通过1000至2000次迭代训练,测试集准确率分别达到98.6%与99.1%。相比传统神经网络,CNN凭借卷积核权值共享机制,在降低参数量与计算量的同时有效缓解过拟合,显著提升了模型性能。