

TensorFlow数据合并与统计操作详解

本文详解TensorFlow中数据合并与分割的核心函数,包括tf.concat、tf.split和tf.stack的维度处理规则。同时介绍数据统计操作,如tf.norm求范数、reduce系列求极值与均值,以及tf.argmax和tf.unique的使用方法与注意事项,帮助开发者掌握张量操作基础。
一、数据合并与分割
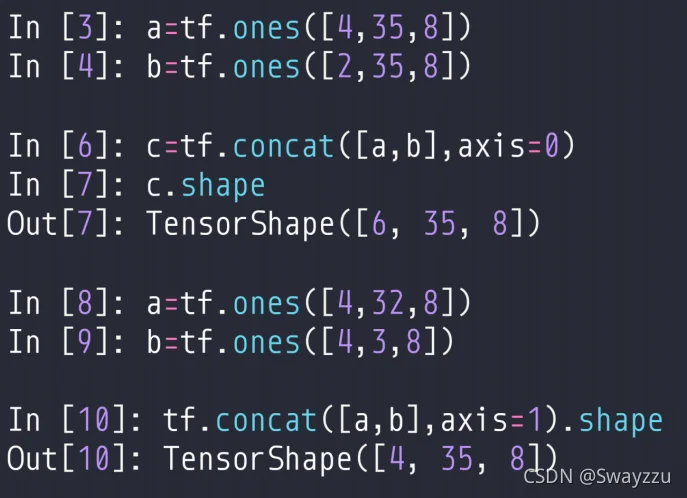
1.tf.concat()
该函数接收两个张量,并指定一个维度进行合并。除了被合并的维度外,其他所有维度的大小必须完全一致。
2.tf.split()
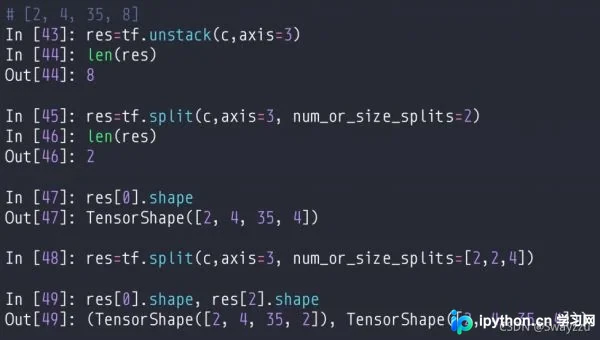
该函数接收一个张量,指定分割的维度以及分割后的数量。例如,若原始数据维度为[2,4,35,8],当指定在最后一维分割且数量为2时,结果将生成两个张量,其维度均为[2,4,35,4]。此外,分割维度也可以直接指定各部分的尺寸,例如指定为[2,2,4],则会生成三个张量,其最后一个维度的大小分别为2、2和4。
3.tf.stack()
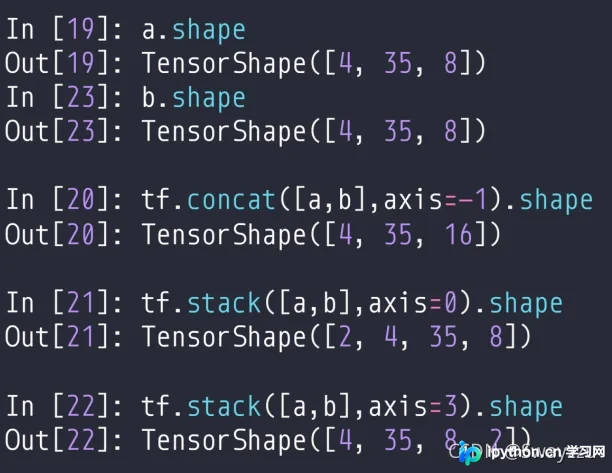
此方法会创建一个新的维度。要求参与合并的两个数据在所有原有维度上完全相同。合并操作会在指定的维度前插入一个新维度,后续可根据这个新维度进行索引或选择。
二、数据统计
需要注意:在TensorFlow中指定维度进行操作时,意味着对该指定维度内的数据进行运算,而保留其余维度的结构。
以形状为(2,3)的数据求范数为例,若指定axis=1(即列方向),则意味着利用每列上的3个数据来计算范数,最终结果将是一个2维向量。简言之,指定了哪个维度进行操作,该维度就会被消去。
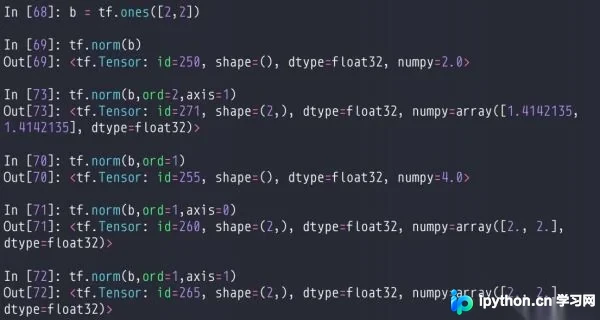
1.tf.norm()
用于计算范数,若不指定具体的范数类型,默认计算二范数。
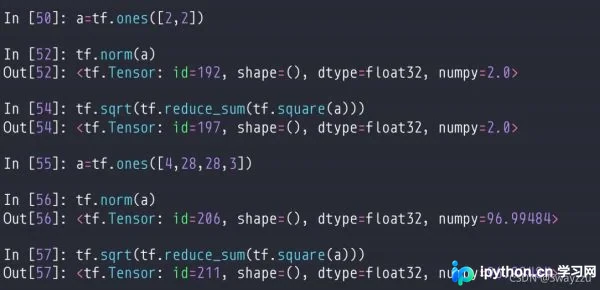
若指定ord=1,则计算1范数。该函数支持指定维度,即对指定维度内的数据求范数,并保留其他维度。
例如对于形状为(2,3)的数据,若指定axis=1(列方向),则利用每列的3个数据求范数,结果为一个2维向量。同样地,指定哪个维度进行操作,该维度就会被消去。
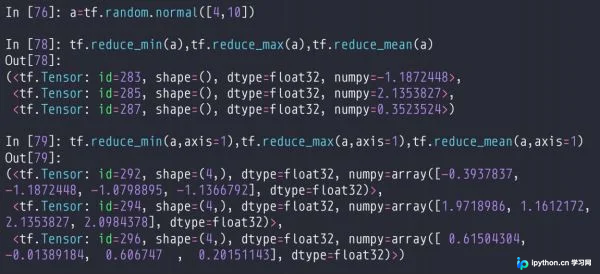
2.reduce_min/max/mean()
这些函数分别用于计算数据的最小值、最大值和均值。名称中的“reduce”提示我们,操作后数据的维度会降低。
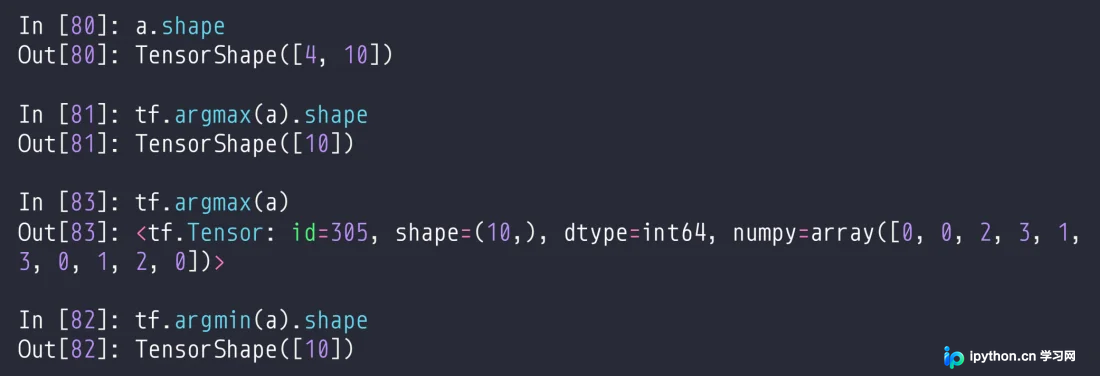
3.tf.argmax/argmin()
这两个函数返回最大值或最小值的索引。如果不指定具体维度,默认会对第0维进行计算。
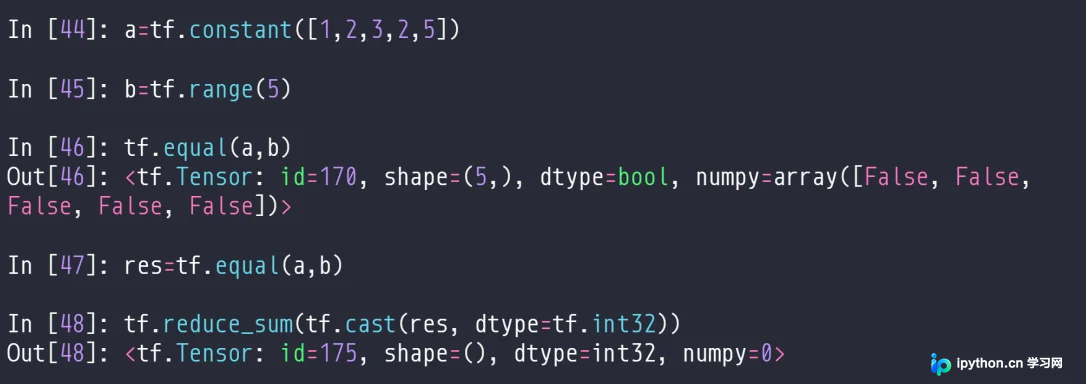
4.tf.equal()
该函数接收两个形状相同的张量,返回一个相同形状的布尔型张量。可以通过将其转换为整型(1和0),然后进行累加操作,来计算两个张量中相同数据的数量。
5.tf.unique()
其功能与NumPy库中的unique函数相同。
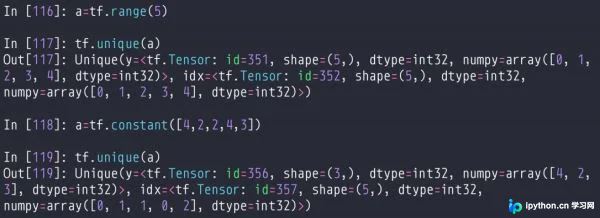
以上即为TensorFlow中数据合并、分割及统计操作的详细示例,更多关于TensorFlow数据处理的资料请查阅本站其他文章。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









