

Python 多核并行计算实战:从 multiprocessing 到 GPU 进程隔离

本文详解 Python 多核并行计算方案。针对 CPython 的 GIL 限制,对比 threading 与 multiprocessing,推荐 Pool 及 imap 系列函数实现高效并行。重点解析在 TensorFlow 等 GPU 工具中,因父进程导入导致的 CUDA 初始化错误,并提供通过 Process target 或 Pool initializer 在子进程内延迟导入的两种修复策略。
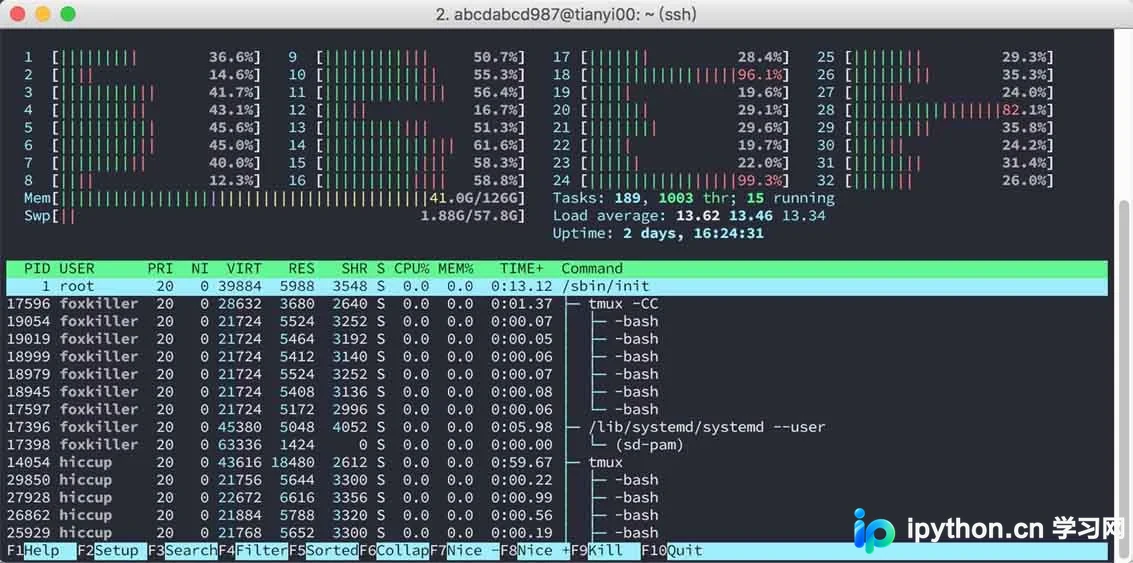
过去编写小型脚本时,通常无需考虑并行处理,单核运行即可满足需求。鉴于我的电脑配置仅为双核四超线程(下文统称为核心),我认为投入精力优化并行并无太大意义,除非涉及大量 IO 密集型任务。然而,在升级到 32 核 128GB 内存的机器后,看到 htop 中大量空闲的核心,促使我重新审视并行处理的必要性。经过实践,我发现 Python 实现并行处理实际上非常简便。
multiprocessing 与 threading 的选择
Python 标准库丰富且易用,这是我偏爱 Python 的重要原因之一。Python 提供了 multiprocessing 和 threading 两个用于实现并行的库。从直觉上看,使用线程似乎更合理,因为其开销较小且支持共享内存,在其他语言中线程的应用也极为广泛。然而,必须明确指出:如果你使用的是 CPython 实现,使用 threading 实际上意味着放弃了并行计算(甚至可能比单线程更慢),除非你的任务属于 IO 密集型。
GIL 机制解析
CPython 指的是 python.org 官方提供的 Python 实现。需要明确的是,Python 是一种编程语言,拥有多种实现方式,例如 PyPy、Jython、IronPython 等。其中,CPython 是最常用的实现,在大多数场景中,它几乎等同于 Python 本身。
在 CPython 实现中,引入了 GIL(全局解释器锁)以简化解释器的设计,确保解释器在同一时刻仅执行一个线程的字节码。这意味着,除非任务涉及 IO 等待,否则 CPython 的多线程机制无法实现真正的并行计算,这在很大程度上是一个误解。
关于 GIL 的深入理解,以下两份资料提供了优秀的解读:
- http://cenalulu.github.io/python/gil-in-python/
- http://www.dabeaz.com/python/UnderstandingGIL.pdf
multiprocessing.Pool 的使用
由于 GIL 的存在使得 threading 无法发挥并行优势,我们应重点研究 multiprocessing。当然,如果你不使用 CPython 且不存在 GIL 问题,那自然是理想情况。
首先介绍一个简单且实用的工具:multiprocessing.Pool。如果你的任务可以通过 ys = map(f, xs) 的形式解决,大家可能都知道,这种形式天生适合并行处理。在 Python 中并行执行此类任务非常简单。例如,计算每个数字的平方:
import multiprocessing

def f(x):
  return x * x

cores = multiprocessing.cpu_count()
pool = multiprocessing.Pool(processes=cores)
xs = range(5)

# method 1: map
print pool.map(f, xs) # prints [0, 1, 4, 9, 16]

# method 2: imap
for y in pool.imap(f, xs):
  print y      # 0, 1, 4, 9, 16, respectively

# method 3: imap_unordered
for y in pool.imap_unordered(f, xs):
  print(y)      # may be in any order
map 直接返回列表,而以 i 开头的两个函数返回的是迭代器;imap_unordered 返回的结果顺序是无序的。
当计算耗时较长时,可能需要添加进度条,此时 i 系列函数的优势便体现出来。另外有一个技巧:输出 \r 可以使光标回到行首而不换行,从而制作简易的进度条效果。
cnt = 0
for _ in pool.imap_unordered(f, xs):
  sys.stdout.write('done %d/%d\r' % (cnt, len(xs)))
  cnt += 1
更复杂的操作场景
若需执行更复杂的操作,可直接使用 multiprocessing.Process 对象。进程间通信可通过以下方式实现:
- multiprocessing.Pipe
- multiprocessing.Queue
- 同步原语
- 共享变量
其中,我强烈推荐 Queue,因为在许多场景下,生产者-消费者模型非常常见,使用 Queue 即可轻松解决。使用方法也很简单:先在父进程创建 Queue 实例,然后将其作为 args 或 kwargs 传递给 Process 即可。
使用 Theano 或 Tensorflow 等工具时的注意事项
需要注意的是,在 import theano 或 import tensorflow 等调用 CUDA 相关工具时,会产生一些副作用。这些副作用会被原样拷贝到子进程中,从而导致错误,例如:
could not retrieve CUDA device count: CUDA_ERROR_NOT_INITIALIZED
解决方法是:确保父进程不导入这些工具,而是在子进程创建完成后,由子进程各自进行导入。
如果使用 Process,请在 target 函数内部执行 import 操作。示例如下:
import multiprocessing

def hello(taskq, resultq):
  import tensorflow as tf
  config = tf.ConfigProto()
  config.gpu_options.allow_growth=True
  sess = tf.Session(config=config)
  while True:
    name = taskq.get()
    res = sess.run(tf.constant('hello ' + name))
    resultq.put(res)

if __name__ == '__main__':
  taskq = multiprocessing.Queue()
  resultq = multiprocessing.Queue()
  p = multiprocessing.Process(target=hello, args=(taskq, resultq))
  p.start()

  taskq.put('world')
  taskq.put('abcdabcd987')
  taskq.close()

  print(resultq.get())
  print(resultq.get())

  p.terminate()
  p.join()
如果使用 Pool,可以编写一个函数,在该函数内部执行 import,并将此函数作为 initializer 参数传入 Pool 的构造函数。示例如下:
import multiprocessing

def init():
  global tf
  global sess
  import tensorflow as tf
  config = tf.ConfigProto()
  config.gpu_options.allow_growth=True
  sess = tf.Session(config=config)

def hello(name):
  return sess.run(tf.constant('hello ' + name))

if __name__ == '__main__':
  pool = multiprocessing.Pool(processes=2, initializer=init)
  xs = ['world', 'abcdabcd987', 'Lequn Chen']
  print pool.map(hello, xs)
以上就是本文的全部内容,希望对大家的学习有所帮助,也欢迎大家继续支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









