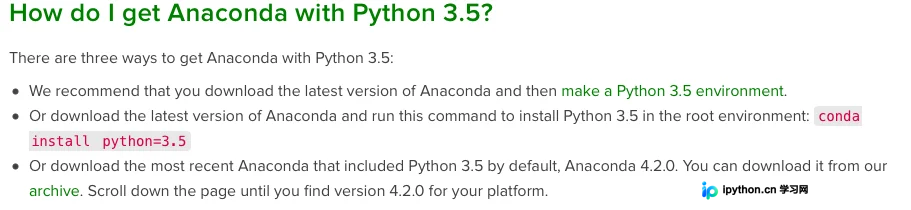
深入解析 NumPy 与 TensorFlow 中的 Broadcasting 广播机制
本文深入解析 NumPy 与 TensorFlow 中的 Broadcasting 广播机制。通过标量、二维及三维数组的具体案例,详细阐述后缘维度匹配规则、形状扩展逻辑及常见报错处理,帮助开发者高效进行张量运算。
2026-10-13
7


本文深入解析 NumPy 与 TensorFlow 中的 Broadcasting 广播机制。通过标量、二维及三维数组的具体案例,详细阐述后缘维度匹配规则、形状扩展逻辑及常见报错处理,帮助开发者高效进行张量运算。
本文介绍在Python中使用TensorFlow时如何精确控制GPU资源。通过设置CUDA_VISIBLE_DEVICES指定可用GPU,利用per_process_gpu_memory_fraction限制显存使用百分比,以及通过allow_growth=True实现按需最小化占用。适用于多GPU环境下的资源分配与显存优化场景。
本文介绍如何在运行TensorFlow Python程序时限制对GPU和CPU的占用。通过设置环境变量CUDA_VISIBLE_DEVICES指定可见GPU,或在代码中配置gpu_options.allow_growth实现显存按需分配。同时,提供了限制CPU线程数的方法,帮助优化资源使用,避免霸占所有GPU资源。
本文详解如何在TensorFlow中将8x8个32x32图像块重组为256x256图像。核心步骤包括利用tf.reshape调整维度,通过tf.concat进行行列拼接,以及处理batch_size维度时结合list与tf.stack。文章还指出了TensorFlow中直接赋值报错的解决方案,提供完整代码示例供深度学习开发者参考。
本文通过商品销量预测实例,详解如何在TensorFlow中自定义损失函数。针对均方误差无法反映预测偏差成本差异的问题,通过设定预测偏高与偏低的惩罚权重,构建分段损失函数。代码展示如何利用tf.where实现非对称惩罚,并对比不同权重设置对模型最终参数的影响,帮助开发者优化特定业务场景下的模型表现。
在TensorFlow调试过程中,打印大型Tensor时常因默认限制显示为省略号。本文介绍通过导入NumPy模块并调用set_printoptions(threshold=np.inf)函数,将打印阈值设置为无限大,从而完整输出Tensor所有数据,解决显示不全的问题。
本文针对TensorFlow在遍历图片进行风格迁移时内存持续增长的问题,分析了因在循环中重复调用tf计算导致计算图节点累积的根源。通过对比错误与正确代码示例,指出应将所有计算操作定义在模型构建阶段,利用Placeholder统一输入,避免在迭代过程中动态添加新节点,从而有效防止内存溢出。
本文详细介绍 TensorFlow 2.0 中张量的合并与分割操作。通过 tf.concat 实现沿指定轴合并张量,利用 tf.stack 创建新维度进行数据堆叠,并借助 tf.unstack 和 tf.split 执行解堆叠与分割。文章结合具体代码示例,解析各函数的参数设置、形状变化及适用场景,帮助开发者高效处理多维数据。
本文介绍如何使用Python和OpenCV库将普通图像文件转换为二进制格式。针对TensorFlow训练需读取二进制数据库的需求,通过遍历图像像素并写入二进制文件,实现图像数据的序列化存储与还原显示。
本文介绍如何在TensorFlow中从Variable类型的矩阵中提取指定元素并组成新的Tensor。通过一维数组和二维矩阵示例,详细演示了如何使用tf.gather_nd函数配合索引矩阵提取单个或批量元素,并推广至n维矩阵的处理方式。
本文详细讲解在Windows 10系统中为Python 3.7环境安装TensorFlow和Keras的步骤。重点强调必须使用64位Python,提供通过官方渠道或非官方预编译包(如UCI LFD)安装的方法,并包含使用cmd命令行切换目录及更新pip的操作指引,帮助开发者顺利完成深度学习环境搭建。
本文介绍在Anaconda中将Python版本从3.6降级至3.5的三种方法,以解决TensorFlow仅支持Python3.5的问题。包括新建独立环境、直接修改当前环境版本以及重新安装特定版本Anaconda,帮助用户灵活管理Python环境。