Python实现DNA序列One-Hot编码并存储为TFRecord文件及读取流程
本文介绍使用Python将DNA碱基序列转换为One-Hot编码矩阵,并存储为TensorFlow专用的TFRecord格式文件的全过程。内容涵盖随机序列生成、自定义编码函数实现、字节流转换、Example构建以及数据读取与解析方法,适用于生物信息学深度学习模型训练前的数据预处理环节。
2026-10-16
9


本文介绍使用Python将DNA碱基序列转换为One-Hot编码矩阵,并存储为TensorFlow专用的TFRecord格式文件的全过程。内容涵盖随机序列生成、自定义编码函数实现、字节流转换、Example构建以及数据读取与解析方法,适用于生物信息学深度学习模型训练前的数据预处理环节。
本文详细记录在Windows 10环境下,使用Anaconda和PyCharm安装TensorFlow 2.2的完整流程。涵盖从Visual Studio、Anaconda基础安装,到创建独立conda环境、配置CUDA 10.1与cuDNN 7.6 GPU支持,以及最后在PyCharm中绑定解释器并验证安装成功的全过程。
本文详细介绍如何在同一Python环境中共存安装TensorFlow 1.x与2.0版本。通过Anaconda创建独立虚拟环境,分别指定不同版本号进行安装,并利用国内镜像源加速下载。最后演示如何在PyCharm中切换Python解释器以调用特定版本的TensorFlow,解决新旧代码兼容性问题。
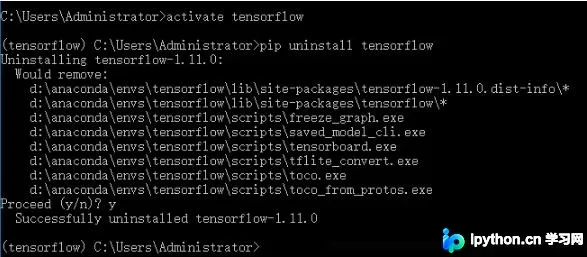
本文针对在Anaconda环境中安装TensorFlow-GPU后,Keras仍调用CPU进行计算的问题,分析了因同时存在tensorflow和tensorflow-gpu文件夹导致的默认调用冲突。通过彻底卸载现有库并重新在PyCharm中安装tensorflow-gpu和keras,成功实现GPU加速。
本文介绍在TensorFlow 2.0环境下训练模型后,如何将其转换为适用于TF 1.x的.pb模型文件。针对TF 2.0不再保存.meta文件的情况,提供了一种通过Keras中间层进行转换的方法。该方法要求模型结构完全基于tf.keras构建,且仅保存权重文件(.h5)。通过定义模型结构并加载权重,在TF 1.x环境中冻结计算图,生成可直接用于推理或进一步转换的.pb文件。
在 TensorFlow 中直接输出变量仅显示属性而非具体数值。本文介绍通过 InteractiveSession 结合 initializer.run() 初始化及 sess.run() 方法,正确获取并打印变量实际值的操作流程。
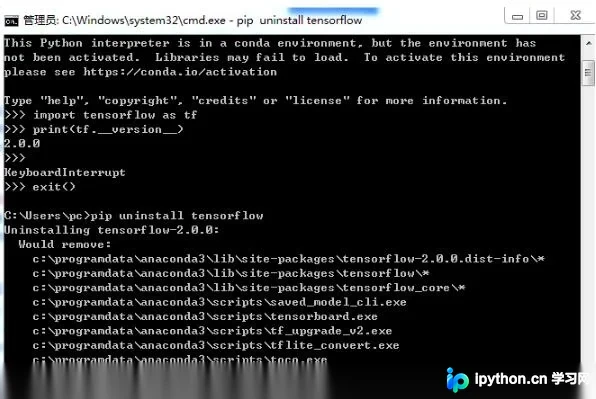
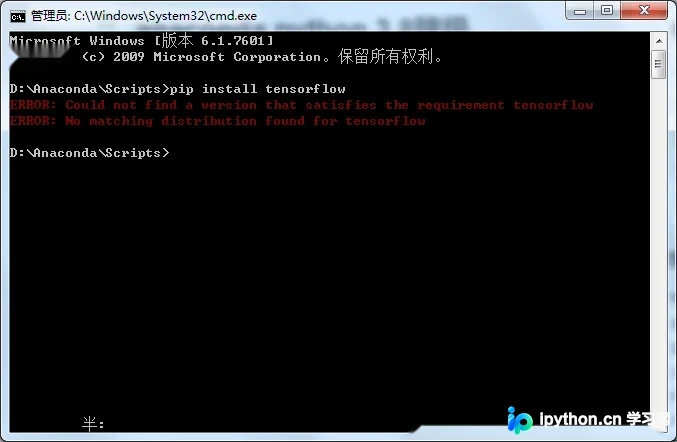
本文介绍在Anaconda环境中安装TensorFlow时,因Python版本过高(3.8)导致pip install报错的问题。通过Anaconda Prompt执行conda install python=3.7将环境降级至3.7版本,成功解决依赖冲突,完成TensorFlow的安装与测试。
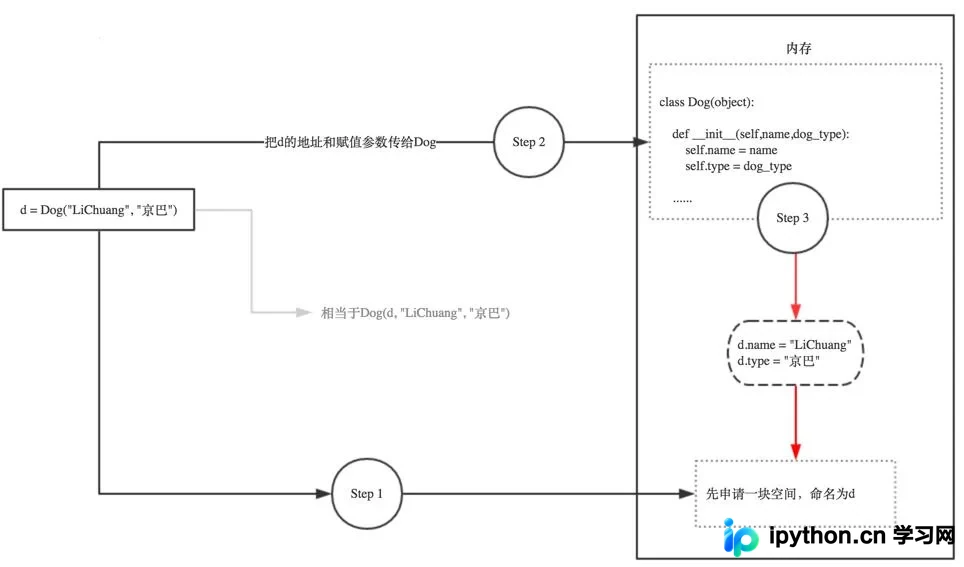
本文解析TensorFlow自定义Layer中__init__、build和call的执行顺序与区别,说明build仅在首次调用时初始化变量。同时深入讲解Python类中self的含义、必要性及常见错误,通过代码示例展示正确初始化实例变量的方法。
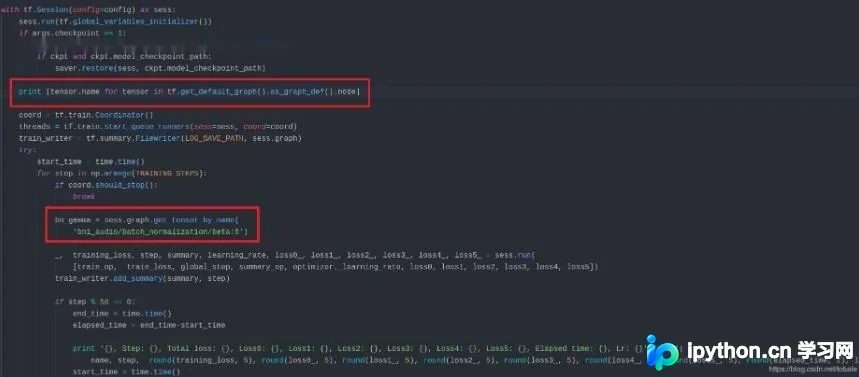
本文介绍在TensorFlow训练过程中获取指定Tensor值的方法,包括通过图节点名称提取参数。针对Conv1和BN1层出现NAN导致后续层输出为0且无法更新的问题,分析数据中NAN的影响,并提供获取Tensor名称及值的代码示例,帮助开发者排查模型训练异常。
本文详细记录了在Windows系统中将TensorFlow从CPU版本迁移至GPU版本时遇到的权限拒绝及DLL加载失败问题。重点分析了CUDA版本不兼容导致的错误,并提供了完整的解决步骤,包括清理残留文件、调整Visual Studio版本及正确配置CUDA 10.0与cuDNN环境,最终实现TensorFlow 1.13在Python 3.7下的成功运行。
本文介绍TensorFlow中Graph的基本操作,包括手动创建图、获取与重置默认图的方法,以及通过名称获取张量和节点操作的技巧。重点讲解get_tensor_by_name与get_operation_by_name的使用区别,并强调reset_default_graph前需释放资源。
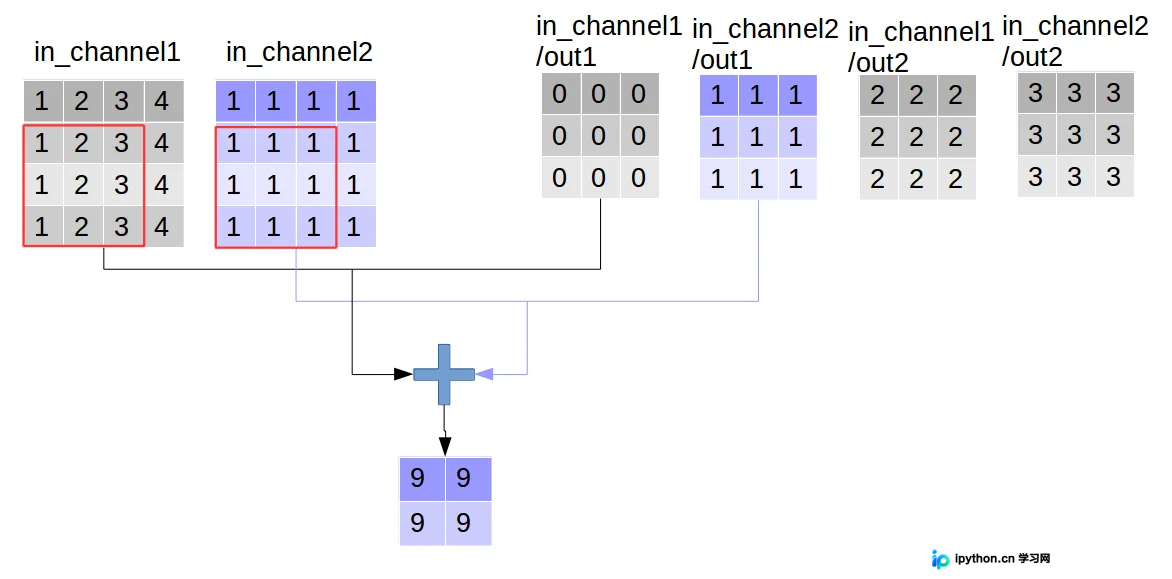
本文深入解析TensorFlow中tf.nn.depthwise_conv2d函数的实现原理。详细阐述其五个核心参数:input、filter、strides、padding和rate,并对比普通卷积与深度卷积在通道处理上的差异。通过构建自定义输入图像与卷积核的完整代码示例,直观展示深度卷积的计算过程与输出结果,帮助开发者理解并应用该技术在模型轻量化中的优势。