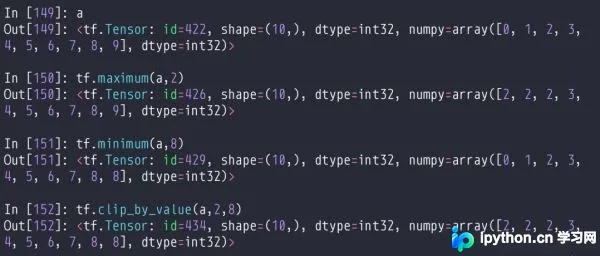
TensorFlow张量裁剪、排序及高阶操作详解
本文详细介绍TensorFlow中张量的核心高阶操作。涵盖按数值和范数进行张量裁剪以解决梯度爆炸问题,利用sort、argsort及topk进行数据排序与Top-K准确率计算。此外,解析tf.where条件筛选、tf.scatter_nd索引更新及tf.meshgrid网格生成等常用函数的具体用法与参数细节。
2026-10-14
6


本文详细介绍TensorFlow中张量的核心高阶操作。涵盖按数值和范数进行张量裁剪以解决梯度爆炸问题,利用sort、argsort及topk进行数据排序与Top-K准确率计算。此外,解析tf.where条件筛选、tf.scatter_nd索引更新及tf.meshgrid网格生成等常用函数的具体用法与参数细节。
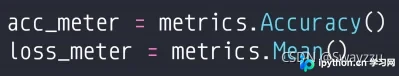
本文介绍TensorFlow中Keras高层接口的核心应用。首先详解metrics模块,涵盖创建、更新、获取及重置状态的完整流程,用于训练过程中的数据跟踪。其次讲解快捷训练接口,包括compile配置优化器与损失函数,以及fit、evaluate和predict的具体用法与参数设置,帮助开发者高效完成模型训练与评估。
本文介绍使用TensorFlow构建卷积神经网络(CNN)处理MNIST手写数字数据集的完整流程。网络包含两层卷积与池化及全连接层,通过1000至2000次迭代训练,测试集准确率分别达到98.6%与99.1%。相比传统神经网络,CNN凭借卷积核权值共享机制,在降低参数量与计算量的同时有效缓解过拟合,显著提升了模型性能。
本文介绍如何使用TensorFlow构建包含一个隐层的多层感知机(MLP)模型,以解决MNIST手写数字识别问题。相比基础的Softmax回归,引入隐层后模型准确率从92%提升至97%,误差率由8%降至3%。文章详细解析了网络结构、参数设置及训练效果,并探讨了全连接网络在MNIST上的性能瓶颈。
本文介绍使用TensorFlow构建Softmax逻辑回归模型识别MNIST手写数字数据集的方法。通过加载数据、定义模型并进行100次迭代训练,测试集准确率达到92.2%。文章还解析了相关TensorFlow函数的用法,适合深度学习初学者参考。
本文详解TensorFlow中张量与变量的核心概念。涵盖标量、向量、矩阵定义,介绍常数、随机张量创建方法,演示类型转换与形状重塑操作。同时阐述变量的定义、初始化及会话执行流程,帮助开发者掌握基础数据结构与操作。
本文详细记录TensorFlow中处理不定长文本序列的读取与解析方法,包括CSV数据拼接策略。深入探讨RNN、双向LSTM在序列预测与标签预测中的输入输出格式差异,解析多任务输出划分、Zero Padding处理及get_shape与tf.shape的区别。重点解决双向LSTM的信息瓶颈问题,提供拼接、平均和池化三种输出处理方案,帮助开发者规避常见踩坑点。
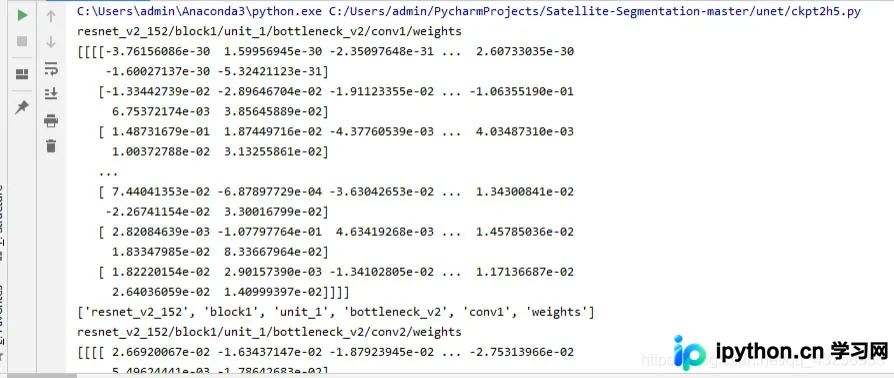
本文详细介绍如何利用TensorFlow的tf.train.NewCheckpointReader函数解读权重文件。通过get_variable_to_shape_map和get_tensor方法获取张量名称及数值,并深入解析ResNet_v2_152模型中tensor name的命名规则,包括block、unit及层类型。同时补充了TensorFlow模型调用过程中checkpoint、graph及model文件的生成机制与查看方法,适用于模型调试与部署参考。
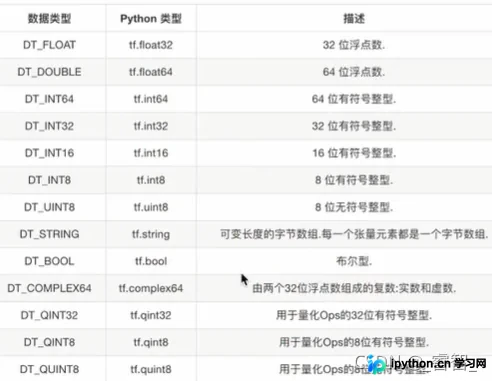
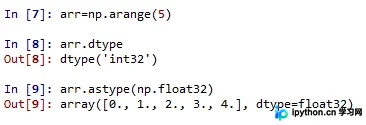
本文详细解析TensorFlow中的核心数据类型dtype,涵盖有符号/无符号整型、浮点数、字符串及布尔型等常用类型。重点介绍tf.as_dtype()函数的用法,以及如何通过dtype属性查看和astype方法进行数据类型转换,帮助开发者在模型构建中准确管理数据格式。
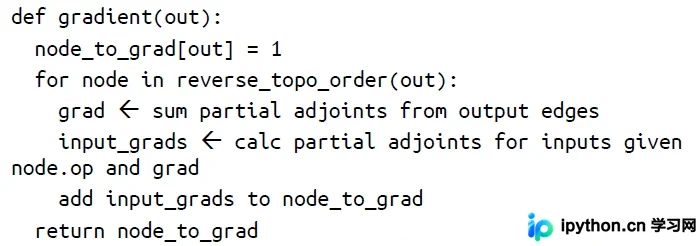
本文深入解析TensorFlow的自动求导(Automatic Differentiation)原理,阐述其如何结合符号与数值求导优势。重点介绍tf.GradientTape()在即时执行模式下的应用,通过y=x^2实例演示梯度计算流程,并解析math_grad.py中RegisterGradient装饰器的作用,帮助开发者理解模型训练中的梯度反向传播机制。
本文详细介绍在Python3环境下安装TensorFlow的完整流程。涵盖Anaconda下载、Conda虚拟环境创建、清华镜像源配置以解决依赖问题,以及针对特定Python版本的安装注意事项。同时整理“No space left on device”等常见报错的解决方案,帮助开发者顺利构建机器学习环境。
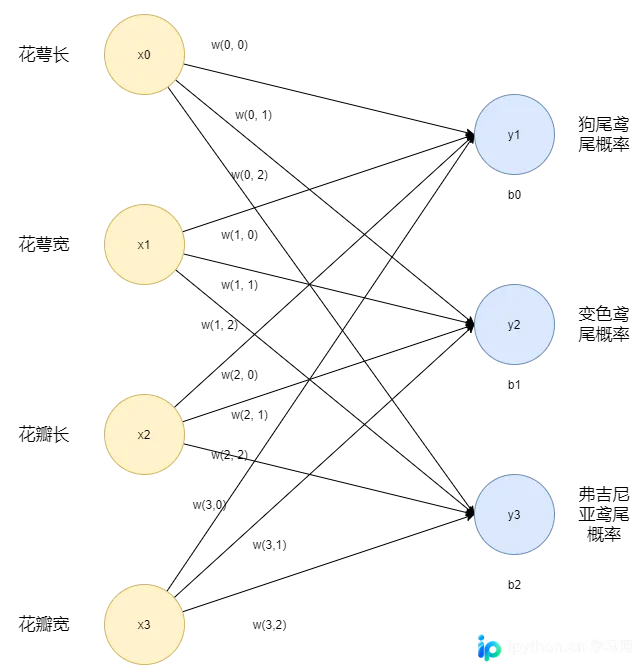
本文详细介绍如何使用Python和Tensorflow 2.0搭建BP神经网络进行鸢尾花分类。通过加载sklearn数据集,定义输入输出矩阵,利用均方误差作为损失函数,并采用梯度下降算法优化权重w和偏置b。代码涵盖数据预处理、模型训练及测试环节,最终实现高准确率的分类预测。