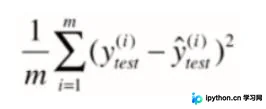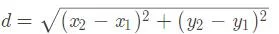Python sklearn中model.predict与predict_proba的区别解析

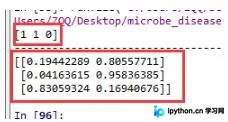
本文详细解析Python sklearn库中model.predict()与model.predict_proba()函数的核心区别。通过LogisticRegression示例代码,展示predict返回具体分类标签,而predict_proba返回各类别的概率分布。文章深入探讨了多分类场景下的概率输出逻辑,并解释了predict_proba结果如何依据self.classes_进行排序,帮助开发者准确理解模型输出格式。

Python sklearn中model.predict与predict_proba的区别解析

sklearn中predict与predict_proba的区别及缺类陷阱

本文详解sklearn中predict与predict_proba的区别:前者返回预测标签,后者返回各类别概率数组。重点指出当训练集缺失某些类别时,predict_proba列数会减少,导致predict结果与最大概率索引不一致。建议使用train_test_split的stratify参数保持数据分布一致,避免此类隐蔽Bug。

Python中导入train_test_split报错的解决方法

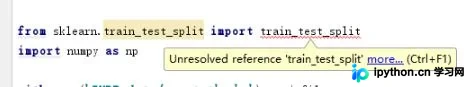
本文介绍在Python中使用sklearn时导入train_test_split报错的解决方案。主要原因为模块位置变更,需从model_selection导入。同时提供解决模块找不到的pip安装命令及处理Windows权限拒绝错误的建议。

Python中导入train_test_split报错的解决方法

sklearn实现线性与非线性逻辑回归详解

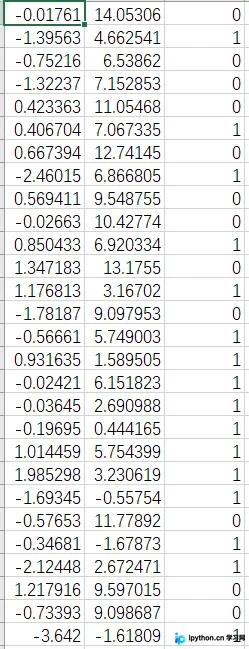
本文通过Python代码演示如何利用sklearn库实现线性与非线性逻辑回归。文章首先介绍线性逻辑回归在简单数据集上的建模、拟合及评估过程,随后深入讲解非线性逻辑回归中通过多项式特征扩展决策边界的方法。对比两者在代价函数与预估函数复杂度上的异同,并展示高准确率的分类结果,帮助读者掌握sklearn在分类任务中的核心应用。

sklearn实现线性与非线性逻辑回归详解

Python Sklearn自动化机器学习流程:从预处理到混淆矩阵与分类报告

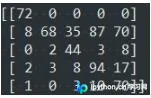
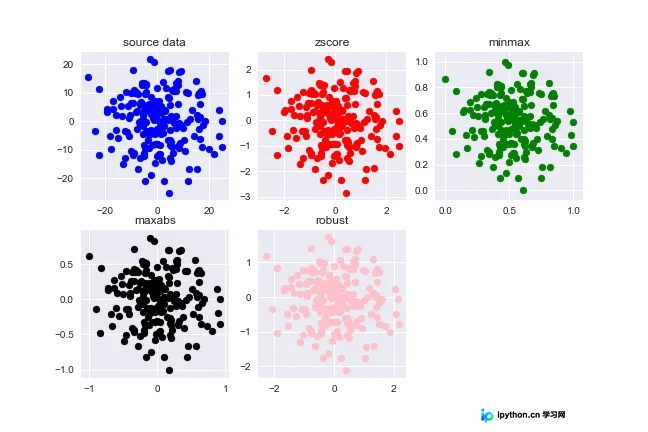
本文详细介绍基于Python Sklearn库的机器学习自动化处理流程。涵盖数据预处理(L2正则化)、特征选择(卡方检验)、降维(PCA)及模型训练。重点解析如何自动生成混淆矩阵以统计多分类预测结果,以及利用classification_report获取准确率、召回率和F-值等关键指标,辅助评估算法性能。

Python Sklearn自动化机器学习流程:从预处理到混淆矩阵与分类报告

Python中MSE、RMSE、MAE与R2的计算及sklearn实现

本文详细介绍Python中回归模型常用的评估指标:均方误差(MSE)、均方根误差(RMSE)、平均绝对误差(MAE)及决定系数(R2)。内容涵盖从原生Python列表推导到NumPy向量化计算的多种实现方式,并演示如何利用sklearn库快速调用相关函数进行模型评估,帮助开发者理解各指标的计算逻辑与应用场景。

Python中MSE、RMSE、MAE与R2的计算及sklearn实现

Python使用sklearn实现KNN分类算法详解

本文详细介绍如何使用Python的sklearn库实现KNN(K-Nearest Neighbors)分类算法。内容涵盖算法原理、核心步骤、距离计算方式及参数设置,并通过鸢尾花数据集的代码示例演示训练与预测过程,帮助读者快速掌握该基础分类模型的应用。

Python使用sklearn实现KNN分类算法详解

Python实现Lasso回归与弹性网络对比详解

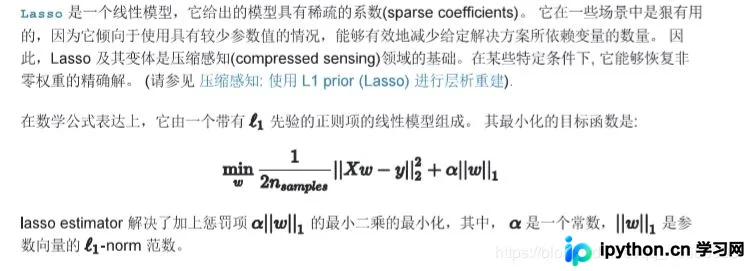
本文详细介绍如何使用Python和scikit-learn库实现Lasso回归,并通过代码示例展示其与弹性网络(Elastic Net)在稀疏数据场景下的性能对比。文章包含数据生成、模型训练、参数设置及可视化结果分析,帮助读者理解正则化方法对特征选择的影响。

Python实现Lasso回归与弹性网络对比详解