

Python数据预处理:掌握四种数据标准化方法

本文介绍Python中数据标准化的四种核心方法:Max-Min归一化、Z-Score标准化、MaxAbs绝对值标准化及RobustScaler鲁棒标准化。通过Sklearn库实现,解析各方法适用场景,如稀疏数据与含离群点数据的处理,助力提升模型训练效果。
数据标准化定义
数据标准化定义
在正式进行数据分析前,通常需要对原始数据进行标准化(normalization)处理,以便基于处理后的数据开展后续分析。所谓数据标准化,即统计数据的指数化过程,主要包含数据同趋化处理与无量纲化处理两个维度。数据同趋化处理旨在解决不同性质指标间无法直接加总的问题,通过调整逆指标数据的性质,使所有指标对评估方案的作用力方向一致,从而得出准确的综合结果。数据无量纲化处理则主要解决不同数据间的可比性问题。
常见的标准化方法
常见的标准化方法
Max-Min归一化
Max-Min归一化
Min-Max标准化是对原始数据进行线性变换的方法。假设属性A的最小值为minA,最大值为maxA,将A的原始值x通过Min-Max标准化映射到区间[0,1]内的新值x',其计算公式为:
新数据 = (原数据 - 最小值) / (最大值 - 最小值)
该方法能将数据映射到特定区间内,且不会改变原始数据的结构分布。
Z-Score中心化标准化
Z-Score中心化标准化
Z-Score标准化基于原始数据的均值(mean)和标准差(standard deviation)进行变换,将属性A的原始值x标准化为x'。
当属性A的最大值和最小值未知,或数据中存在超出取值范围的离群点时,Z-Score标准化尤为适用。
新数据 = (原数据 - 均值) / 标准差
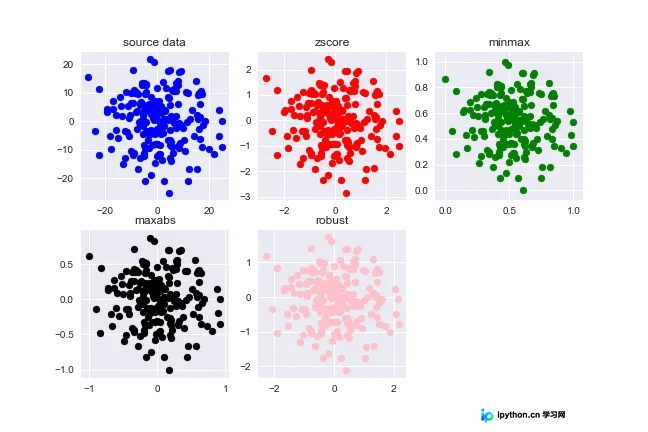
这是大多数数据类型适用的标准化方式,也是许多分析工具的默认选项。标准化后的数据服从均值为0、方差为1的正态分布。然而,Z-Score属于中心化方法,会改变原有数据的分布结构,因此不适用于稀疏数据的处理。
实际数据集中常存在稀疏特征,表现为标准差较小且大量元素值为0,例如协同过滤中常见的数据集,其绝大部分数据均为0。若对稀疏数据采用中心化标准化,会破坏其原有的稀疏结构,导致信息失真。
MaxAbs稀疏数据标准化
MaxAbs稀疏数据标准化
最大值绝对值标准化(MaxAbs)依据最大值的绝对值进行标准化。设原始转换数据为x,新数据为x',则x' = x / |max|,其中max为x所在列的最大值。
该方法生成的数据区间为[-1, 1],且保持原数据结构不变,因此同样适用于稀疏数据及稀疏矩阵的处理。
针对离群点的RobustScaler标准化
针对离群点的RobustScaler标准化
当数据集中存在离群点时,使用Z-Score标准化往往效果不佳,因为离群点在标准化后会丧失其极端特性。RobustScaler专门针对离群点进行标准化处理,该方法对数据中心化数据的缩放具有更强的参数控制能力和鲁棒性。
Python代码实现
Python代码实现
import numpy as np
import pandas as pd
from sklearn import preprocessing
import matplotlib.pyplot as plt
from sklearn.datasets import make_moons
import matplotlib.pyplot as plt
%matplotlib inline

# 导入数据
data = make_moons(n_samples=200, noise=10)[0]

#Z-Score标准化
#建立StandardScaler对象
zscore = preprocessing.StandardScaler()
# 标准化处理
data_zs = zscore.fit_transform(data)

#Max-Min标准化
#建立MinMaxScaler对象
minmax = preprocessing.MinMaxScaler()
# 标准化处理
data_minmax = minmax.fit_transform(data)

#MaxAbs标准化
#建立MinMaxScaler对象
maxabs = preprocessing.MaxAbsScaler()
# 标准化处理
data_maxabs = maxabs.fit_transform(data)

#RobustScaler标准化
#建立RobustScaler对象
robust = preprocessing.RobustScaler()
# 标准化处理
data_rob = robust.fit_transform(data)

# 可视化数据展示
# 建立数据集列表
data_list = [data, data_zs, data_minmax, data_maxabs, data_rob]
# 创建颜色列表
color_list = ['blue', 'red', 'green', 'black', 'pink']
# 创建标题样式
title_list = ['source data', 'zscore', 'minmax', 'maxabs', 'robust']

# 设置画幅
plt.figure(figsize=(9, 6))
# 循环数据集和索引
for i, dt in enumerate(data_list):
  # 子网格
  plt.subplot(2, 3, i+1)
  # 数据画散点图
  plt.scatter(dt[:, 0], dt[:, 1], c=color_list[i])
  # 设置标题
  plt.title(title_list[i])
# 图片储存
plt.savefig('xx.png')
# 图片展示
plt.show()
参考书籍:《Python数据分析与数据化运营》作者:宋天龙
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









