

Python sklearn分类决策树方法详解
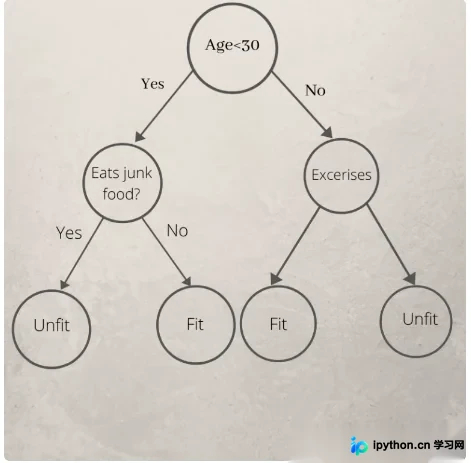
本文详细解析基于Python sklearn库的决策树分类方法。内容涵盖决策树的基本结构、ID3/C4.5/CART算法原理及特征选择准则,并通过完整代码示例演示如何利用Scikit-learn构建、训练及可视化决策树模型,适用于数据分类任务。
2026-10-16
6

本文详细解析基于Python sklearn库的决策树分类方法。内容涵盖决策树的基本结构、ID3/C4.5/CART算法原理及特征选择准则,并通过完整代码示例演示如何利用Scikit-learn构建、训练及可视化决策树模型,适用于数据分类任务。
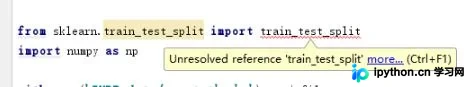
本文介绍在Python中使用sklearn时导入train_test_split报错的解决方案。主要原因为模块位置变更,需从model_selection导入。同时提供解决模块找不到的pip安装命令及处理Windows权限拒绝错误的建议。
本文通过sklearn演示线性回归案例,分析波士顿房价数据的欠拟合问题。介绍如何使用Pipeline构建多项式特征以优化模型,对比不同degree下的训练与测试得分,揭示过拟合风险。最后深入比较梯度下降与正规方程两种求解方式的适用场景与优缺点,为模型选择提供参考。
本文详细介绍如何使用Python的sklearn库实现KNN(K-Nearest Neighbors)分类算法。内容涵盖算法原理、核心步骤、距离计算方式及参数设置,并通过鸢尾花数据集的代码示例演示训练与预测过程,帮助读者快速掌握该基础分类模型的应用。
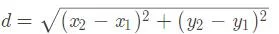
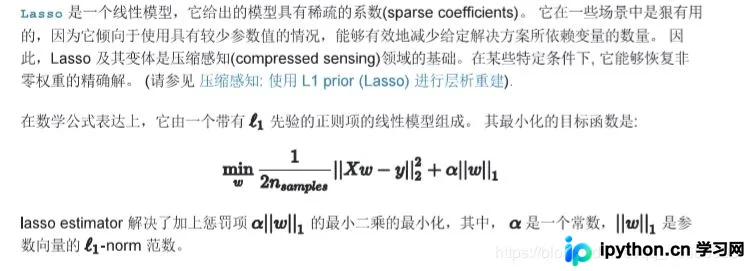
本文详细介绍如何使用Python和scikit-learn库实现Lasso回归,并通过代码示例展示其与弹性网络(Elastic Net)在稀疏数据场景下的性能对比。文章包含数据生成、模型训练、参数设置及可视化结果分析,帮助读者理解正则化方法对特征选择的影响。
本文详解Python中sklearn库的One-Hot编码技术。阐述将离散特征映射至欧式空间以优化距离计算的原理,并通过具体代码示例解析OneHotEncoder的使用,包括fit与transform方法的输出结果及维度分析,帮助开发者掌握特征预处理技巧。
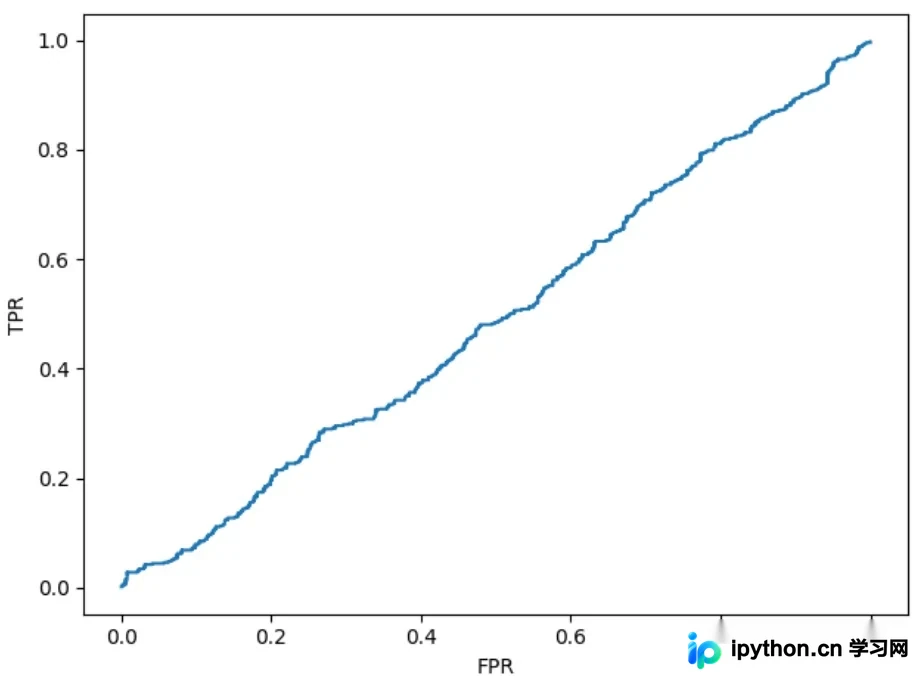
本文总结Python中计算AUC(ROC曲线下面积)的三种常用方法。首先介绍使用sklearn库直接计算的方式,其次详解通过遍历阈值计算面积的方法,最后讲解基于样本排序简化计算的算法。文章提供完整代码示例及运行结果分析,帮助开发者理解不同实现逻辑及其适用场景。
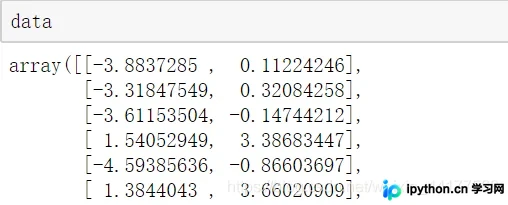
本文详细介绍sklearn中make_blobs函数的用法,涵盖n_features、n_samples、centers、random_state及cluster_std等核心参数的含义与配置方法,通过具体代码示例展示如何生成指定特征、样本量及方差的多类聚类数据集,并说明随机种子对结果复现的重要性。
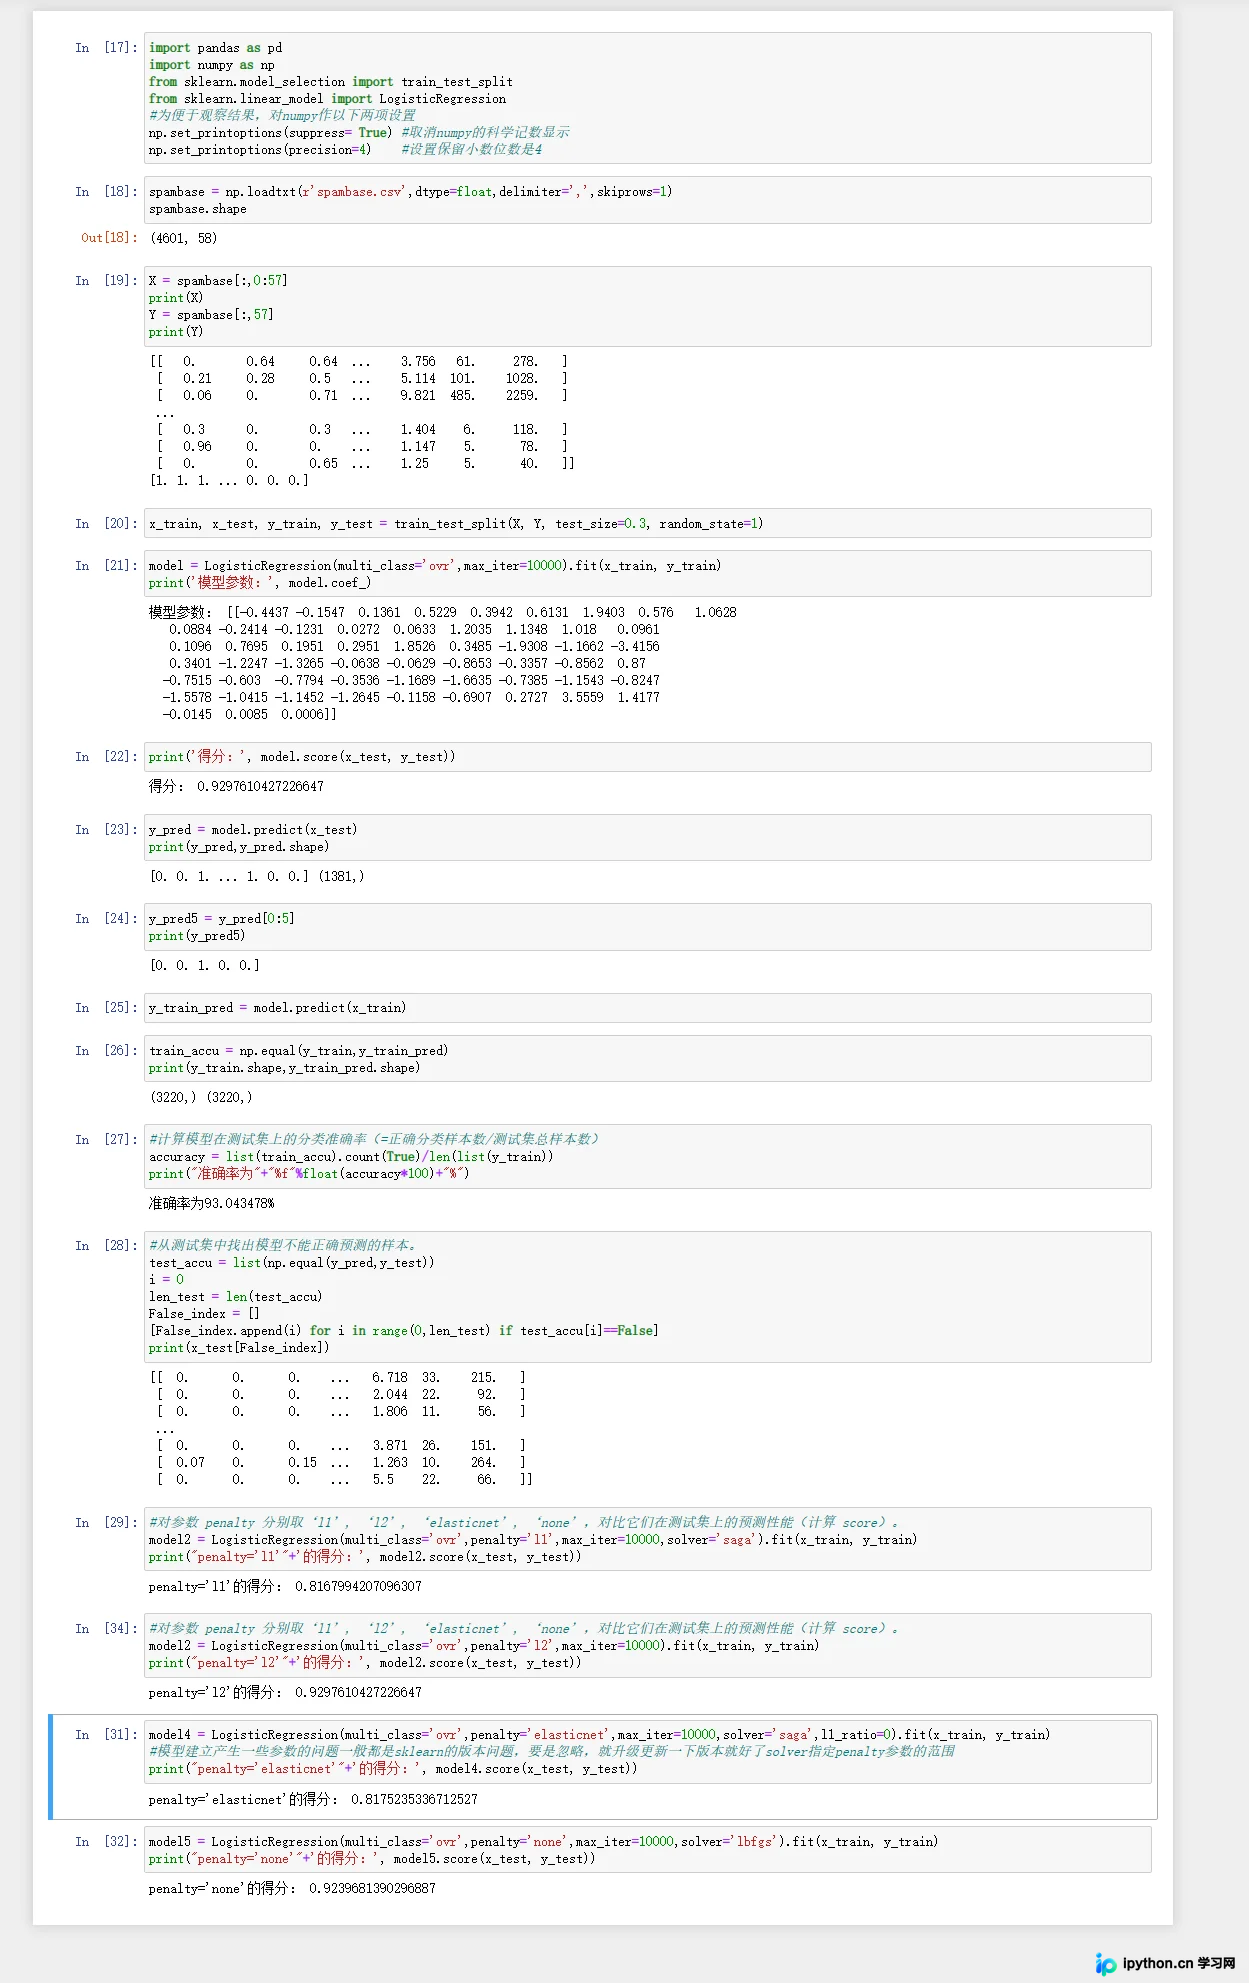
本文详细介绍如何使用Python和逻辑回归算法对垃圾邮件数据集进行分类。内容涵盖数据预处理、训练集与测试集划分、模型构建及参数调优。通过对比l1、l2、elasticnet和none等不同惩罚项对模型性能的影响,并计算分类准确率及错误样本,帮助读者掌握逻辑回归在文本分类中的实际应用。
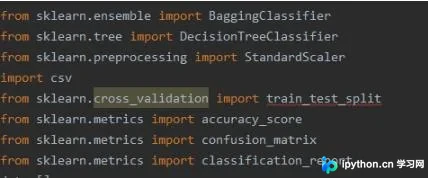
本文介绍PyCharm中解决Unresolved reference 'sklearn'错误的两种方法。首先通过修改Console设置勾选Add source roots to PYTHONPATH并重启IDE;其次针对Python 3.6中sklearn弃用cross_validation的情况,建议使用model_selection模块导入train_test_split。
本文详细解析Python sklearn库中model.predict()与model.predict_proba()函数的核心区别。通过LogisticRegression示例代码,展示predict返回具体分类标签,而predict_proba返回各类别的概率分布。文章深入探讨了多分类场景下的概率输出逻辑,并解释了predict_proba结果如何依据self.classes_进行排序,帮助开发者准确理解模型输出格式。
本文详细介绍如何在Python中使用matplotlib库可视化打印混淆矩阵,涵盖sklearn.metrics.confusion_matrix与tf.confusion_matrix两个核心API的参数解析、对比及完整代码示例,帮助开发者直观评估分类模型性能。