

Python Sklearn自动化机器学习流程:从预处理到混淆矩阵与分类报告

本文详细介绍基于Python Sklearn库的机器学习自动化处理流程。涵盖数据预处理(L2正则化)、特征选择(卡方检验)、降维(PCA)及模型训练。重点解析如何自动生成混淆矩阵以统计多分类预测结果,以及利用classification_report获取准确率、召回率和F-值等关键指标,辅助评估算法性能。
机器学习自动化流程概述
前言:在近期的数据处理任务中,为了提取特征并运用机器学习算法验证不同特征组合的效果,需要调用一系列常用函数。本文将记录这一完整流程中涉及的关键函数,包括数据预处理、特征提取、降维、训练预测,以及通过混淆矩阵和分类报告评估模型效果的方法。
数据输入与预处理
1. 输入数据准备
流程始于数据集,需提取特征并转化为带标签的数据集,进而转换为向量形式。随后将数据拆分为训练集和测试集。关于数据集拆分的具体实现,可参考前文提到的StratifiedKFold()函数用法。训练集包含特征数据data和标签target。
2. 数据处理与特征工程
核心处理函数实现
def my_preprocessing(train_data):
  from sklearn import preprocessing
  X_normalized = preprocessing.normalize(train_data ,norm = "l2",axis=0)#使用l2范式,对特征列进行正则
  return X_normalized

def my_feature_selection(data, target):
  from sklearn.feature_selection import SelectKBest
  from sklearn.feature_selection import chi2
  data_new = SelectKBest(chi2, k= 50).fit_transform(data,target)
  return data_new

def my_PCA(data):#data without target, just train data, withou train target.
  from sklearn import decomposition
  pca_sklearn = decomposition.PCA()
  pca_sklearn.fit(data)
  main_var = pca_sklearn.explained_variance_
  print sum(main_var)*0.9
  import matplotlib.pyplot as plt
  n = 15
  plt.plot(main_var[:n])
  plt.show()

def clf_train(data,target):
  from sklearn import svm
  #from sklearn.linear_model import LogisticRegression
  clf = svm.SVC(C=100,kernel="rbf",gamma=0.001)
  clf.fit(data,target)

  #clf_LR = LogisticRegression()
  #clf_LR.fit(x_train, y_train)
  #y_pred_LR = clf_LR.predict(x_test)
  return clf

def my_confusion_matrix(y_true, y_pred):
  from sklearn.metrics import confusion_matrix
  labels = list(set(y_true))
  conf_mat = confusion_matrix(y_true, y_pred, labels = labels)
  print "confusion_matrix(left labels: y_true, up labels: y_pred):"
  print "labels\t",
  for i in range(len(labels)):
    print labels[i],"\t",
  print
  for i in range(len(conf_mat)):
    print i,"\t",
    for j in range(len(conf_mat[i])):
      print conf_mat[i][j],'\t',
    print
  print

def my_classification_report(y_true, y_pred):
  from sklearn.metrics import classification_report
  print "classification_report(left: labels):"
  print classification_report(y_true, y_pred)
my_preprocess()函数实现如下:
该函数主要调用sklearn.preprocessing模块中的normalize()函数。默认采用l2范式对特征列进行正则化处理,确保每个样本处理后每行的平方和为1。
my_feature_selection()函数实现如下:
此函数利用sklearn.feature_selection模块中的SelectKBest()和chi2()函数。当使用词袋模型提取出大量高维稀疏特征时,通过卡方检验选取前k个有效特征是非常必要的步骤。
my_PCA()函数实现如下:
该函数主要用于观察前多少个特征为主要特征,并通过绘图展示前多少个特征占据了数据的主要部分。
clf_train()函数实现如下:
此函数支持多种机器学习算法,如SVM、LR、RF、GBDT等。对于需要调参的算法(如SVM),可结合StratifiedKFold()函数(详见前几篇博客)进行参数调试,以达到最优模型效果。
模型评估与结果分析
my_confusion_matrix()函数实现如下:
该函数用于对比预测结果与原始结果,自动计算混淆矩阵,无需手动计算。它会对每个类别的混淆矩阵进行计算,且labels参数默认已排序。
my_classification_report()函数实现如下:
该函数调用sklearn.metrics模块中的classification_report(),针对每个类别提供详细的准确率、召回率和F-值,以及宏平均值,用于评估算法性能。需要注意的是,ROC曲线仅适用于二分类任务,多分类场景下可能不适用。
主要参考sklearn官方文档。
补充拓展:[sklearn] 混淆矩阵——多分类预测结果统计
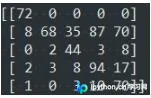
调用的函数为:confusion_matrix(typeTrue, typePred)
typeTrue:实际类别,类型为list。
typePred:预测类别,类型为list。
结果展示如截图所示:
第i行表示实际为第i类的样本,被预测到各个类的数量。
第j列表示预测为第j类的样本,其实际所属各个类的数量。
坐标轴说明:true↓(行)表示实际类别,predict→(列)表示预测类别。
以上关于Python Sklearn包中混淆矩阵、分类报告等自动生成方式的分享完毕,希望能对大家有所帮助,也欢迎多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









