使用sklearn LabelEncoder实现标签标准化与连续编码
本文介绍如何使用sklearn.preprocessing.LabelEncoder将分类标签转换为0到n_classes-1之间的连续整数编码。通过fit、transform和inverse_transform方法,可实现标签的标准化处理。文中提供了针对Series、DataFrame整体及特定列的多种转换示例,包括自定义多列编码器类的使用,帮助开发者高效完成分类数据的预处理工作。
2026-10-13
3

本文介绍如何使用sklearn.preprocessing.LabelEncoder将分类标签转换为0到n_classes-1之间的连续整数编码。通过fit、transform和inverse_transform方法,可实现标签的标准化处理。文中提供了针对Series、DataFrame整体及特定列的多种转换示例,包括自定义多列编码器类的使用,帮助开发者高效完成分类数据的预处理工作。
本文详解Python中sklearn库的One-Hot编码技术。阐述将离散特征映射至欧式空间以优化距离计算的原理,并通过具体代码示例解析OneHotEncoder的使用,包括fit与transform方法的输出结果及维度分析,帮助开发者掌握特征预处理技巧。
本文详细讲解如何利用Python实现感知机(PLA)算法,涵盖原始形式与对偶形式的代码实现及实验结果对比。同时演示如何调用sklearn库中的Perceptron类进行模型训练与评估,通过具体案例展示分类准确率与错误率,帮助读者理解线性分类器的核心逻辑与工程应用。
本文介绍Python中处理非数值类别数据的三种方法:使用LabelEncoder快速转换、通过字典映射手动指定数值,以及利用get_dummies生成虚拟变量。内容涵盖具体代码实现与适用场景,帮助开发者高效完成数据预处理。
本文详解在Python中利用Pandas、Numpy和Sklearn库实现数据随机打乱、抽样及分割的方法。通过plotly内置数据集演示,涵盖DataFrame的sample函数按行/列抽样、sklearn.utils.shuffle与random模块打乱索引、np.random.permutation生成随机索引,以及train_test_split进行80/20数据划分的具体代码与参数设置。
本文介绍如何利用Python构建一个可视化的大数据预测集成工具。通过整合sklearn进行多元回归模型训练,结合Tkinter开发GUI界面,实现了从数据读取、模型拟合到预测结果可视化的完整流程。工具支持手动输入与文件批量预测,旨在简化大数据预测的应用门槛,提供直观的决策辅助。
本文详解Python线性回归模型中的拟合优度检验标准,重点解析判定系数R^2的含义、计算公式及评估标准。通过总体平方和、回归平方和与残差平方和的关系,结合具体代码示例演示如何计算R^2并评估模型准确性,帮助开发者掌握模型验证的核心方法。
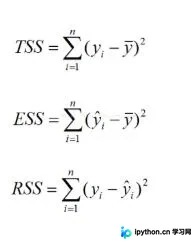
针对分类模型排序质量的评估需求,本文详细解析ROC曲线与AUC指标的计算原理,提供基于Python与sklearn库的完整实现方案。通过导入鸢尾花数据集、执行标签二值化与One-vs-Rest策略训练线性SVM模型,代码可直接输出ROC曲线图及对应的AUC评分,帮助快速验证模型在不同阈值下的泛化性能。
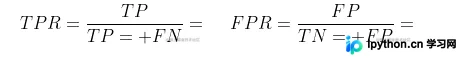
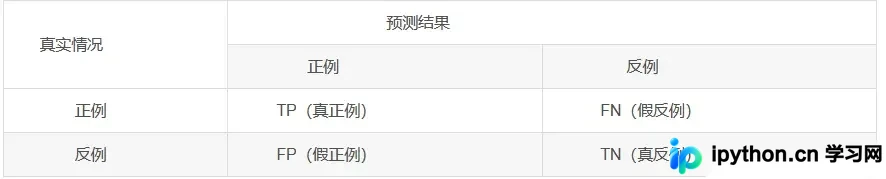
在机器学习分类任务中,混淆矩阵是量化模型性能的核心工具。本文基于 Python 和 sklearn 库,详细演示如何从原始预测数据中提取真实值与预测值,准确计算 TP、FP、TN、FN 等基础指标,并分步实现 Seaborn 热力图与官方可视化组件的代码编写。掌握该流程可快速定位模型误判分布,指导后续的特征工程与超参数调优。
本文详解sklearn中predict_proba与predict的区别。predict_proba返回所有类别的概率值,列数由分类数量决定,按self.classes_排序。通过示例展示如何解读概率值(如大于0.5判定为某类),并对比predict直接返回预测标签。包含逻辑回归与SVM的完整代码及可视化示例,帮助理解概率输出机制。