Scrapy 数据存入 MySQL:同步与异步实现详解
本文详细介绍 Scrapy 框架将数据持久化至 MySQL 数据库的两种核心方式:同步操作与基于 Twisted 的异步存储。文章涵盖 pipelines.py 配置、数据库连接池建立及错误处理机制,并针对中文乱码、特殊字符报错及重复数据累积问题提供具体解决方案,包括使用 pymysql.escape_string 和 scrapy-deltafetch 等插件实现增量爬取。
2026-10-13
6

本文详细介绍 Scrapy 框架将数据持久化至 MySQL 数据库的两种核心方式:同步操作与基于 Twisted 的异步存储。文章涵盖 pipelines.py 配置、数据库连接池建立及错误处理机制,并针对中文乱码、特殊字符报错及重复数据累积问题提供具体解决方案,包括使用 pymysql.escape_string 和 scrapy-deltafetch 等插件实现增量爬取。
本文详细介绍Python爬虫框架Scrapy的基础使用,涵盖环境安装、项目创建及目录结构解析。通过一个具体的题库抓取案例,演示如何编写Spider、定义Items、配置Pipeline以及处理数据库存储,帮助开发者快速掌握Scrapy的核心流程与代码实现。
本文详细介绍在Scrapy框架中实现网站登录的三种常见方式。第一种通过预置Cookies直接访问;第二种手动解析网页获取隐藏字段后发送POST请求;第三种利用FormRequest.from_response自动处理表单提交。文章提供完整代码示例,帮助开发者掌握不同场景下的登录策略。
本文详细介绍如何使用Python Scrapy框架搭建第一个爬虫项目。内容涵盖从创建项目、定义抓取字段、编写Spider逻辑到配置管道保存数据至MongoDB的完整流程,帮助初学者快速掌握Scrapy的核心使用方法。
本文解析在Python Scrapy爬虫中将数据存入Elasticsearch的两种方法。首先介绍基于elasticsearch-dsl的基础写入,指出其无法控制主键导致重复数据的问题。随后详解第二种方法,通过Elasticsearch客户端指定自定义_id实现覆盖插入,并展示如何在settings.py中注册Pipeline及执行查询操作,适用于ES 5.6.1版本。
本文详细讲解在Python3 Scrapy框架中配置IP代理的方法。针对阿里云IP代理参数变更及公共IP池不可用的问题,提出结合阿里云API生成有效IP池并在middlewares.py中通过process_request动态设置request.meta['Proxy-Authorization']的解决方案,确保爬虫稳定运行。
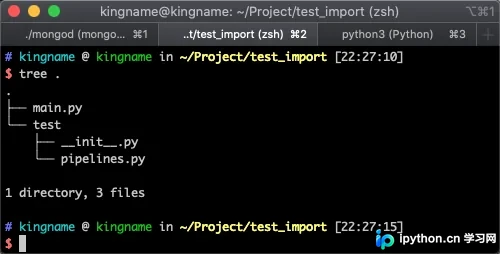
本文详解Python中通过字符串动态导入模块的方法。以Scrapy源码为例,解析如何利用importlib.import_module结合getattr函数,根据完整路径字符串加载指定类。文章提供从路径分割、模块导入到属性获取的完整步骤,并附带测试代码验证其有效性,适用于需要动态加载组件的场景。
本文详解如何在Scrapy框架中集成Selenium以解决动态加载数据的抓取难题。通过重写爬虫构造方法与关闭方法管理浏览器实例,并在下载中间件中拦截Response对象,利用Selenium渲染页面后篡改响应数据,从而在Spider中获取完整的动态内容。
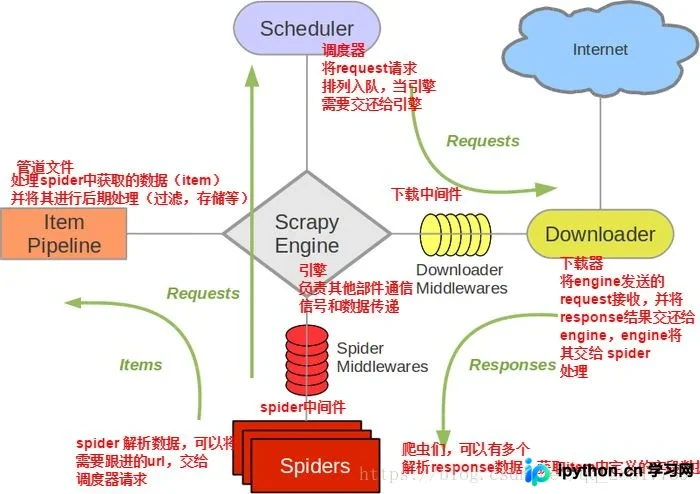
本文详解如何使用Python Scrapy框架爬取豆瓣电影Top250数据,并通过自定义Pipeline将结果持久化至MongoDB数据库。内容涵盖items定义、Spider编写、Pipeline配置及Settings设置,提供完整代码示例与测试步骤,帮助开发者掌握Web爬虫与数据库存储的结合应用。
本文详细演示如何使用Scrapy框架创建爬虫项目,定义Items数据结构,编写Spider解析网页HTML并提取职位信息,最后通过Pipeline将数据持久化存储到MongoDB数据库中。涵盖从项目初始化、代码编写到数据落地的完整流程,适合初学者快速掌握Scrapy核心用法。
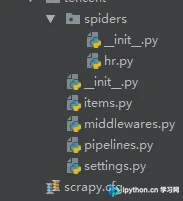
本文详细介绍在Windows系统中为Python3环境安装Scrapy爬虫框架的完整流程。重点讲解通过wheel文件手动安装lxml、zope.interface、pyOpenSSL、Twisted及pywin32等关键依赖项的方法,并针对Python 3.6版本常见的Python.h缺失报错提供具体的apt-get解决方案,帮助用户顺利搭建开发环境。
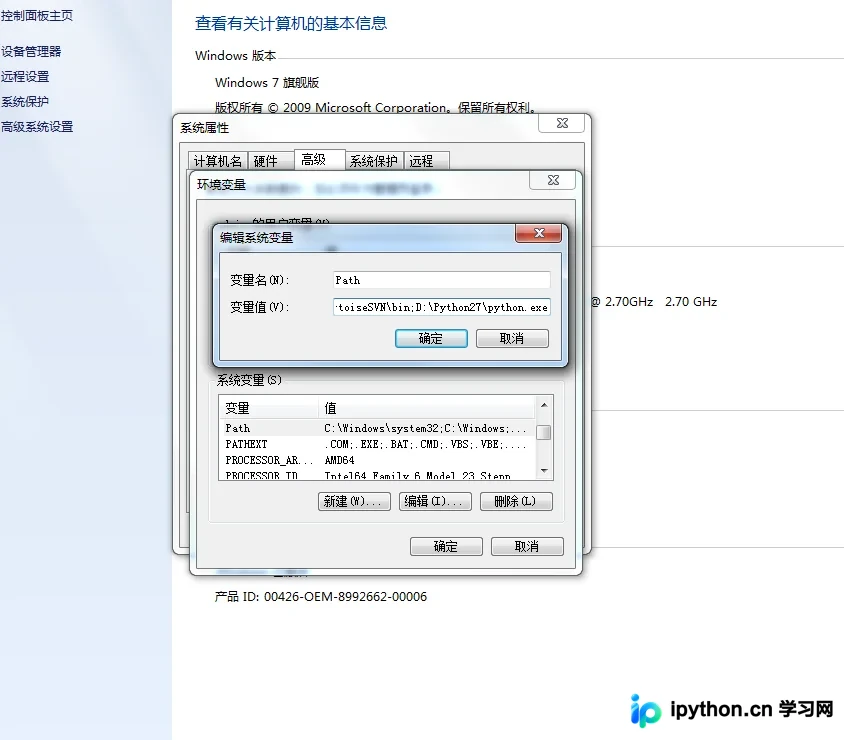
本文详细介绍在 Python 环境中安装 Scrapy 爬虫框架的完整步骤。内容涵盖 Python 环境变量配置、pywin32 组件安装、pip 工具部署以及通过命令行执行安装命令的全过程。最后提供验证 Scrapy 是否安装成功的方法,帮助开发者快速搭建爬虫开发基础环境。