

Scrapy异常处理实战:捕获HTTP错误与代码异常
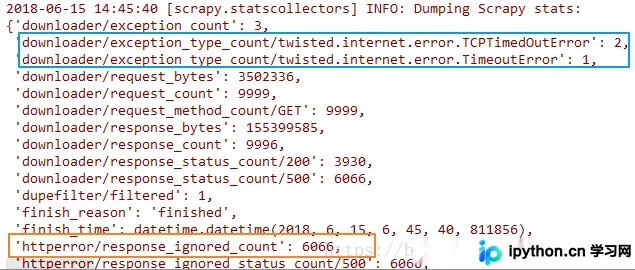
本文详解Scrapy中处理下载错误的两种主要场景:HTTP状态码异常(如403/500)与代码执行异常。通过深入分析RetryMiddleware源码,揭示process_response与process_exception的工作机制,并提供一个自定义中间件模板,用于兜底捕获未重试成功的请求,确保爬虫在长时间运行时的稳定性与数据完整性。
2026-10-14
6

本文详解Scrapy中处理下载错误的两种主要场景:HTTP状态码异常(如403/500)与代码执行异常。通过深入分析RetryMiddleware源码,揭示process_response与process_exception的工作机制,并提供一个自定义中间件模板,用于兜底捕获未重试成功的请求,确保爬虫在长时间运行时的稳定性与数据完整性。
本文详细解析 Scrapy 中 settings.py 的关键配置项。涵盖字符编码设置、Redis 连接参数(含密码与数据库指定)、请求超时与重试机制优化,以及基于 scrapy-redis 的去重组件、调度器和持久化断点续爬功能的配置方法。通过调整 DUPEFILTER_CLASS、SCHEDULER 及 SCHEDULER_QUEUE_CLASS 等参数,实现高效分布式爬虫与数据持久化存储。
本文介绍如何在Scrapy框架中配置动态代理IP以应对网站反爬机制。通过设置DOWNLOADER_MIDDLEWARES启用ProxyMiddleware和CheckProxyMiddleware,并在settings中定义PROXIES列表,实现请求IP的随机切换与基础验证,帮助爬虫稳定获取数据。
本文详解Scrapy中向Spider传递参数的两种主流方法。第一种通过命令行crawl命令的-a选项传入参数,并在Spider构造函数中接收;第二种通过scrapyd调度schedule.json接口使用-d选项添加参数。此外,还介绍了利用Request的meta属性在页面解析间传递数据的技巧,帮助开发者灵活控制爬虫行为。
本文详细介绍在Scrapy框架中启用和管理Cookie的三种核心方法。首先解析settings.py中COOKIES_ENABLED参数的逻辑陷阱;其次演示如何在中间件process_request中动态注入Cookie;最后讲解在Spider的start_requests中通过Request对象传递自定义Cookie。适用于Python3.6及以上版本,帮助开发者解决爬虫登录状态保持及页面获取失败的问题。
本文深入解析Python Scrapy框架的核心架构与工作流程。Scrapy基于Twisted异步网络库,由引擎、调度器、下载器、爬虫及管道等组件协同工作,高效实现网页数据抓取。文章详细阐述了各组件职责,并提供了从创建项目到生成爬虫的完整命令示例,帮助开发者快速掌握这一强大爬虫工具的基础应用。
本文详细讲解Python爬虫中请求头(Headers)的设置方法,涵盖Requests、Selenium(Chrome/PhantomJS)、Scrapy框架及Aiohttp异步库。通过模拟浏览器头部信息,有效绕过网站反爬限制。内容包含具体代码示例及获取Headers的实操步骤,帮助开发者解决访问被拒问题。
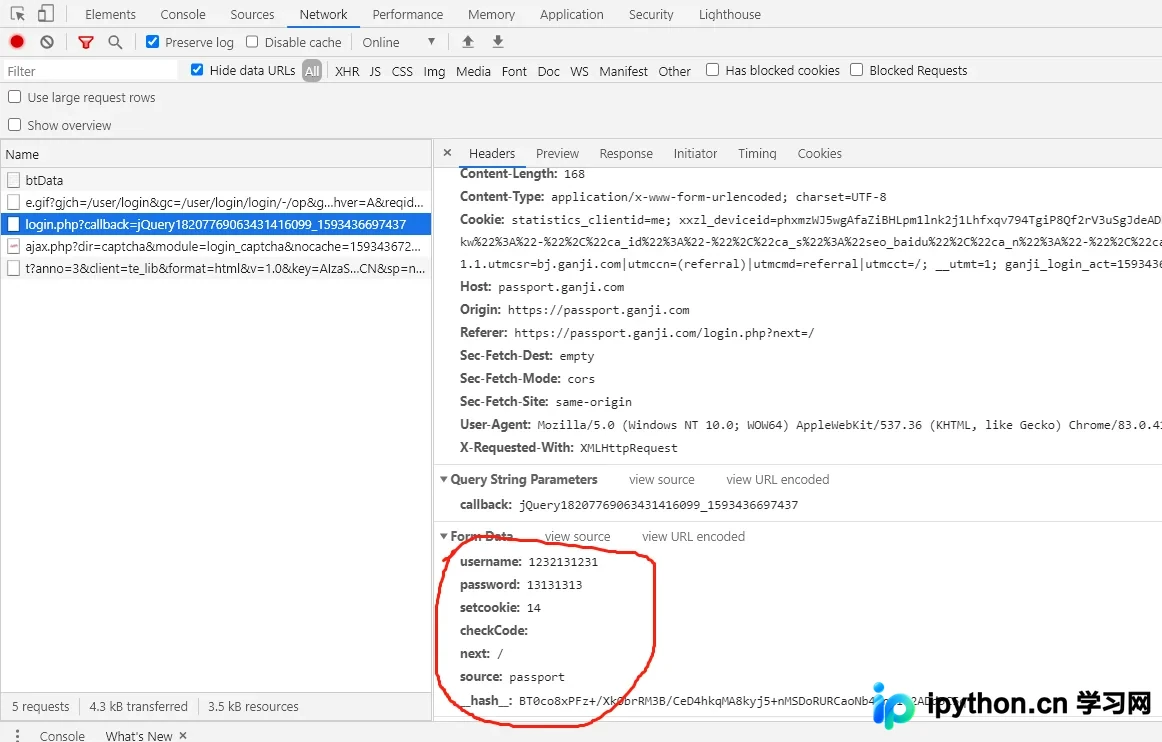
本文详细讲解如何使用Scrapy框架模拟登录赶集网。通过分析登录接口的POST请求参数,包括setcookie、__hash__及验证码机制,提供完整的Python代码实现。内容涵盖项目创建、Spider编写、表单数据构造及登录后的处理流程,帮助开发者掌握动态参数提取与自动登录技巧。
本文详解Python爬虫可获取的数据类型,涵盖电商、房产、招聘及社交平台案例。针对初学者常遇的学习误区,提供从基础包使用到分布式爬虫的六步平滑学习路径,帮助零基础上手高效采集数据。
本文详细解析使用Python Scrapy框架进行多页数据爬取的实现过程。通过定义通用URL模板,在parse方法中利用递归逻辑手动发送后续页码的请求,从而实现对多页内容的自动抓取与解析。
本文解析Python爬虫中Request Payload与Form Data在Content-Type上的核心差异,指出Scrapy的FormRequest仅支持Form Data。针对Request Payload场景,提供通过Jsoup发送JSON字符串或Map参数的具体代码实现,并强调动态获取变化参数的重要性,帮助开发者解决POST请求参数传递问题。
本文介绍如何在Django项目中通过Scrapyd服务实现爬虫的可视化管理。涵盖创建Django与Scrapy项目、部署爬虫、通过API启动/停止任务及查看状态等完整流程,并提供关键代码示例与接口说明。