

Scrapy 数据存入 MySQL:同步与异步实现详解

本文详细介绍 Scrapy 框架将数据持久化至 MySQL 数据库的两种核心方式:同步操作与基于 Twisted 的异步存储。文章涵盖 pipelines.py 配置、数据库连接池建立及错误处理机制,并针对中文乱码、特殊字符报错及重复数据累积问题提供具体解决方案,包括使用 pymysql.escape_string 和 scrapy-deltafetch 等插件实现增量爬取。
Scrapy 同步存储 MySQL 实现
方法一:同步操作
首先,在 pipelines.py 文件中编写处理数据的 Python 代码。
import pymysql

class LvyouPipeline(object):
  def __init__(self):
    # connection database
    self.connect = pymysql.connect(host='XXX', user='root', passwd='XXX', db='scrapy_test') # 后面三个依次是数据库连接名、数据库密码、数据库名称
    # get cursor
    self.cursor = self.connect.cursor()
    print("连接数据库成功")

  def process_item(self, item, spider):
    # sql语句
    insert_sql = """
    insert into lvyou(name1, address, grade, score, price) VALUES (%s,%s,%s,%s,%s)
    """
    # 执行插入数据到数据库操作
    self.cursor.execute(insert_sql, (item['Name'], item['Address'], item['Grade'], item['Score'],
                     item['Price']))
    # 提交,不进行提交无法保存到数据库
    self.connect.commit()

  def close_spider(self, spider):
    # 关闭游标和连接
    self.cursor.close()
    self.connect.close()
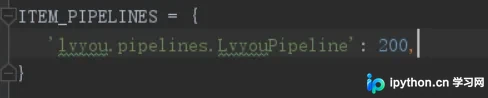
其次,在项目的配置文件中启用该 Pipeline。
Scrapy 异步存储 MySQL 实现
方式二:异步存储
在 pipelines.py 文件中实现异步逻辑。
利用 Twisted 模块实现数据库的异步插入,Twisted 提供了 twisted.enterprise.adbapi 接口。
第一步,导入 adbapi 模块。
第二步,生成数据库连接池。
第三步,执行数据插入数据库的操作。
第四步,打印错误信息并进行排错处理。
import pymysql
from twisted.enterprise import adbapi
# 异步更新操作
class LvyouPipeline(object):
  def __init__(self, dbpool):
    self.dbpool = dbpool

  @classmethod
  def from_settings(cls, settings): # 函数名固定,会被scrapy调用,直接可用settings的值
    """
    数据库建立连接
    :param settings: 配置参数
    :return: 实例化参数
    """
    adbparams = dict(
      host=settings['MYSQL_HOST'],
      db=settings['MYSQL_DBNAME'],
      user=settings['MYSQL_USER'],
      password=settings['MYSQL_PASSWORD'],
      cursorclass=pymysql.cursors.DictCursor  # 指定cursor类型
    )

    # 连接数据池ConnectionPool,使用pymysql或者Mysqldb连接
    dbpool = adbapi.ConnectionPool('pymysql', **adbparams)
    # 返回实例化参数
    return cls(dbpool)

  def process_item(self, item, spider):
    """
    使用twisted将MySQL插入变成异步执行。通过连接池执行具体的sql操作,返回一个对象
    """
    query = self.dbpool.runInteraction(self.do_insert, item) # 指定操作方法和操作数据
    # 添加异常处理
    query.addCallback(self.handle_error) # 处理异常

  def do_insert(self, cursor, item):
    # 对数据库进行插入操作,并不需要commit,twisted会自动commit
    insert_sql = """
    insert into lvyou(name1, address, grade, score, price) VALUES (%s,%s,%s,%s,%s)
    """
    self.cursor.execute(insert_sql, (item['Name'], item['Address'], item['Grade'], item['Score'],
                         item['Price']))

  def handle_error(self, failure):
    if failure:
      # 打印错误信息
      print(failure)
常见问题与增量爬取方案
注意事项:
1. Python 3.x 版本不再支持 MySQLdb,其替代方案为:import pymysql。
2. 可能遇到报错 pymysql.err.ProgrammingError: (1064, ……
原因分析:当 item['quotes'] 字段内容包含引号时,容易触发上述 SQL 语法错误。
解决办法:调用 pymysql.escape_string() 方法对数据进行转义处理。
例如:
sql = """INSERT INTO video_info(video_id, title) VALUES("%s","%s")""" % (video_info["id"],pymysql.escape_string(video_info["title"]))3. 当数据包含中文时,数据库连接需添加 charset='utf8' 参数,否则中文显示为乱码。
4. 每次执行爬虫都会将数据追加到数据库中,多次测试会导致相同数据不断累积。如何实现增量爬取?
- scrapy-deltafetch
- scrapy-crawl-once(与1不同的是存储的数据库不同)
- scrapy-redis
- scrapy-redis-bloomfilter(3的增强版,存储更多的url,查询更快)
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









