

Scrapy模拟登录实战:携带Cookie与FormRequest两种方案详解

本文详解Scrapy实现模拟登录的两种核心方式:一是直接携带Cookie发起请求,适用于Cookie有效期较长的场景;二是通过发送Post请求获取Cookie,分别介绍scrapy.FormRequest手动构造表单与scrapy.FormRequest.from_response()自动填充表单的方法。结合GitHub登录示例代码,解析如何验证登录状态及处理动态表单字段,帮助开发者高效解决需要登录才能访问的页面爬取问题。
为什么要进行模拟登录
部分网站要求用户必须登录才能访问,且同一网站在登录前后的页面内容差异可能极大。例如,未登录状态下访问GitHub首页时,显示的是注册引导页面:
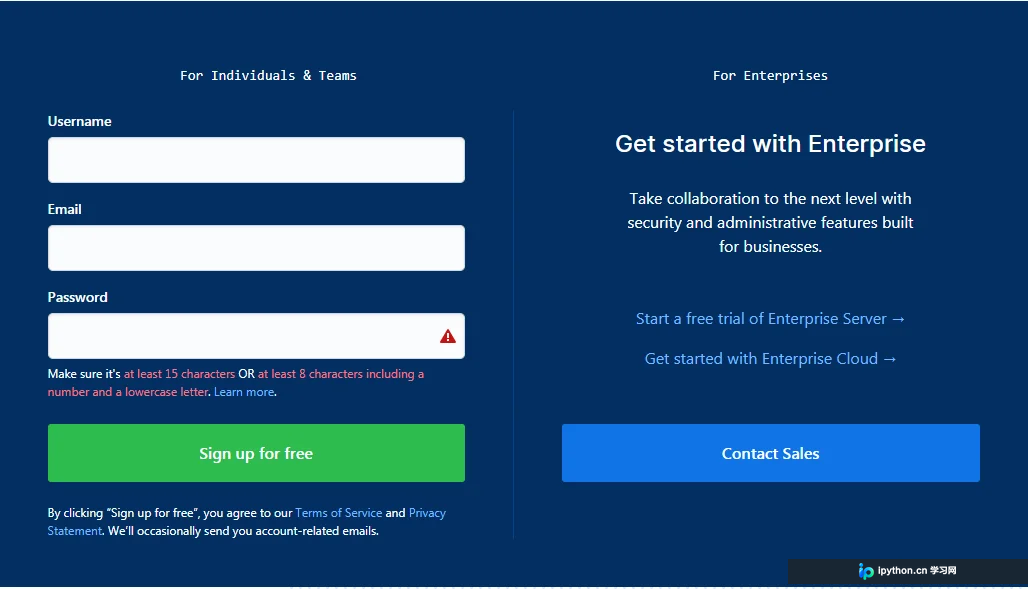
而成功登录GitHub后,首页内容则变为包含个人动态的信息流页面:
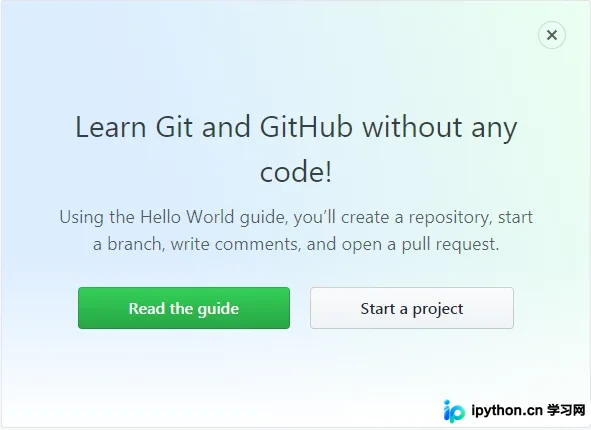
当我们需要爬取仅限登录用户访问的数据时,模拟登录成为必要步骤。通常,我们可以利用Cookies来模拟用户身份。在Scrapy框架中,实现网站模拟登录主要有以下两种途径:
(1)在请求中直接携带Cookies
(2)通过发送Post请求获取Cookies
在请求中直接携带Cookies
针对那些Cookie有效期较长且规范程度较低的网站,如果能在Cookie过期前完成数据爬取,可以直接在发起请求时携带Cookies信息,以此模拟用户登录状态。
以下是模拟登录GitHub的示例代码:
# -*- coding: utf-8 -*-
import scrapy
import re

class TmallLoginSpider(scrapy.Spider):
  name = 'github_login3'
  allowed_domains = ['github.com']
  start_urls = ['https://github.com/']

  def start_requests(self): # 请求时携带Cookies
    cookies = '_ga=GA1.2.363045452.1554860671; tz=Asia%2FShanghai; _octo=GH1.1.1405577398.1554860677; _device_id=ee3ff12512668a1f9dc6fb33e388ea20; ignored_unsupported_browser_notice=false; has_recent_activity=1; user_session=5oxrsfsZCor1iJFCgRXXyeAXd8hcmzEUGh70-xHWLjQkT62Q; __Host-user_session_same_site=5oxrsfsZCor1iJFCgRXXyeAXd8hcmzEUGh70-xHWLjQkT62Q; logged_in=yes; dotcom_user=pengjunlee; _gat=1'
    cookies = {i.split('=')[0]: i.split('=')[1] for i in cookies.split('; ')}
    yield scrapy.Request(self.start_urls[0], cookies=cookies)

  def parse(self, response): # 验证是否请求成功
    print(re.findall('Learn Git and GitHub without any code!',response.body.decode()))
执行爬虫后,后台输出的部分日志截图如下:

通过发送Post请求模拟登录
Scrapy提供了两种通过发送Post请求来获取Cookies的方法。
scrapy.FormRequest()
使用scrapy.FormRequest()发送Post请求实现模拟登录,需要开发者手动查找登录接口的URL地址,并构造登录所需的请求数据。
使用scrapy.FormRequest()模拟登录GitHub的示例代码:
# -*- coding: utf-8 -*-
import scrapy
import re

class GithubLoginSpider(scrapy.Spider):
  name = 'github_login'
  allowed_domains = ['github.com']
  start_urls = ['https://github.com/login']

  def parse(self, response): # 发送Post请求获取Cookies
    authenticity_token = response.xpath('//input[@name="authenticity_token"]/@value').extract_first()
    utf8 = response.xpath('//input[@name="utf8"]/@value').extract_first()
    commit = response.xpath('//input[@name="commit"]/@value').extract_first()
    form_data = {
      'login': 'pengjunlee@163.com',
      'password': '123456',
      'webauthn-support': 'supported',
      'authenticity_token': authenticity_token,
      'utf8': utf8,
      'commit': commit}
    yield scrapy.FormRequest("https://github.com/session", formdata=form_data, callback=self.after_login)

  def after_login(self, response): # 验证是否请求成功
    print(re.findall('Learn Git and GitHub without any code!', response.body.decode()))
从后台日志可以看出,Scrapy在请求https://github.com/session后,会自动将页面重定向至GitHub首页。

scrapy.FormRequest.from_response()
scrapy.FormRequest.from_response()的使用比scrapy.FormRequest()更为简便。通常只需提供用户账号和密码,该方法会自动模拟点击行为,填充其他表单字段并提交表单。
使用scrapy.FormRequest.from_response()模拟登录GitHub的示例代码:
# -*- coding: utf-8 -*-
import scrapy
import re

class GithubLogin2Spider(scrapy.Spider):
  name = 'github_login2'
  allowed_domains = ['github.com']
  start_urls = ['https://github.com/login']

  def parse(self, response): # 发送Post请求获取Cookies
    form_data = {
      'login': 'pengjunlee@163.com',
      'password': '123456'
    }
    yield scrapy.FormRequest.from_response(response,formdata=form_data,callback=self.after_login)

  def after_login(self,response): # 验证是否请求成功
    print(re.findall('Learn Git and GitHub without any code!',response.body.decode()))
scrapy.FormRequest.from_response()方法还支持传入其他参数,以更精确地指定目标表单元素:
'''
response (Response object) – 包含表单HTML的响应,将用来对表单的字段进行预填充
formname (string) – 如果设置了该值,name 等于该值的表单将被使用
formid (string) – 如果设置了该值,id 等于该值的表单将被使用
formxpath (string) – 如果设置了该值,匹配该 xpath 的第一个表单将被使用
formcss (string) – 如果设置了该值,匹配该 css选择器的第一个表单将被使用
formnumber (integer) – 索引值等于该值的表单将被使用,默认第一个(索引值为 0 )
formdata (dict) – 传入的表单数据,将覆盖form 元素中已经存在的值
clickdata (dict) – 用于查找可点击控件的属性值
dont_click (boolean) – 如果设置为 True,将不点击任何元素,直接提交表单数据
'''
参考文章
https://doc.scrapy.org/en/latest/topics/request-response.html
至此,关于Scrapy实现模拟登录的示例代码介绍完毕。如需了解更多Scrapy模拟登录相关内容,建议搜索本站历史文章或继续阅读后续教程,感谢大家的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









