Python爬虫URL下载器实现与Requests库应用详解
本文详解Python爬虫中URL下载器的实现原理与用法。介绍如何从内置urllib迁移至功能强大的Requests库,通过HtmlDownloader类封装下载逻辑。重点讲解User-Agent伪装、状态码判断及编码处理等关键步骤,帮助开发者构建高效稳定的数据抓取模块。
2026-10-14
6

本文详解Python爬虫中URL下载器的实现原理与用法。介绍如何从内置urllib迁移至功能强大的Requests库,通过HtmlDownloader类封装下载逻辑。重点讲解User-Agent伪装、状态码判断及编码处理等关键步骤,帮助开发者构建高效稳定的数据抓取模块。
本文介绍Python爬虫在遇到登录验证(如验证码、拖拽)时的两种主流解决方案:Cookie注入与模拟登录。通过获取浏览器Cookie并利用requests库复用会话,可绕过多数验证机制;同时简述基于requests的模拟登录思路。文中包含完整代码示例,展示如何配置代理、设置Cookie及处理登录状态,帮助开发者高效解决登录墙问题。
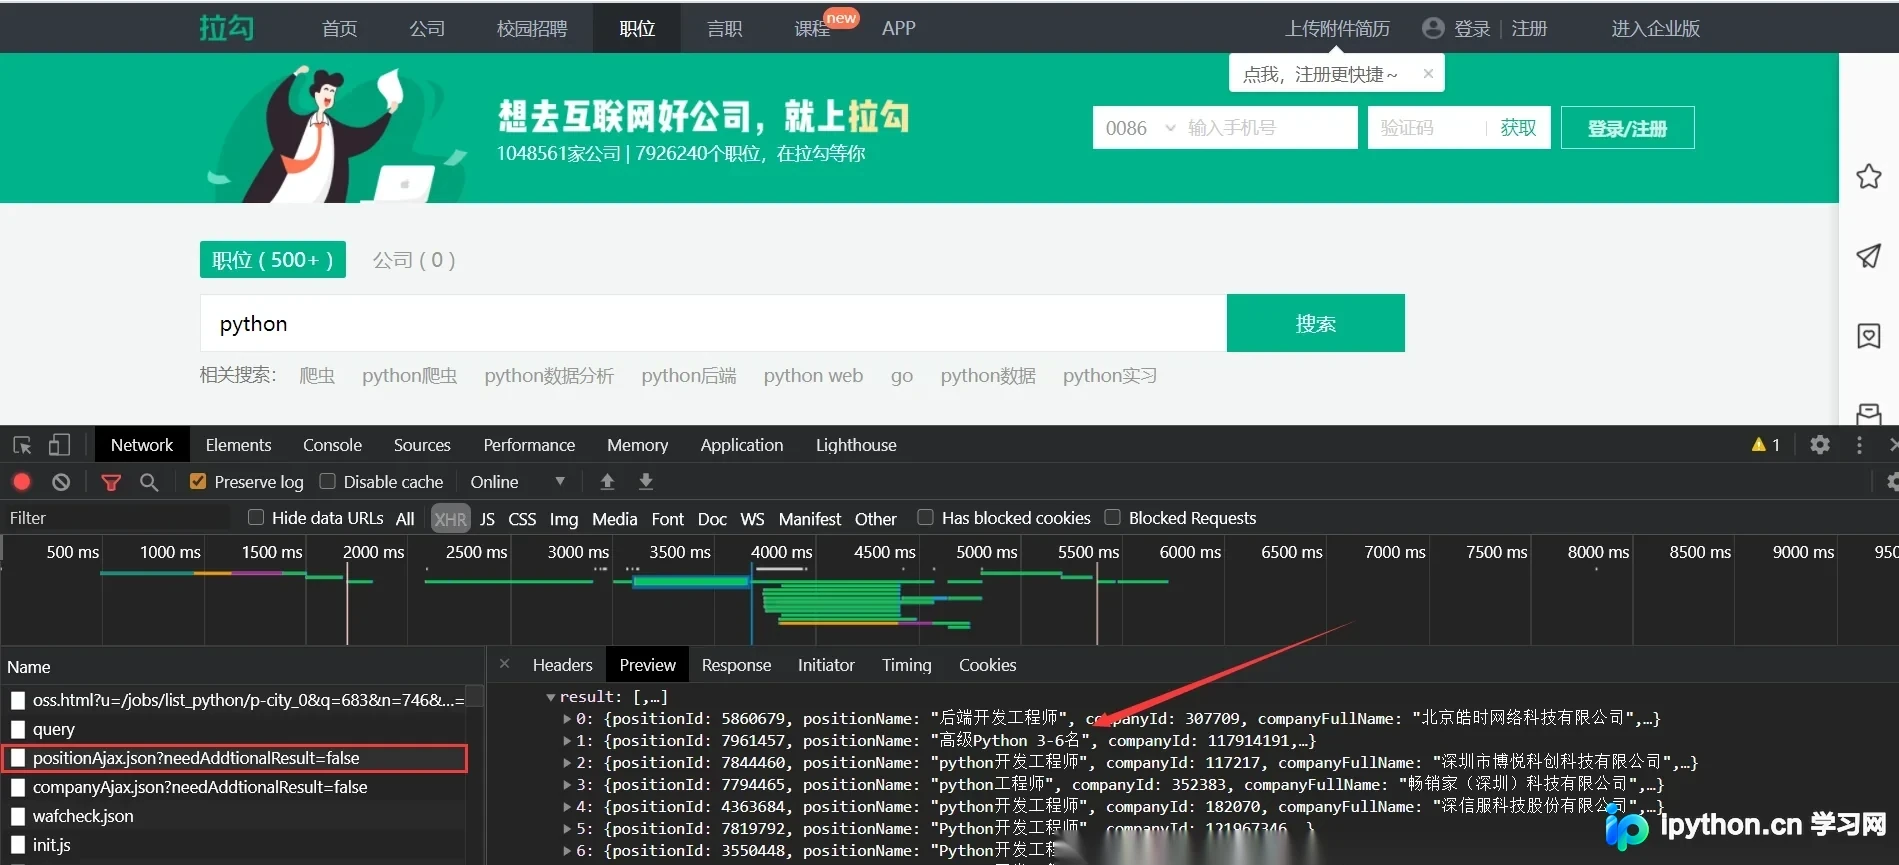
本文详细解析使用Python Requests库爬取拉勾网招聘信息的完整流程。重点解决接口返回操作频繁错误的问题,通过获取并动态刷新Cookies解决反爬限制。代码包含分页请求、字段提取及CSV保存功能,每十次请求自动更新Cookie,确保数据抓取的稳定性与有效性。
本文介绍如何使用Python的Requests库对文件分片上传接口进行自动化测试。通过模拟前端行为,将大文件按指定大小分片,计算整体及分片MD5值,并循环调用后端接口上传各分片。最后通过对比服务器返回的MD5值来验证上传完整性与正确性,适用于Vue前端与PHP后端的系统测试场景。
本文详解Python中requests库模拟登录的三种方式。首先区分Cookie与Session机制,随后介绍直接使用抓包Cookie、通过字典参数传递Cookie以及利用Session对象保持会话状态的方法。文章涵盖代码示例与注意事项,帮助开发者高效实现网页数据抓取与自动化请求。
本文通过10个Python爬虫实例,详解requests库的get、post、put方法及其传参技巧。内容涵盖环境安装、响应对象处理、编码设置、文件保存及图片抓取,并演示如何通过修改User-Agent绕过知乎的反爬机制,适合初学者快速掌握网络数据采集基础。
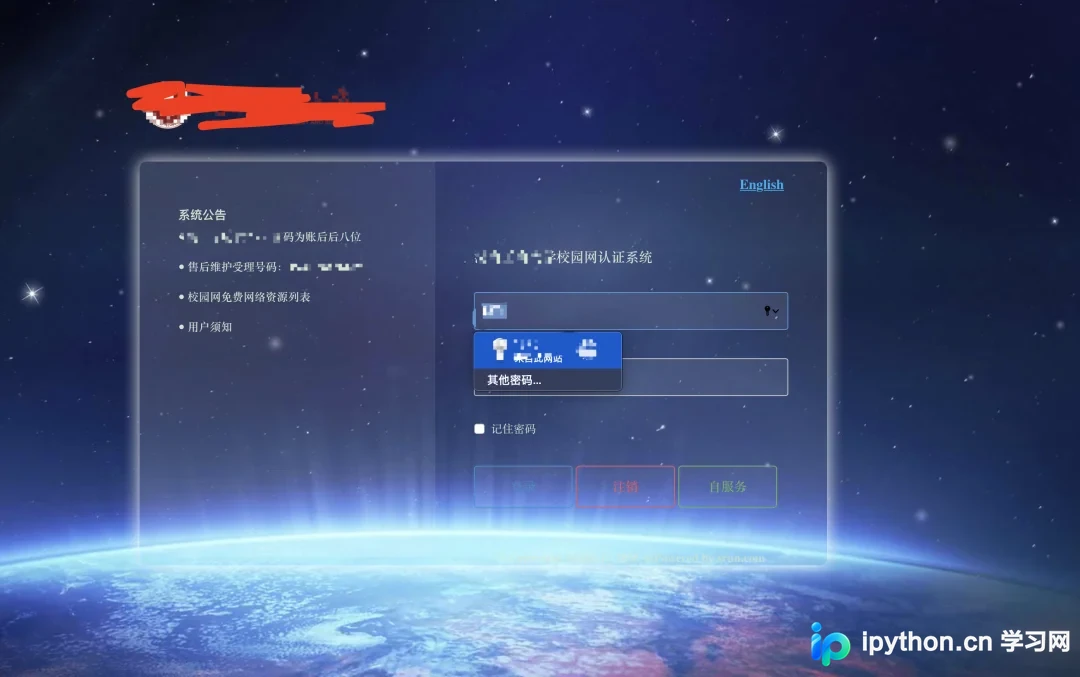
本文介绍如何利用Python脚本实现校园网的一键自动登录。通过抓包分析登录接口,使用requests库模拟POST请求提交账号密码,解决自动认证问题。随后使用PyInstaller将Python脚本打包为Windows或macOS的可执行文件,实现双击即可联网,简化日常连接流程。
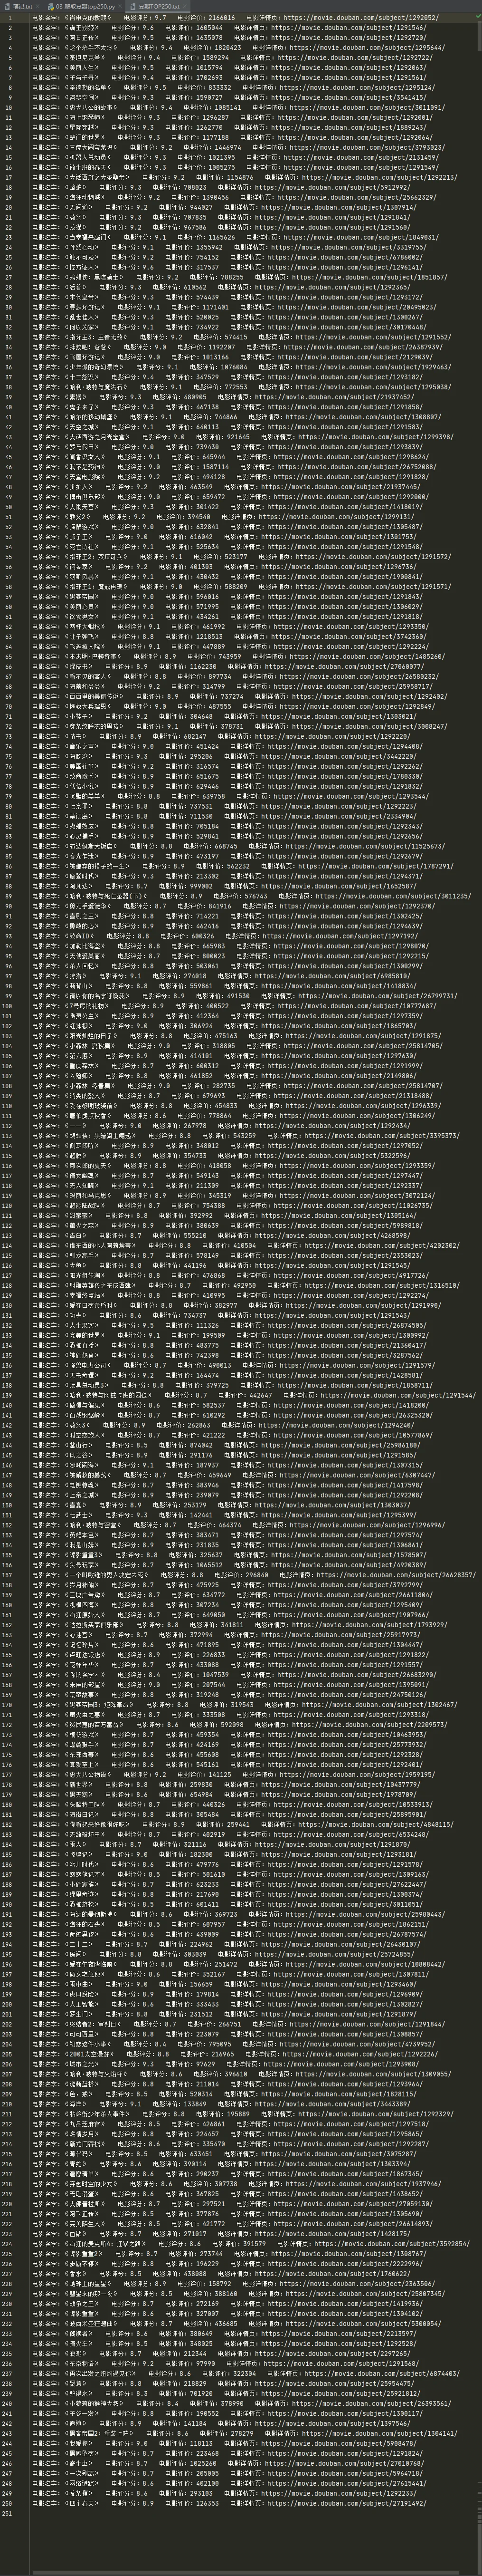
本文详细介绍使用Python爬取豆瓣电影Top250的完整流程。通过requests发送请求并设置User-Agent避免封禁,利用re模块正则表达式精准提取电影名称、评分及评价人数,最后将结果保存至本地文件。代码包含完整的请求、解析与保存逻辑,适合Python初学者学习网络爬虫基础。
本文介绍使用Python实现图书馆座位自动预约的脚本逻辑。通过F12分析登录与预约接口,利用requests.session保持会话状态。核心优化包括定时在系统开放时发送请求以减轻服务器压力,以及处理撞车情况下的自动顺延策略。代码仅供参考,旨在提供同类系统的开发思路。
本文提供使用Python requests库构建代理IP池的完整示例代码。内容涵盖从网站抓取代理IP、验证可用性、保存至本地文件以及通过函数获取可用代理的全过程,旨在解决爬虫过程中IP被封禁的问题,为数据库抓取任务提供稳定的网络环境支持。
本文以51CTO博客为例,详细介绍如何使用Python进行网页数据爬取。通过安装Python 3.7及requests、bs4模块,结合清华镜像加速下载,编写代码抓取博客标题与阅读量,并将结果保存至本地文本文件,为初学者提供完整的实战案例。
本文介绍使用Python获取网页源码的两种方法。首先演示利用requests库直接获取指定页面的HTML文本,并处理编码问题;其次展示结合urllib2与BeautifulSoup进行全站链接扫描的复杂示例,包括遍历页面、解析锚点、检查链接状态码及计算耗时。