

Python爬虫中Requests库处理Cookie的两种方法
本文详解Python爬虫中利用Requests库处理Cookie的两种核心方法。通过对比urllib,展示如何使用get方法直接传递Cookie,以及利用Session对象在多次请求间自动保持Cookie状态。包含具体代码示例及运行结果分析,帮助开发者更高效地实现登录态维持与数据抓取。
2026-10-14
7

本文详解Python爬虫中利用Requests库处理Cookie的两种核心方法。通过对比urllib,展示如何使用get方法直接传递Cookie,以及利用Session对象在多次请求间自动保持Cookie状态。包含具体代码示例及运行结果分析,帮助开发者更高效地实现登录态维持与数据抓取。
本文详细解析Python爬虫中因缺少User-Agent标识导致请求被拒的问题,并提供使用requests库进行UA伪装的完整代码示例。通过模拟Chrome浏览器头部信息,有效绕过门户网站的简单反爬检测,实现正常数据抓取。
本文介绍使用Python进行图片爬取的简单实现方法。通过导入正则表达式模块和requests库,定义spider函数解析网页HTML并提取图片URL。代码包含异常处理、超时设置及文件保存逻辑,展示了从请求到本地存储的完整流程,适合初学者参考。
本文详细介绍Python中Requests库的安装方法及发送GET请求的核心用法。涵盖无参与有参请求、状态码与响应体(text/content)的区别、自动解码机制,以及response对象常用属性如headers、json()和raise_for_status()的实战应用,帮助开发者快速掌握接口测试基础。
本文详细介绍Python中requests库进行接口测试的核心用法。涵盖GET与POST请求的参数传递方式,重点解析params、data与json三者的区别及适用场景。同时讲解如何利用requests.Session()保持会话状态,并演示如何获取状态码、响应头、编码格式及JSON数据等关键响应信息,帮助开发者快速掌握接口自动化测试基础。
本文详细解析Python3爬虫中携带Cookie的两种核心方法:直接写入Header头部和使用requests库的cookies参数。通过哈工大ACM站点的登录实战,演示如何利用urllib和cookiejar实现自动登录及后续页面访问,帮助开发者解决身份验证相关的爬虫需求。
本文详细讲解Python中requests库的多种实用技巧。内容涵盖库的安装、GET与POST请求的参数及头部设置、代理IP的配置方法,以及通过获取Cookie和使用Session对象实现自动登录和状态保持。适合希望提升爬虫效率与稳定性的开发者参考。
本文详细介绍在Python爬虫开发中如何添加请求头,分别通过requests、urllib以及PhantomJS三种方式给出具体代码示例。内容涵盖常见Header字段的配置方法,如User-Agent、Referer等,帮助开发者绕过基础反爬机制。
本文详解如何利用Python的browsercookie模块自动从Chrome、Firefox等主流浏览器中提取已保存的Cookie,解决爬虫登录验证难题。通过安装配置、代码示例及requests库结合使用,实现无需手动输入账号密码即可访问需登录状态的网页内容,提升数据采集效率。
本文详细介绍如何使用Python3、Requests库结合Excel构建一套完整的接口自动化测试框架。内容涵盖项目目录结构设计,包括基础请求封装、Excel数据读取、依赖数据处理、Token实时获取与写入以及主运行程序等核心模块的实现逻辑,旨在帮助开发者快速搭建可维护的接口测试解决方案。
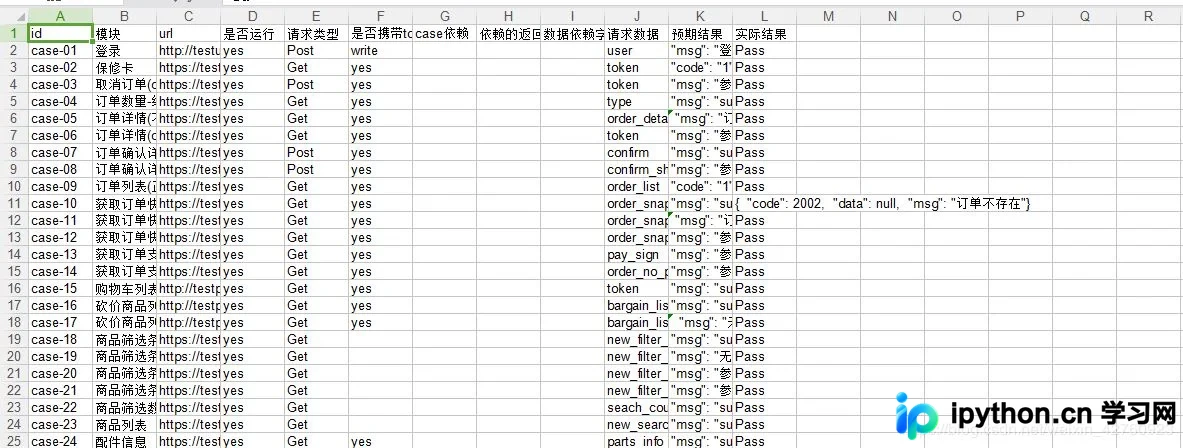
本文介绍在Python多网卡环境中,如何通过修改socket的source_address参数来指定特定网卡发送HTTP请求。文章详细解析了urllib和requests库的底层实现,提供了针对urllib3的适配方案及解决ConnectionError异常的代码示例,帮助开发者在多IP场景下精确控制网络出口。
本文详解Python爬虫中模拟登录人人网的两种核心方法。首先介绍使用requests.Session()类自动维持会话状态,通过POST提交表单数据实现登录并抓取个人主页;其次演示如何手动提取并传递Cookie,分别通过Headers和Cookies参数访问受限页面。代码包含完整登录流程与本地保存逻辑,适用于学习爬虫会话保持机制。