Python3 Requests库处理HTTP重定向获取真实URL的两种方法
本文介绍在Python3中使用Requests库处理HTTP 301或302重定向时,如何获取跳转后的真实URL。通过解析Response Header中的Location字段,或利用Requests默认自动跳转特性访问response.url,可分别实现手动提取与自动获取两种方案。
2026-10-16
8

本文介绍在Python3中使用Requests库处理HTTP 301或302重定向时,如何获取跳转后的真实URL。通过解析Response Header中的Location字段,或利用Requests默认自动跳转特性访问response.url,可分别实现手动提取与自动获取两种方案。

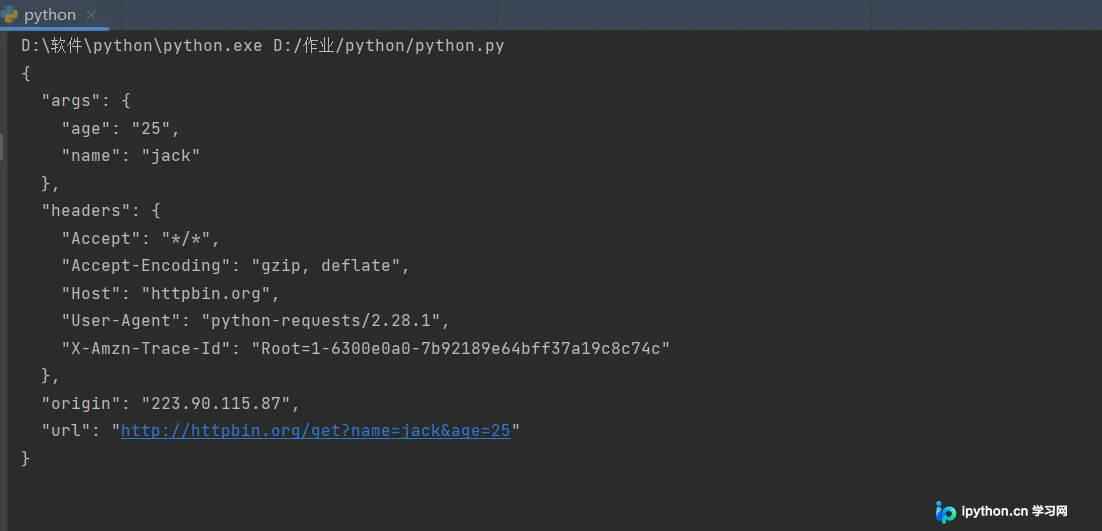
本文详细介绍Python爬虫中requests库的安装方法及GET与POST请求的具体使用。涵盖通过pip或源码安装requests,演示如何构造带参数的GET请求、获取JSON数据、处理二进制文件下载,以及利用data和files参数进行POST请求和文件上传。同时解析响应状态码、异常抛出及JSON转换技巧,帮助开发者高效完成HTTP交互。
本文解析Python爬虫中因服务器使用Brotli压缩导致的中文乱码问题。详细说明了如何识别Accept-Encoding头中的br格式,通过手动导入brotli库或使用httpx自动处理来正确解码数据,并提供了修改请求头以禁用br压缩的替代方案。
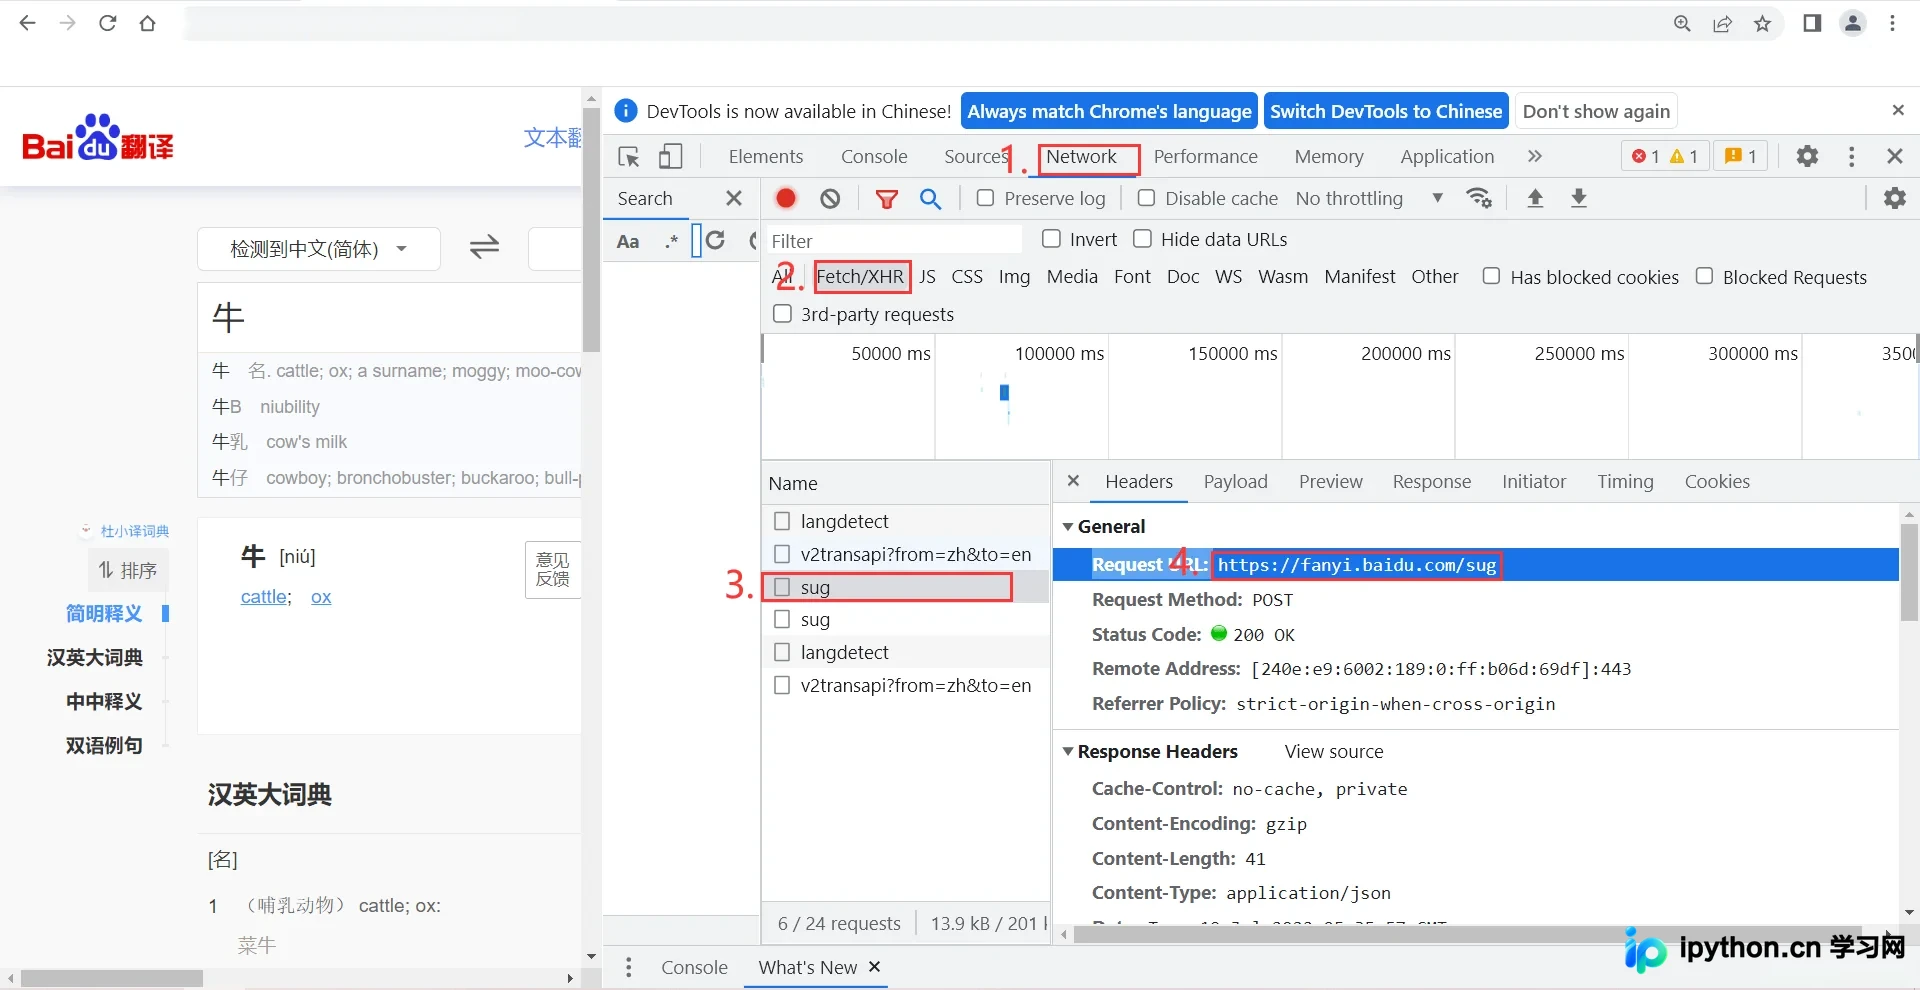
本文详细讲解如何利用Python的requests库对接百度翻译网页接口。通过F12开发者工具分析网络请求,获取SUG接口的URL、Headers及Data参数。文章提供了从导入库、构建请求到解析JSON响应数据的完整代码示例,并演示了如何将功能封装为函数以实现交互式翻译程序,适合Python初学者学习网络请求与数据处理。
本文详细介绍如何使用Python爬取Pixiv图片。内容涵盖通过抓包分析模拟登录流程,动态获取post_key,利用Session保持状态,以及通过BeautifulSoup和正则表达式提取图片链接。针对Pixiv的防盗链机制,文章提供了处理Referer、动态构建真实图片URL及解决403/404错误的完整代码方案。
本文详细介绍如何利用Python的Requests库发送HTTP请求获取网页源码,并结合BeautifulSoup解析HTML结构以提取特定标签数据。通过分步示例,演示从环境配置、单页抓取到多页循环爬取的完整流程,帮助开发者快速掌握基础爬虫技术。
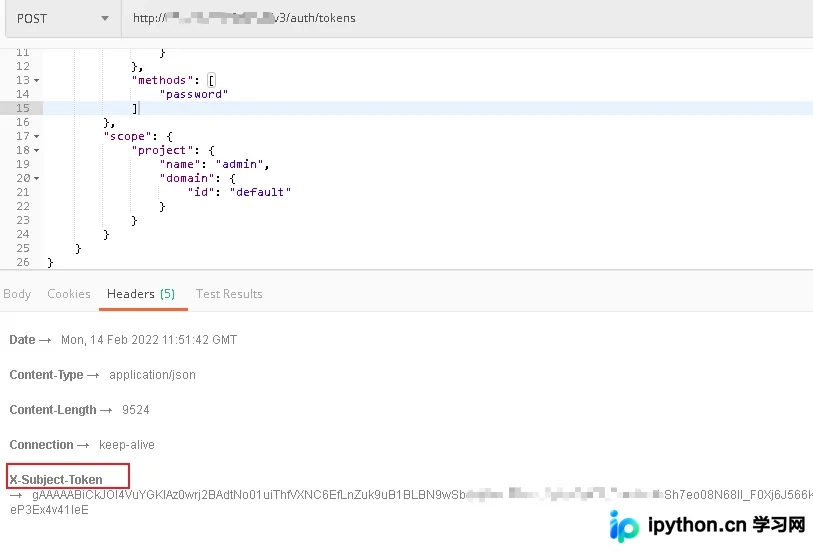
本文介绍如何利用Python的requests库从HTTP请求的响应头中提取特定数据。通过获取Token、Date及Content-Type等字段,展示在接口测试中解析headers的实际应用,帮助开发者快速掌握响应头数据的获取技巧。
本文详细介绍如何使用Python编写一个简单的爬虫程序,批量下载电脑壁纸。通过结合Requests进行HTTP请求、XPath解析HTML结构以及Pinyin库处理中文路径,实现从指定类型和页码中自动抓取高清壁纸。文章涵盖工具准备、核心代码逻辑解析及完整可运行代码,旨在提供技术交流参考,非商业用途。
本文详细介绍Python第三方库requests的基本用法,涵盖安装配置、GET与POST请求、参数传递、JSON解析、文件保存、代理设置、Cookie维持及异常处理等核心功能,帮助开发者快速掌握HTTP客户端操作。
本文详解Python中利用requests库进行外部接口调用的完整流程,涵盖Get与Post请求的多种参数提交方式(Form、JSON、文件上传)。结合Flask框架演示接口接收逻辑,重点解析SSL证书验证、数据序列化及中文编码处理等关键细节,提供可直接运行的代码示例。
本文整理了Python开发中高频使用的代码片段,涵盖日期生成与区间处理、CSV数据保存、基于Requests库的GET/POST请求发送,以及Redis、MongoDB和MySQL的连接与操作示例。此外,还分享了本地文件整合、多线程编程及异步爬取与文件保存的完整实现方案,旨在为开发者提供即拿即用的参考代码。
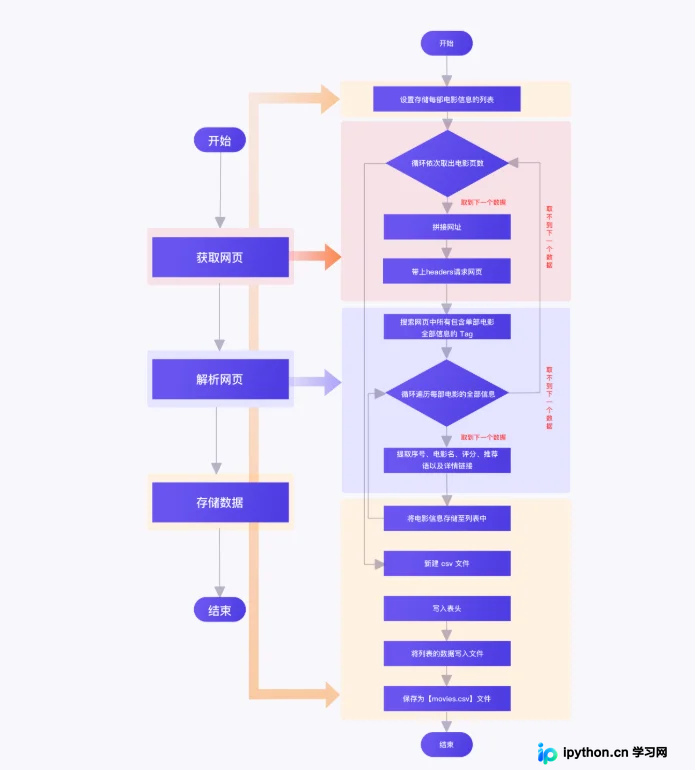
本文详细介绍如何使用Python爬取豆瓣电影Top100的数据。通过Requests库模拟浏览器请求,利用BeautifulSoup解析HTML结构提取电影信息,并采用CSV模块将结果持久化存储。文章涵盖网页规律分析、Headers设置、Robots协议检查及数据清洗存储等关键步骤,适合Python初学者学习网络爬虫基础。