

Python使用Requests库抓取股票资金流向数据
本文详解如何使用Python的Requests库发起HTTP GET请求,通过构造特定的URL参数和Headers获取东方财富网的股票资金流向数据。接着利用正则表达式和JSON模块解析返回的嵌套数据结构,提取关键财务指标。最后结合Pandas库将清洗后的数据整理为DataFrame并导出为Excel文件,实现从数据采集到可视化的完整流程。
2026-10-14
6

本文详解如何使用Python的Requests库发起HTTP GET请求,通过构造特定的URL参数和Headers获取东方财富网的股票资金流向数据。接着利用正则表达式和JSON模块解析返回的嵌套数据结构,提取关键财务指标。最后结合Pandas库将清洗后的数据整理为DataFrame并导出为Excel文件,实现从数据采集到可视化的完整流程。
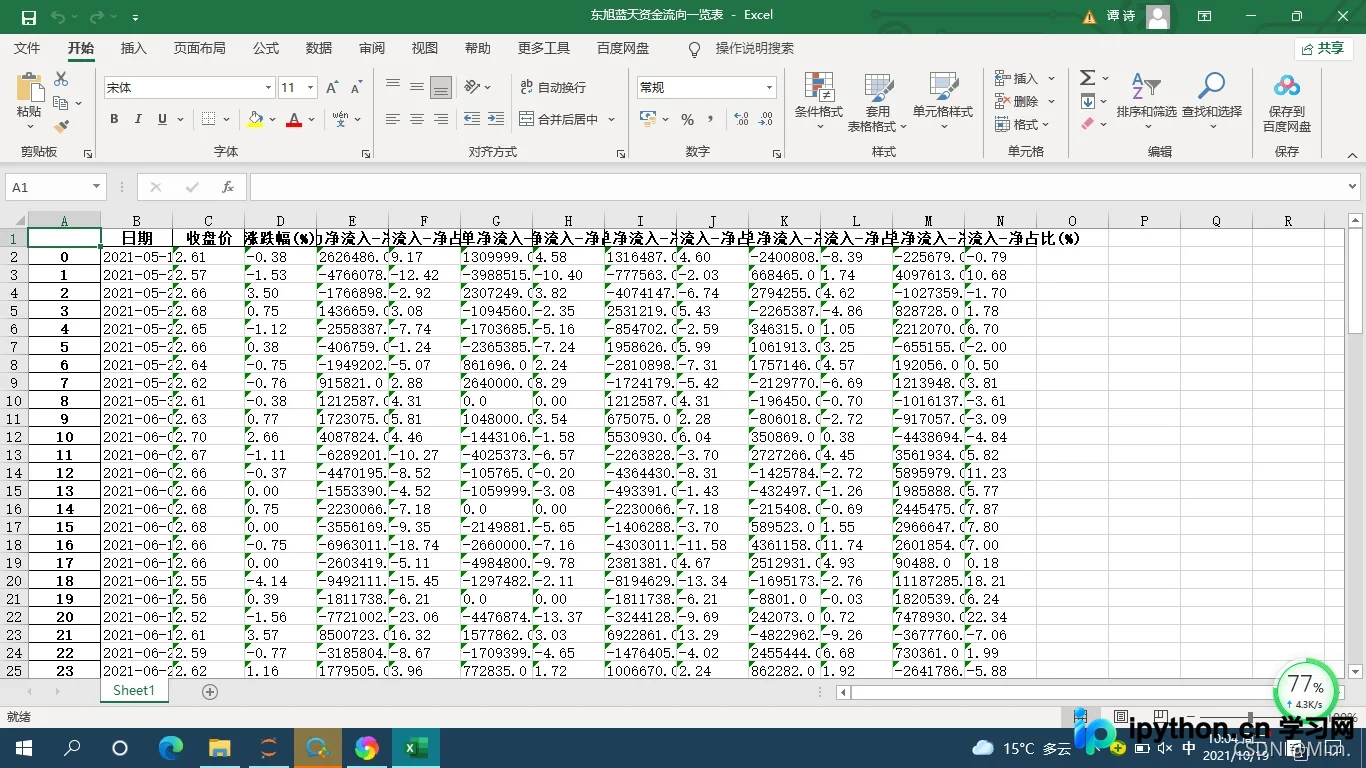
本文详细讲解如何利用Python爬虫技术获取网易云音乐热榜数据。针对网页非静态页面及API接口加密的特点,通过逆向分析请求参数,结合PyExecJS执行JavaScript解密逻辑,成功获取歌曲ID及下载链接,并实现批量下载。教程涵盖环境配置、数据提取、加密破解及完整代码实现,附带源码供参考。
本文详细介绍Python爬虫的核心流程,涵盖使用requests获取网页数据、利用lxml进行HTML解析,以及将数据保存为CSV文件或存入MySQL数据库的具体实现。通过完整代码示例,演示如何处理动态页面、登录状态及异常捕获,帮助开发者快速掌握网络数据采集与持久化技术。
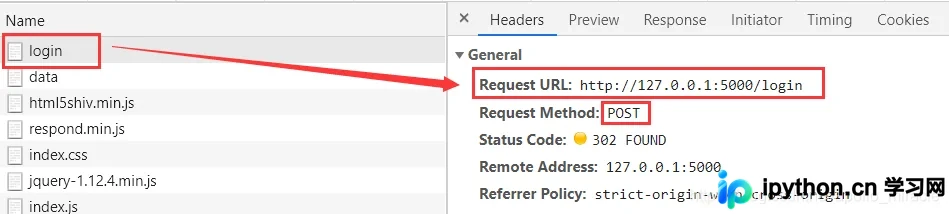
本文详解Python如何使用requests库通过HTTP协议上传文件。重点解析登录保持Session、利用fiddler抓包分析请求参数,以及data与files参数的配合使用。特别强调在上传文件时,headers中严禁手动指定Content-Type,需交由requests库自动生成,否则会导致上传失败。
本文提供Python3环境下进行接口性能测试的完整代码示例。通过结合requests库发送HTTP请求与threading模块实现多线程并发模拟,详细展示了如何计算平均响应时间、统计错误请求数及总耗时。代码包含URL请求类定义、并发线程控制及结果输出逻辑,适用于简单的API压力测试场景。
本文详细介绍如何使用Python脚本自动获取智慧校园每日课表并发送至个人邮箱。通过逆向分析登录接口与课表API,利用requests库模拟登录、处理验证码及解析JSON数据,最终结合yagmail实现自动化邮件发送,帮助学生高效管理课程信息。
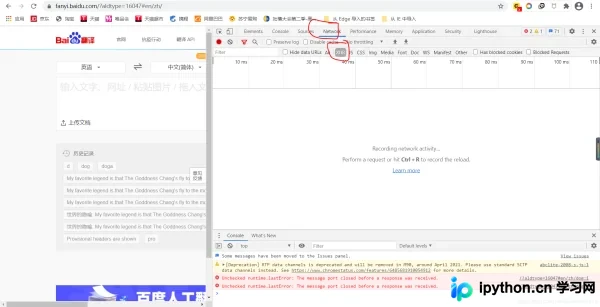
本文详细讲解如何利用Python和requests库爬取百度翻译结果。通过浏览器开发者工具分析AJAX请求,定位fanyi.baidu.com/sug接口,构造包含kw参数的POST请求,并解析返回的JSON数据获取翻译内容。文章提供完整代码示例及注意事项,适合初学者学习动态网页数据抓取。
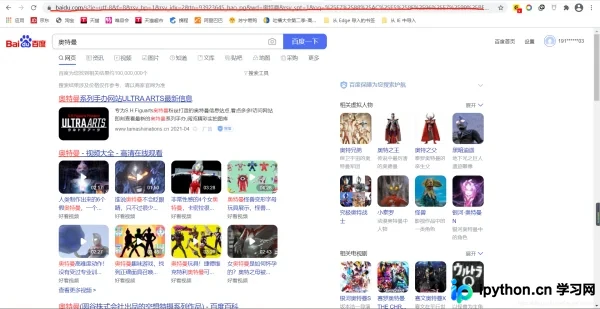
本文介绍Python爬虫中常见的反爬机制及应对策略。通过requests库发起请求时,若未设置User-Agent,服务器可能识别为爬虫并拒绝访问。文章详细演示了如何获取浏览器的User-Agent值,并在代码中通过headers字典进行UA伪装,从而成功抓取特定网页数据。
本文介绍如何使用Python通过B站开放API获取用户粉丝数。提供基础查询与带异常处理、定时轮询的监控脚本示例,涵盖requests库安装、UID配置及数据解析步骤,帮助开发者实现粉丝数量变化的自动检测。
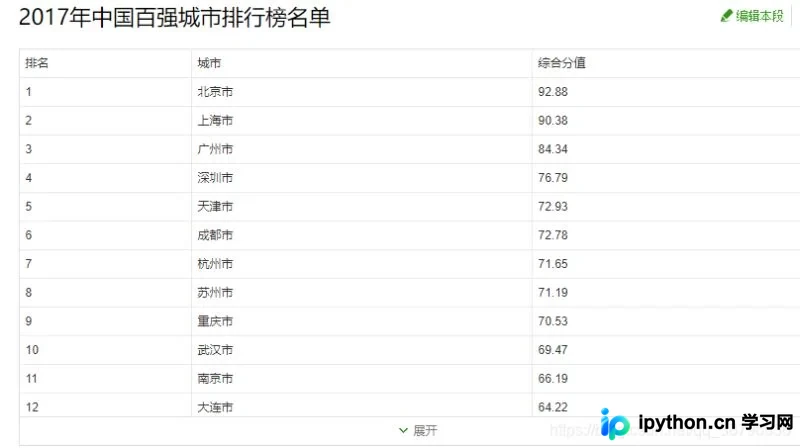
本文详解Python使用requests库爬取网页时返回空内容的常见原因及解决方法。通过修改User-Agent和Cookie模拟浏览器请求,成功绕过360搜索的反爬限制,并结合BeautifulSoup库提取表格数据,完整展示从请求到数据提取的全过程。
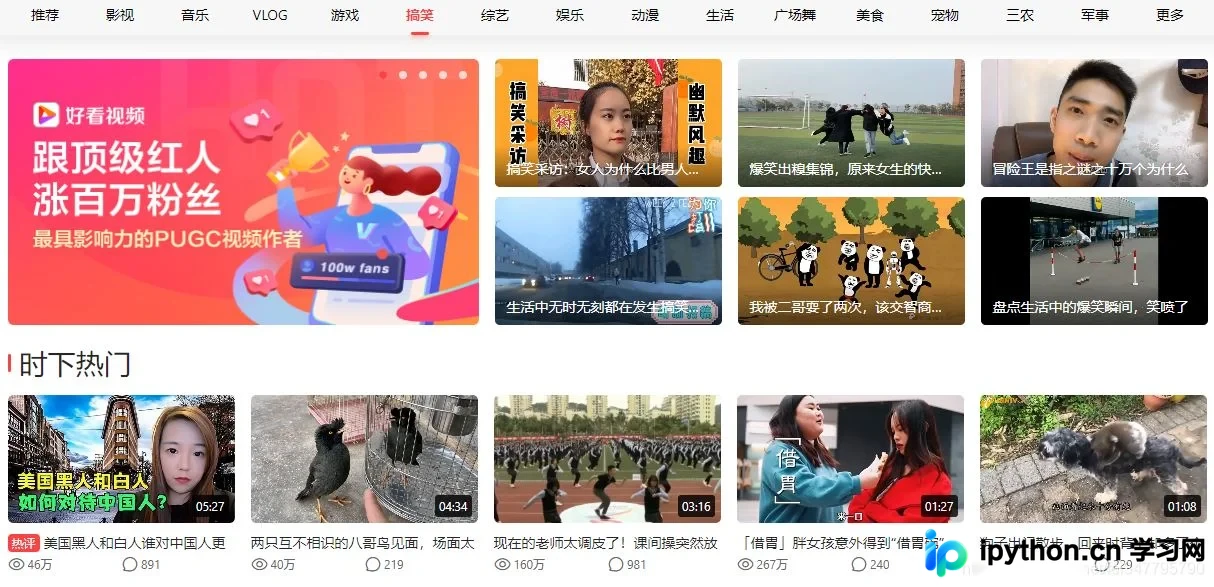
本文介绍使用Python爬取好看视频平台搞笑栏目短视频的方法。针对网站懒加载特性,通过构造API请求获取视频列表,解析标题与播放地址,并利用requests库下载保存视频文件。
本文系统讲解Python爬虫核心知识,涵盖Web交互原理、Requests库的get/post/put方法及Response对象属性。提供10个基础代码实例,演示URL传参、Headers伪装绕过反爬、文件保存及编码处理。最后通过完整实例展示如何结合正则表达式从百度贴吧批量下载图片,适合初学者快速掌握爬虫基本操作。
