

Python爬虫实战:从百度企业信用提取企业基本信息
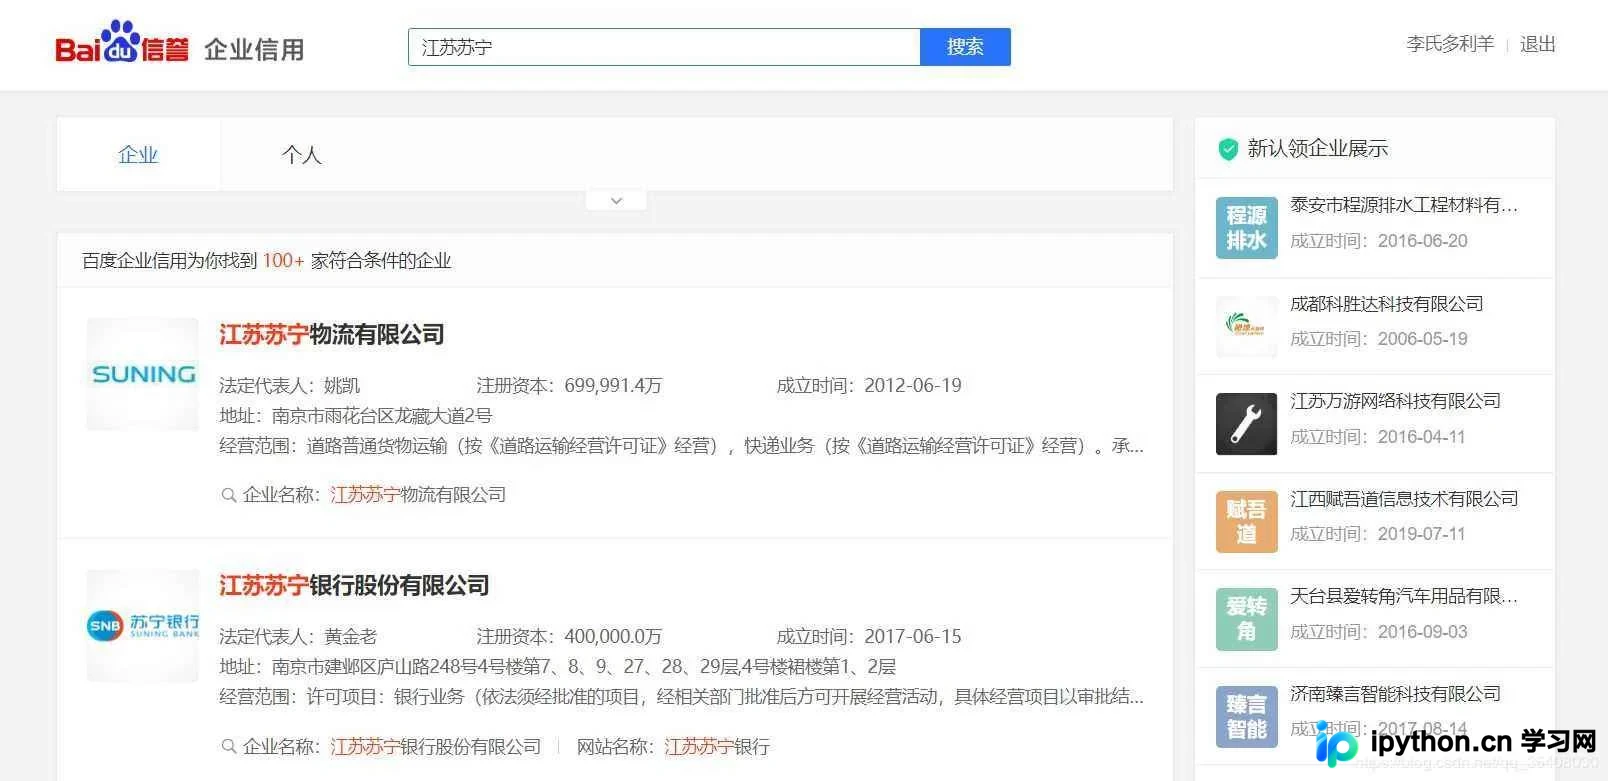
本文介绍如何使用Python爬虫从百度企业信用网站获取企业基本信息。通过分析页面JavaScript动态生成的数据,利用正则表达式提取resultList字段并转换为JSON对象,从而获取企业名称、法人、注册资本等详细信息。文章提供完整源码及调用示例,适用于学习参考,请勿用于恶意爬取。
2026-10-14
5

本文介绍如何使用Python爬虫从百度企业信用网站获取企业基本信息。通过分析页面JavaScript动态生成的数据,利用正则表达式提取resultList字段并转换为JSON对象,从而获取企业名称、法人、注册资本等详细信息。文章提供完整源码及调用示例,适用于学习参考,请勿用于恶意爬取。
本文介绍在Python爬虫中遇到Cloudflare邮箱加密时的解决方案。通过分析前端JS代码,提取基于异或运算的解密逻辑,并使用Python的execjs库加载并调用该JS函数,成功还原加密后的邮箱地址,实现自动化采集。
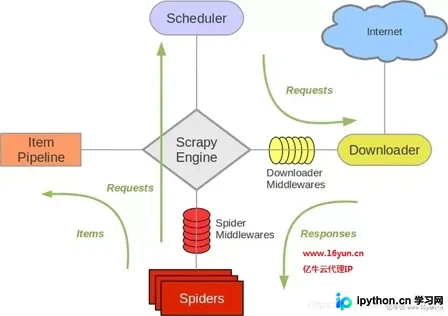
本文介绍如何利用Scrapy框架结合Puppeteer技术解决动态网页抓取难题。Scrapy作为高性能Python爬虫框架,通过集成Pyppeteer中间件,可模拟Chrome浏览器执行JavaScript,从而获取JS渲染后的HTML内容。文章详细解析了Scrapy核心组件及Puppeteer的配置方法,帮助开发者轻松实现复杂动态页面的数据提取。
本文详解Python爬虫可获取的数据类型,涵盖电商、房产、招聘及社交平台案例。针对初学者常遇的学习误区,提供从基础包使用到分布式爬虫的六步平滑学习路径,帮助零基础上手高效采集数据。
本文介绍如何使用Python网络爬虫结合BeautifulSoup库,从绿色呼吸网实时采集天气与空气质量数据。教程涵盖目标网站分析、网页源码定位、关键代码实现及异常处理机制,重点解决部分城市无污染物数据显示时的空值问题。通过PyCharm运行程序,用户可输入城市拼音获取实时AQI、首要污染物及温馨提示,实现便捷的天气信息监控。
本文详解如何使用Python的urllib库爬取网页,并结合BeautifulSoup解析HTML以提取所有URL链接。通过实例代码展示如何遍历a标签、处理相对路径及验证链接有效性,帮助开发者快速掌握网页数据抓取的核心技巧。
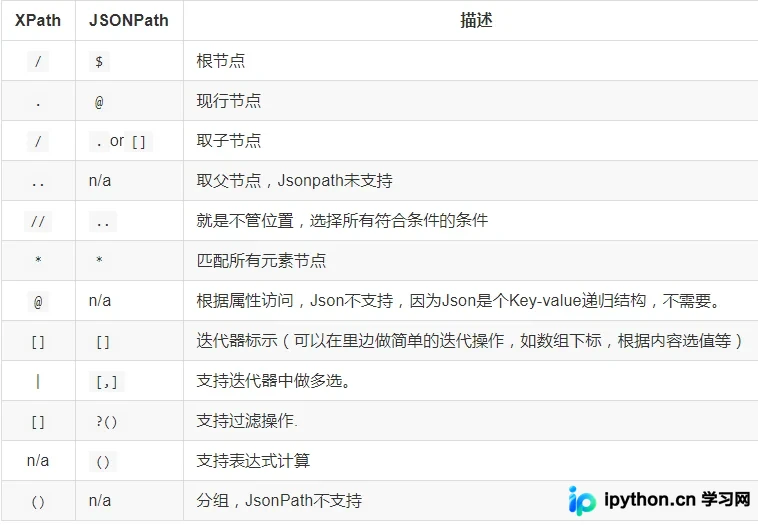
本文详解Python中JSON数据格式及JSONPath信息抽取工具。通过对比JSONPath与XPath语法,展示如何利用jsonpath库从拉勾网和城市数据中提取信息,并结合lxml处理糗事百科HTML内容。文章提供完整代码示例,涵盖JSON字符串转换、列表提取及文件保存操作,帮助开发者掌握Web数据抓取核心技巧。
本文详细解析Python爬虫开发中涉及的HTTP请求方法,重点对比GET与POST在参数传递、数据长度及安全性上的核心差异。通过典型请求示例,帮助开发者理解HEAD、PUT、DELETE等方法的适用场景,为构建高效稳定的网络爬虫提供基础理论支持。
本文系统梳理Python爬虫的核心知识点,涵盖从Python基础语法、urllib/urllib2网络请求库,到正则表达式数据提取,再到Scrapy高级框架的完整学习路径。同时解析爬虫背后的HTTP请求、DNS解析及服务器响应机制,帮助初学者建立完整的爬虫知识体系。
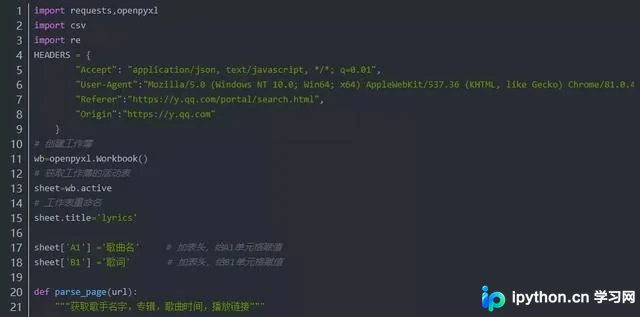
本文详细介绍如何利用Python爬虫技术批量获取QQ音乐歌词。通过浏览器开发者工具分析网络请求,定位搜索接口与歌词接口的URL及参数,编写代码提取歌曲信息与歌词文本,最终使用openpyxl库将结果保存为Excel文件,实现本地化存储与整理。
本文详解Python爬虫应对常见反爬策略的三种核心方案:通过维护代理IP池解决IP限制与验证码问题;利用time.sleep控制访问频率以规避限流;以及通过设置User-Agent和Referer头伪装浏览器身份。内容涵盖Requests与Urllib库的具体代码实现,帮助开发者提升爬虫稳定性。
本文解析Python爬虫中Request Payload与Form Data在Content-Type上的核心差异,指出Scrapy的FormRequest仅支持Form Data。针对Request Payload场景,提供通过Jsoup发送JSON字符串或Map参数的具体代码实现,并强调动态获取变化参数的重要性,帮助开发者解决POST请求参数传递问题。