

Scrapy结合Puppeteer实现JS动态渲染页面爬取

本文介绍如何利用Scrapy框架结合Puppeteer技术解决动态网页抓取难题。Scrapy作为高性能Python爬虫框架,通过集成Pyppeteer中间件,可模拟Chrome浏览器执行JavaScript,从而获取JS渲染后的HTML内容。文章详细解析了Scrapy核心组件及Puppeteer的配置方法,帮助开发者轻松实现复杂动态页面的数据提取。
Scrapy框架核心组件解析
1、Scrapy框架
Scrapy是一个基于纯Python开发的爬虫应用框架,主要用于抓取网站数据并提取结构化信息,应用场景十分广泛。借助该框架的强大能力,用户仅需定制开发少量模块即可快速构建爬虫程序,用于抓取网页内容及各类图片,操作十分便捷。Scrapy底层集成了Twisted异步网络处理框架,能够显著提升下载速度,开发者无需自行实现异步逻辑。此外,框架提供了丰富的中间件接口,支持灵活满足各种复杂的抓取需求。
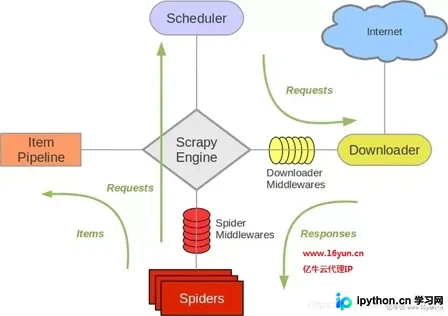
- Scrapy Engine(引擎):负责协调Spider、ItemPipeline、Downloader和Scheduler之间的通信,处理信号传递和数据流转。
- Scheduler(调度器):接收引擎发送的Request请求,对其进行整理、排序并加入队列,当引擎需要时,将请求返还给引擎。
- Downloader(下载器):负责接收引擎发送的所有Request请求,下载完成后将获取的Responses交还给引擎,再由引擎转交给Spider处理。
- Spider(爬虫):负责处理所有Responses,从中分析并提取数据,获取Item字段所需的信息,并将需要跟进的URL提交给引擎,使其再次进入Scheduler(调度器)。
- Item Pipeline(管道):负责处理Spider获取到的Item,进行后期处理,包括详细分析、过滤和存储等操作。
- Downloader Middlewares(下载中间件):这是一个可自定义扩展下载功能的组件。
- Spider Middlewares(Spider中间件):可理解为用于自定义扩展和操作引擎与Spider之间通信的功能组件,例如处理进入Spider的Responses或从Spider发出的Requests。
Puppeteer在Scrapy中的集成应用
2、Puppeteer渲染
Puppeteer是Chrome开发团队于2017年发布的Node.js包,用于模拟Chrome浏览器的运行环境。为了爬取由JavaScript渲染生成的HTML页面,必须借助浏览器解析JS代码以生成最终的HTML结构。在Scrapy中,可以通过集成pyppeteer来实现这一功能。完整代码示例见:scrapy-pyppeteer.zip。我们需要在项目目录下新建middlewares.py文件(路径为:./项目名/middlewares.py)。
import websockets
from scrapy.http import HtmlResponse
from logging import getLogger
import asyncio
import pyppeteer
import logging
from concurrent.futures._base import TimeoutError
import base64
import sys
import random

pyppeteer_level = logging.WARNING
logging.getLogger('websockets.protocol').setLevel(pyppeteer_level)
logging.getLogger('pyppeteer').setLevel(pyppeteer_level)

PY3 = sys.version_info[0] >= 3


def base64ify(bytes_or_str):
  if PY3 and isinstance(bytes_or_str, str):
    input_bytes = bytes_or_str.encode('utf8')
  else:
    input_bytes = bytes_or_str

  output_bytes = base64.urlsafe_b64encode(input_bytes)
  if PY3:
    return output_bytes.decode('ascii')
  else:
    return output_bytes


class ProxyMiddleware(object):
  USER_AGENT = open('useragents.txt').readlines()

  def process_request(self, request, spider):
    # 代理服务器
    proxyHost = "t.16yun.cn"
    proxyPort = "31111"
    # 代理隧道验证信息
    proxyUser = "username"
    proxyPass = "password"

    request.meta['proxy'] = "http://{0}:{1}".format(proxyHost, proxyPort)

    # 添加验证头
    encoded_user_pass = base64ify(proxyUser + ":" + proxyPass)
    request.headers['Proxy-Authorization'] = 'Basic ' + encoded_user_pass

    # 设置IP切换头(根据需求)
    tunnel = random.randint(1, 10000)
    request.headers['Proxy-Tunnel'] = str(tunnel)
    request.headers['User-Agent'] = random.choice(self.USER_AGENT)


class PyppeteerMiddleware(object):
  def __init__(self, **args):
    """
    init logger, loop, browser
    :param args:
    """
    self.logger = getLogger(__name__)
    self.loop = asyncio.get_event_loop()
    self.browser = self.loop.run_until_complete(
      pyppeteer.launch(headless=True))
    self.args = args

  def __del__(self):
    """
    close loop
    :return:
    """
    self.loop.close()

  def render(self, url, retries=1, script=None, wait=0.3, scrolldown=False, sleep=0,
        timeout=8.0, keep_page=False):
    """
    render page with pyppeteer
    :param url: page url
    :param retries: max retry times
    :param script: js script to evaluate
    :param wait: number of seconds to wait before loading the page, preventing timeouts
    :param scrolldown: how many times to page down
    :param sleep: how many long to sleep after initial render
    :param timeout: the longest wait time, otherwise raise timeout error
    :param keep_page: keep page not to be closed, browser object needed
    :param browser: pyppetter browser object
    :param with_result: return with js evaluation result
    :return: content, [result]
    """

    # define async render
    async def async_render(url, script, scrolldown, sleep, wait, timeout, keep_page):
      try:
        # basic render
        page = await self.browser.newPage()
        await asyncio.sleep(wait)
        response = await page.goto(url, options={'timeout': int(timeout * 1000)})
        if response.status != 200:
          return None, None, response.status
        result = None
        # evaluate with script
        if script:
          result = await page.evaluate(script)

        # scroll down for {scrolldown} times
        if scrolldown:
          for _ in range(scrolldown):
            await page._keyboard.down('PageDown')
            await asyncio.sleep(sleep)
        else:
          await asyncio.sleep(sleep)
        if scrolldown:
          await page._keyboard.up('PageDown')

        # get html of page
        content = await page.content()

        return content, result, response.status
      except TimeoutError:
        return None, None, 500
      finally:
        # if keep page, do not close it
        if not keep_page:
          await page.close()

    content, result, status = [None] * 3

    # retry for {retries} times
    for i in range(retries):
      if not content:
        content, result, status = self.loop.run_until_complete(
          async_render(url=url, script=script, sleep=sleep, wait=wait,
                 scrolldown=scrolldown, timeout=timeout, keep_page=keep_page))
      else:
        break

    # if need to return js evaluation result
    return content, result, status

  def process_request(self, request, spider):
    """
    :param request: request object
    :param spider: spider object
    :return: HtmlResponse
    """
    if request.meta.get('render'):
      try:
        self.logger.debug('rendering %s', request.url)
        html, result, status = self.render(request.url)
        return HtmlResponse(url=request.url, body=html, request=request, encoding='utf-8',
                  status=status)
      except websockets.exceptions.ConnectionClosed:
        pass

  @classmethod
  def from_crawler(cls, crawler):
    return cls(**crawler.settings.get('PYPPETEER_ARGS', {}))
随后,修改项目的配置文件(路径为:./项目名/settings.py)。
DOWNLOADER_MIDDLEWARES = {
    'scrapypyppeteer.middlewares.PyppeteerMiddleware': 543,
    'scrapypyppeteer.middlewares.ProxyMiddleware': 100,
  }
接着,运行程序进行测试。

至此,关于Scrapy框架结合Puppeteer渲染的使用介绍完毕。如需了解更多Scrapy与Puppeteer渲染相关内容,请搜索本站历史文章或继续浏览后续相关文章,感谢大家的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









