

Python爬虫实战:从百度企业信用提取企业基本信息

本文介绍如何使用Python爬虫从百度企业信用网站获取企业基本信息。通过分析页面JavaScript动态生成的数据,利用正则表达式提取resultList字段并转换为JSON对象,从而获取企业名称、法人、注册资本等详细信息。文章提供完整源码及调用示例,适用于学习参考,请勿用于恶意爬取。
背景与目标
一、背景
为了通过企业名称查询其经纬度、所在省份及城市等地理位置信息,直接调用百度地图API往往因为名称模糊导致结果不准确。因此,获取包含完整地理位置的企业详细信息,能显著提升地图API查询的精准度。百度企业信用平台提供了企业基本信息查询服务,本文旨在通过Python爬虫技术实现这一数据的自动化获取,目前该方案已基本跑通。文末将附上具体代码,仅供学习研究,严禁用于恶意爬取行为。
数据源分析
二、分析
以“江苏苏宁”为例进行演示。在搜索框输入企业名称后,页面展示的查询结果如下:
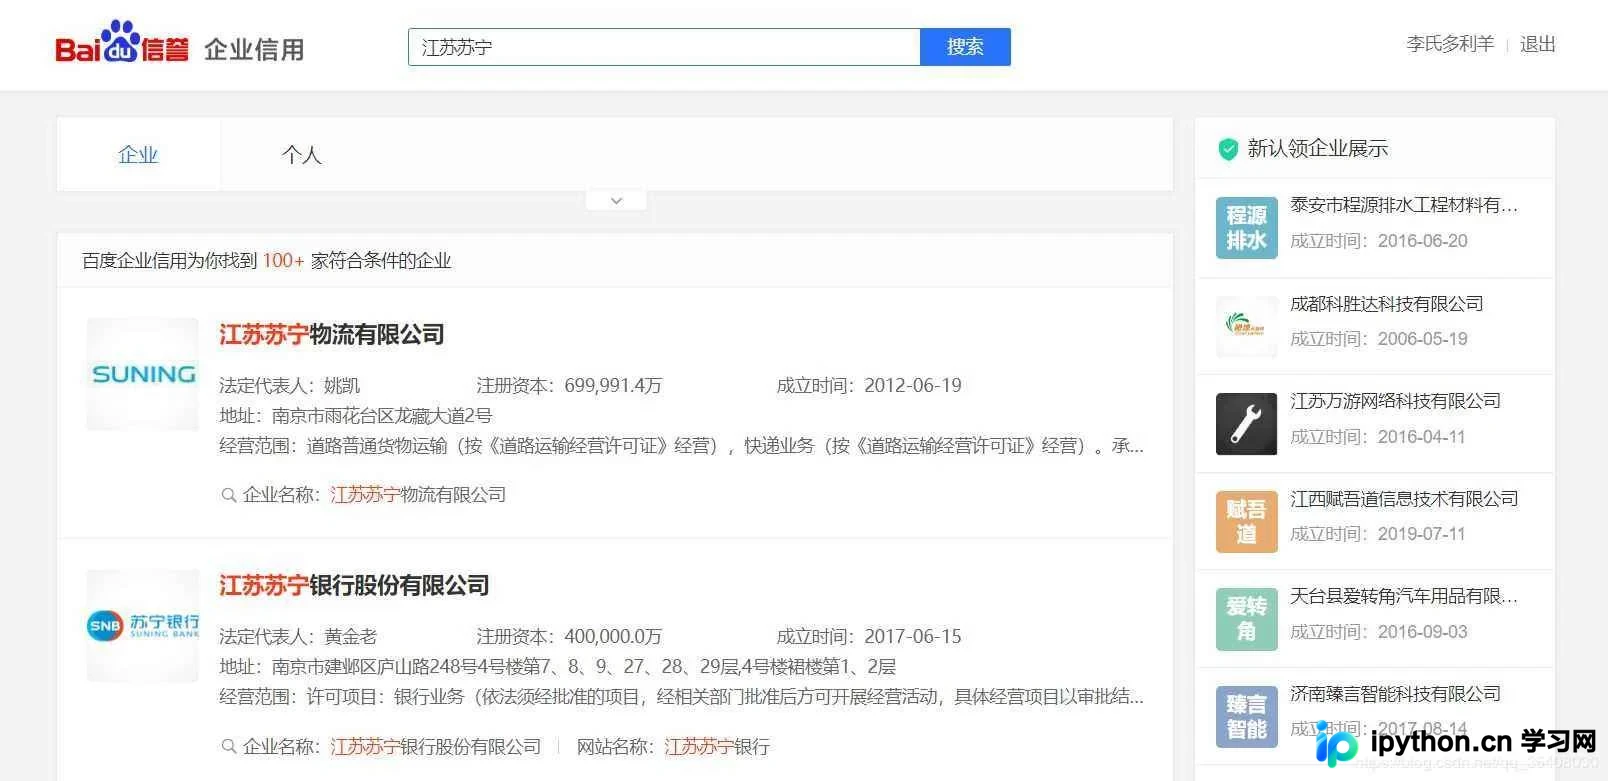
经过对页面结构的分析,发现列示的企业信息并非静态HTML,而是由JavaScript动态渲染生成。服务器最初返回的未渲染HTML源码如下:
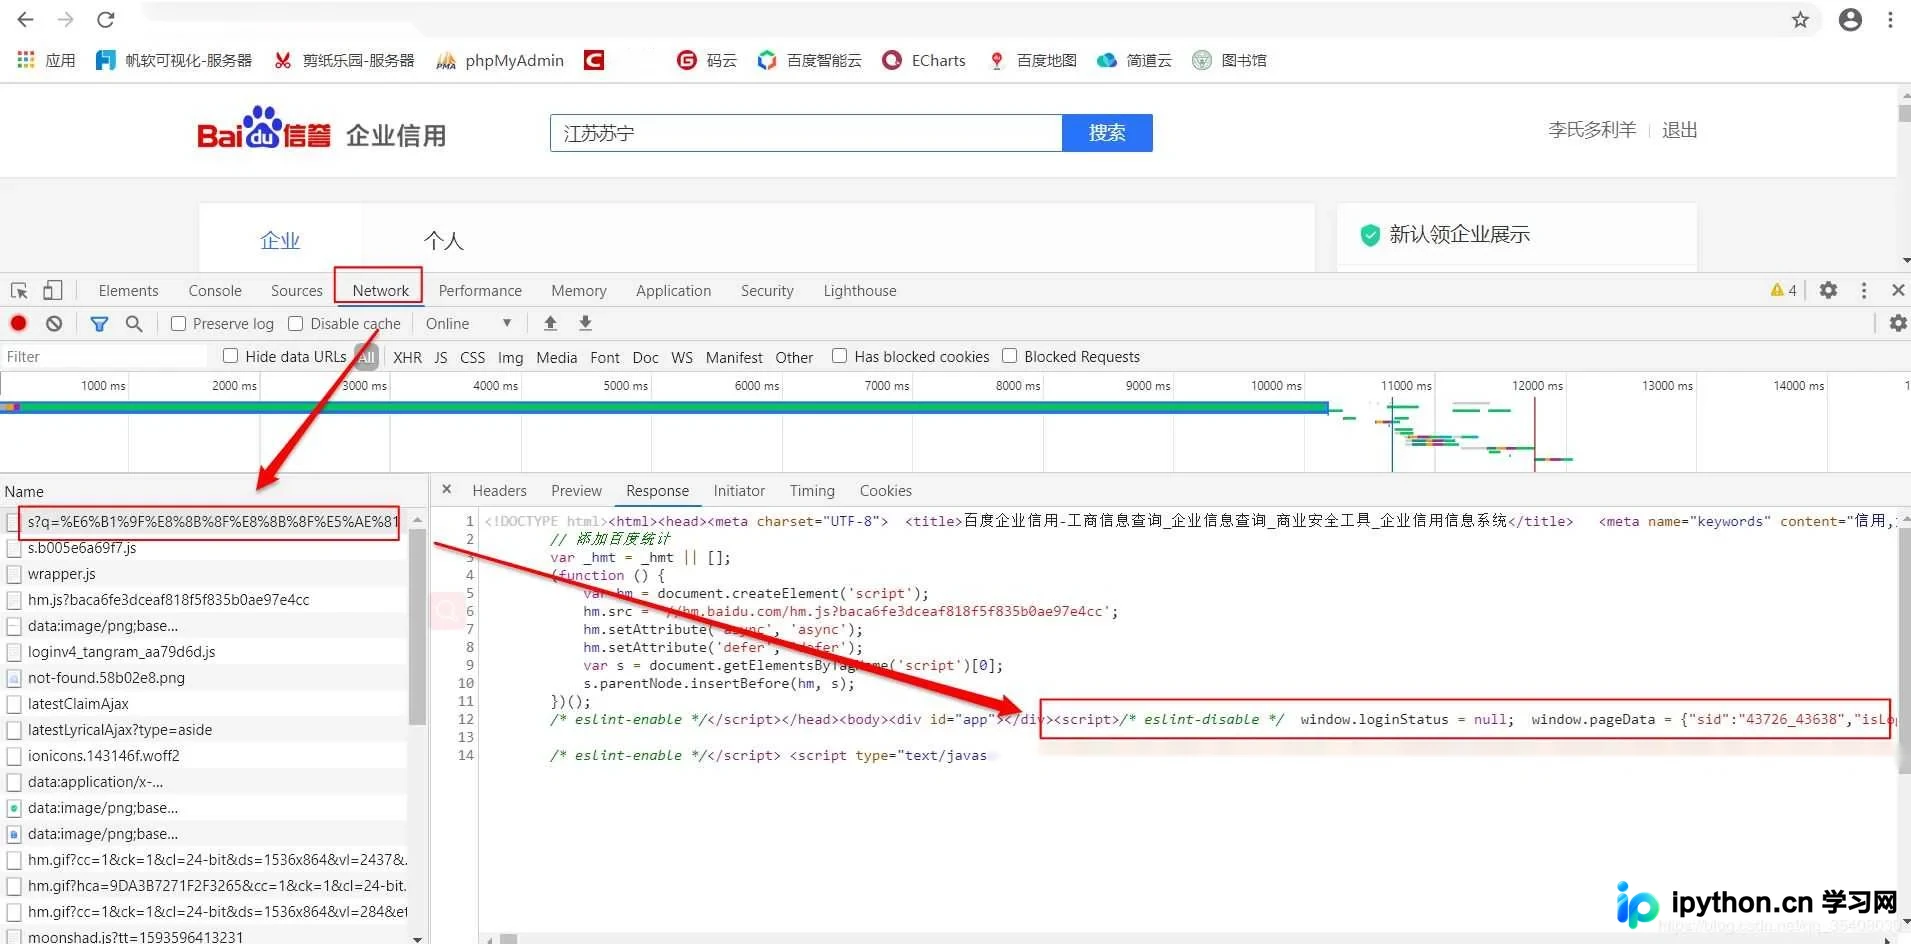
请留意代码中标注出的JavaScript部分。有趣的是,企业的基本信息可以直接从这段JS代码中提取,无需构造复杂的请求参数或模拟登录过程。
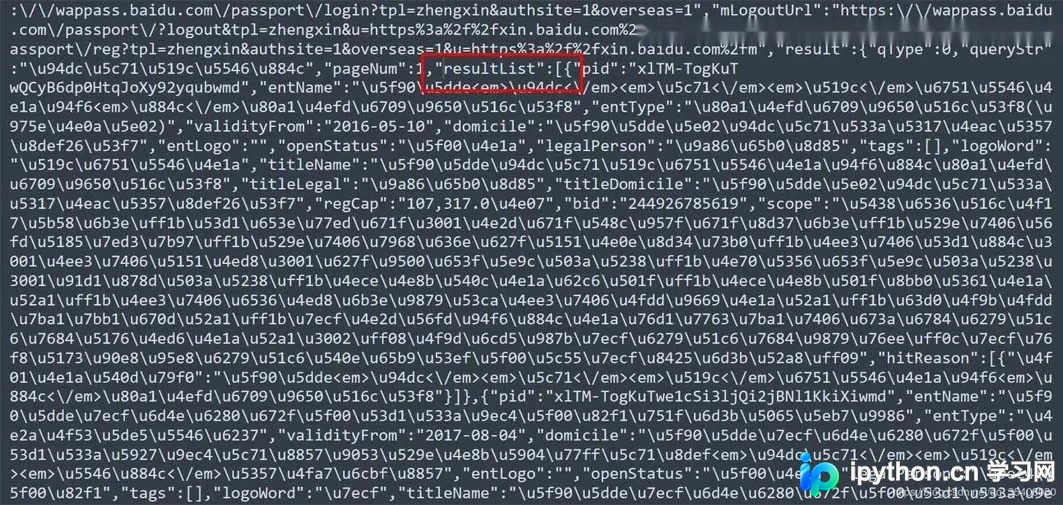
进一步查看JS内容可以发现“resultList”字段,其后续数据即为页面上展示的企业信息列表。显然,只需利用正则表达式提取相关字符串,并将其转换为JSON格式即可获取所需数据。
核心源码实现
三、源码
以下代码封装了一个API接口,用于查询指定企业的基本信息:
#!/usr/bin/env python
# -*- coding:utf-8 -*-
# @Author: Wild Orange
# @Email: jixuanfan_seu@163.com
# @Date:  2020-06-19 22:38:14
# @Last Modified time: 2020-07-01 17:33:13

import requests
import re
import json

headers={'User-Agent': 'Chrome/76.0.3809.132'}

#正则表达式提取数据
re_get_js=re.compile(r'<script>([\s\S]*?)</script>')
re_resultList=re.compile(r'"resultList":(\[{.+?}\]}])')

def Get_company_info(name):
	'''
		@func: 通过百度企业信用查询企业基本信息
	'''
	url='https://xin.baidu.com/s?q=%s'%name
	res=requests.get(url,headers=headers)
	if res.status_code==200:
		html=res.text
		retVal=_parse_baidu_company_info(html)
		return retVal
	else:
		print('无法获取%s的企业信息'%name)

def _parse_baidu_company_info(html):
	'''
		@function:解析百度企业信用提供的企业基本信息
		@output: list of dict, [{},{},...]
			pid: 跳转到具体企业页面的参数
			bid: 具体企业页面URL中的参数
			name: 企业名称
			type: 企业类型
			date: 成立日期
			address: 地址
			person: 法人代表
			status: 存续状态
			regCap: 注册资本
			scope: 经营范围
	'''
	js=re_get_js.findall(html)[1]
	data=re_resultList.search(js)
	if not data:
		return
	compant_list=json.loads(data.group(1))

	retVal=[]
	for x in compant_list:
		regCap=x['regCap'].replace(',','')
		if regCap[-1]=='万':
			regCap=regCap[:-1]
		regCap=float(regCap)
		address=x['domicile'].replace('<em>','').replace('</em>','')

		temp_v={'pid':x['pid'],'bid':x['bid'],'name':x['titleName'],'type':x['entType'],'date':x['validityFrom'],\
				'address':address,'person':x['legalPerson'],'status':x['openStatus'],'regCap':regCap,\
				'scope':x['scope']}
		retVal.append(temp_v)
	return retVal
代码使用与注意事项
四、使用方法
只需将待查询的企业名称作为参数传入Get_company_info函数即可:
res=Get_company_info('江苏苏宁')
	print(res)
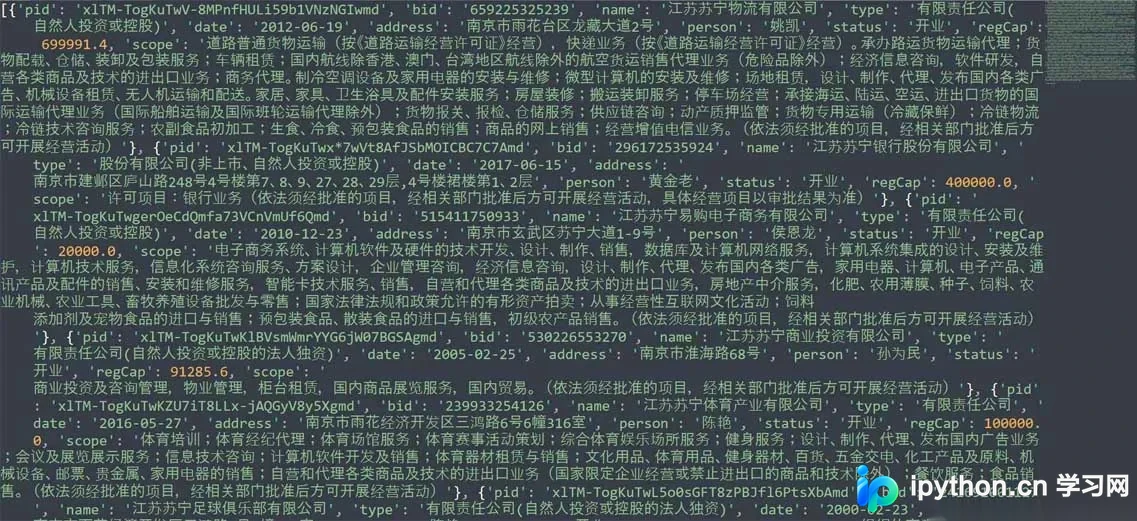
运行结果如下:
使用注意事项:
函数返回的是一个由字典组成的列表,每个字典代表一家企业的详细信息。列表顺序与浏览器页面显示的顺序一致。字典中各字段的含义已在_parse_baidu_company_info函数的注释中详细说明。当前程序仅抓取第一页数据,如需查询多页,需修改源码逻辑。此外,该程序仅获取企业的基本概况,并未深入跳转至具体企业的详细页面(例如苏宁物流的独立页面)。不过,返回结果中的pid或bid参数可用于构造访问具体企业详情页的URL。
最后再次强调:提供的代码仅供学习与参考,请遵守相关法规,切勿进行恶意爬取。
至此,关于使用Python爬虫获取百度企业信用中企业基本信息的详细介绍完毕。如需了解更多Python爬虫及百度企业信用相关技巧,请搜索本站历史文章或继续浏览后续内容。感谢大家的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









