

Python爬虫突破反爬:通过设置Cookie爬取蚂蚁短租数据详解
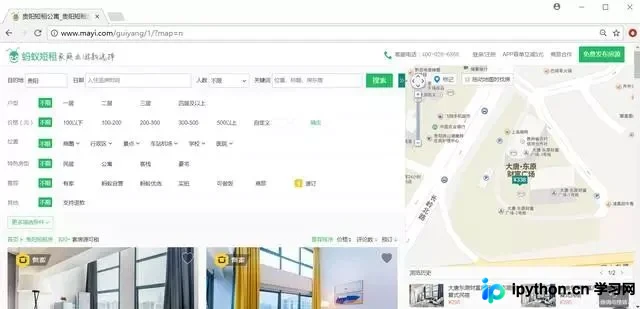
本文详细介绍如何使用Python爬虫应对网站反爬机制。针对蚂蚁短租的访问拦截,通过浏览器开发者工具获取Cookie和User-Agent,并在Python代码中通过urllib2设置Headers提交请求。结合BeautifulSoup解析HTML节点,成功获取贵阳地区短租房的名称、价格、评分及链接等详细信息,并存储为CSV文件。
2026-10-15
5

本文详细介绍如何使用Python爬虫应对网站反爬机制。针对蚂蚁短租的访问拦截,通过浏览器开发者工具获取Cookie和User-Agent,并在Python代码中通过urllib2设置Headers提交请求。结合BeautifulSoup解析HTML节点,成功获取贵阳地区短租房的名称、价格、评分及链接等详细信息,并存储为CSV文件。
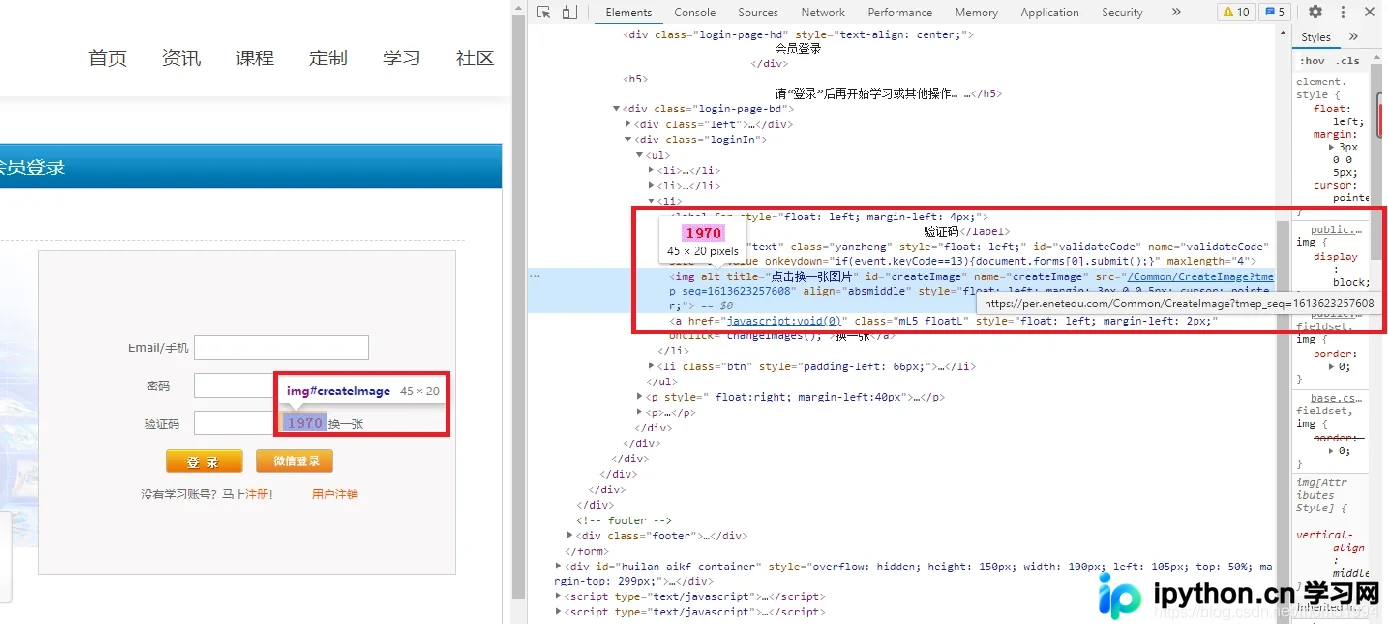
本文详细讲解如何使用Python爬取经过分片处理的TS视频文件,并解决验证码登录难题。通过手动或自动识别验证码完成Session保持,解析M3U8索引文件获取视频片段列表,批量下载后拼接并转换为MP4格式,完整展示从登录到视频保存的技术细节。
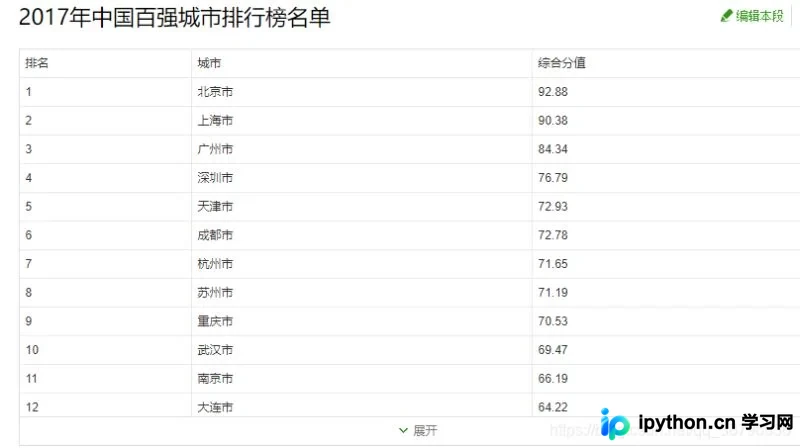
本文详解Python使用requests库爬取网页时返回空内容的常见原因及解决方法。通过修改User-Agent和Cookie模拟浏览器请求,成功绕过360搜索的反爬限制,并结合BeautifulSoup库提取表格数据,完整展示从请求到数据提取的全过程。
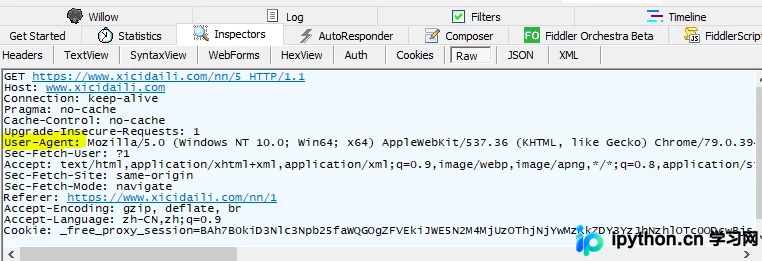
本文详细解析Python爬虫中因缺少User-Agent标识导致请求被拒的问题,并提供使用requests库进行UA伪装的完整代码示例。通过模拟Chrome浏览器头部信息,有效绕过门户网站的简单反爬检测,实现正常数据抓取。
新版Selenium已不再支持PhantomJS,本文详细介绍如何在Python爬虫项目中安装并配置ChromeDriver以支持动态网页抓取。内容涵盖安装必要性、官方资源链接,以及针对Mac系统的Homebrew安装方法(含备用方案)和Windows环境下的版本验证步骤,帮助开发者顺利实现Headless Chrome自动化测试与数据采集。
本文介绍在Python爬虫开发中,如何获取HTTP重定向后的最终URL。通过urllib库的urlopen方法和requests库的get方法,分别展示了两种获取重定向地址的代码实现。重点解析了如何从响应对象中提取最终跳转后的网址,并提供了包含User-Agent请求头设置的示例,帮助开发者解决爬虫追踪真实链接的问题。
本文详细讲解使用Python爬取微博评论的完整流程。内容涵盖微博爬虫的难度分级、接口URL构造、HTML标签去除及正则表达式应用,并提供了基于requests和pandas的两种代码实例,帮助开发者掌握从确定用户ID到保存CSV文件的实际操作步骤。
本文介绍使用Python爬取免费代理IP网站数据并生成JSON文件的方法。通过lxml模块提取IP和端口,利用requests库向百度发起请求以验证代理可用性,并将有效IP及耗时写入文件。代码包含分页抓取、延时处理及异常捕获,旨在为小型爬虫项目提供低成本的动态IP解决方案。
本文详解Python Selenium中关闭浏览器的两种方法:close()用于关闭当前窗口,quit()用于关闭所有窗口并释放驱动。通过代码示例展示如何在多窗口场景下遍历句柄并逐一关闭,帮助开发者正确管理浏览器资源。
本文详解Python Selenium中处理JavaScript三种弹窗(Alert、Confirm、Prompt)的方法。通过switch_to.alert定位弹窗,利用text获取内容,accept()确认,dismiss()取消,以及send_keys()输入文本。结合百度设置实例,展示完整操作流程与代码实现。
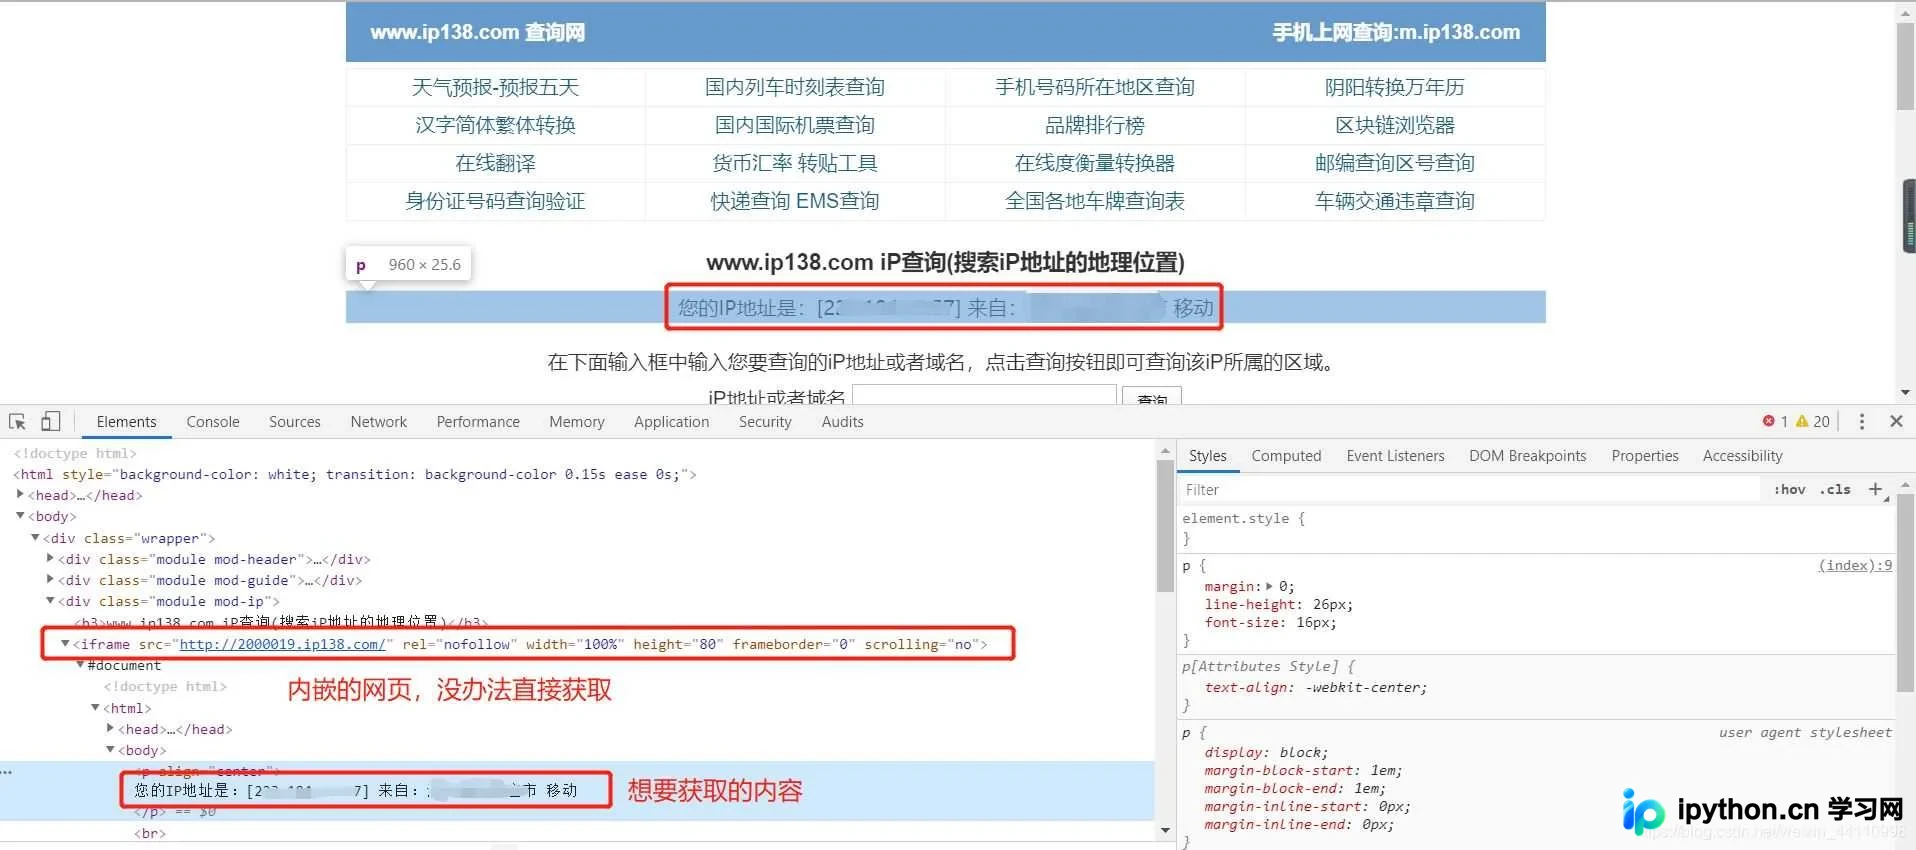
本文介绍在Python Selenium爬虫开发中,如何处理Web页面常见的frame/iframe表单嵌套问题。通过switch_to.frame()方法切换至内嵌页面进行元素定位,并使用switch_to.parent_frame()或default_content()退出嵌套,结合ip138实例代码演示完整操作流程。
本文详细介绍Selenium中ChromeOptions对象的启动参数配置方法。涵盖无界面模式(--headless)、User-Agent设置、窗口尺寸调整及无痕模式等常用选项。同时深入解析如何通过prefs属性禁用图片加载与浏览器通知弹窗,并提供完整的Python代码示例,帮助开发者优化爬虫稳定性与性能。