

Python爬虫实战:抓取QQ音乐歌词并导出Excel

本文详细介绍如何利用Python爬虫技术批量获取QQ音乐歌词。通过浏览器开发者工具分析网络请求,定位搜索接口与歌词接口的URL及参数,编写代码提取歌曲信息与歌词文本,最终使用openpyxl库将结果保存为Excel文件,实现本地化存储与整理。
Python爬虫实战:抓取QQ音乐歌词并导出Excel
前言
本文的文字及图片来源于网络,仅供学习、交流使用,不具有任何商业用途,版权归原作者所有,如有问题请及时联系我们以作处理。
闲暇时听歌放松,听久了或许会想聊聊音乐。你是否拥有特别钟爱的曲目?是否曾想过将这些歌曲的歌词完整下载并保存下来?
笔者正是这样做的,今天以QQ音乐为例,演示如何通过Python爬虫技术,将心仪歌曲的歌词批量抓取至本地计算机。
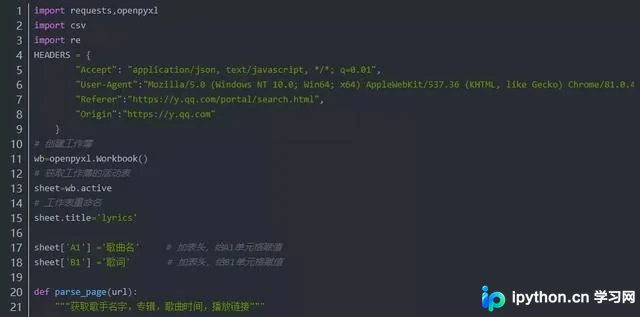
接下来将详细拆解操作步骤,文末附有完整可运行代码供参考。
定位客户端搜索接口
01
定位客户端搜索接口(client_search)
首先访问QQ音乐官网:https://y.qq.com/。
在搜索框中输入目标歌手名称,随后右键点击页面空白处,选择“检查”或“审查元素”以打开开发者工具。
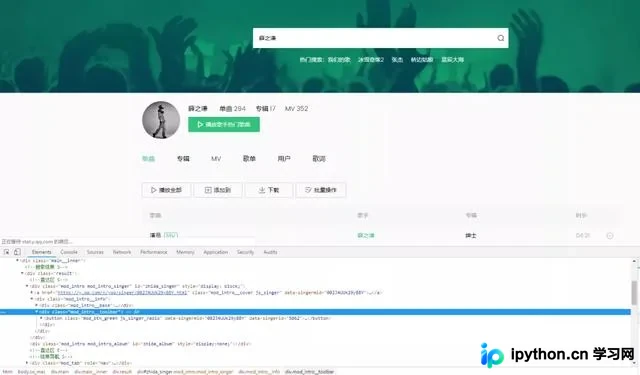
在开发者工具中切换到“Network”(网络)标签页,并刷新页面或点击蓝色底纹的页面区域以捕获网络请求。
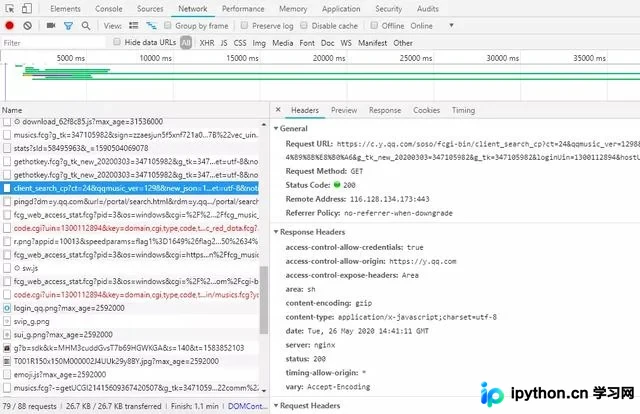
解析目标URL结构
02
解析目标URL结构

面对繁杂的请求列表无需焦虑,核心接口地址为:https://c.y.qq.com/soso/fcgi-bin/client_search_cp。后续跟随的均为该接口所需的请求参数(此处表述可能不够严谨,但核心逻辑如此)。
构造请求参数与数据提取
03
构造请求参数
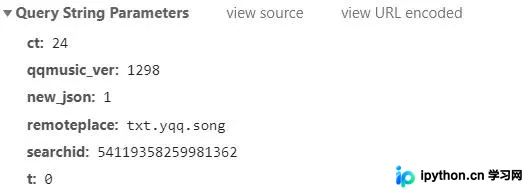
将Network标签页中捕获到的所有关键参数复制出来,参考如下格式。
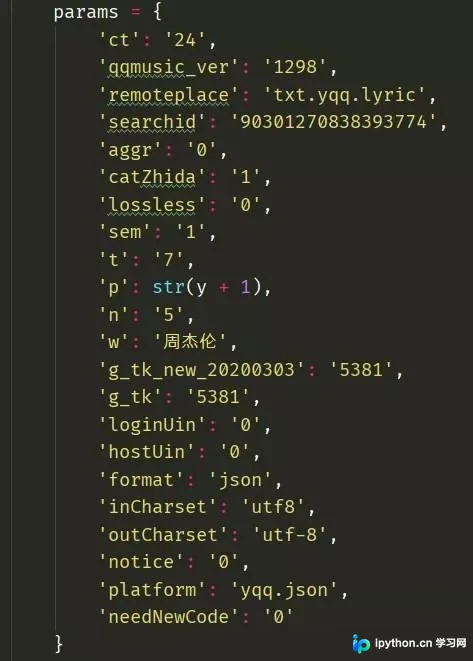
分析可知,“p”参数代表页码(代码中通过循环实现翻页),而“w”参数对应歌手名称(可根据需求动态修改)。
通过上述参数,我们可以获取歌手名、歌曲专辑、音频时长及播放链接等基本信息(相关逻辑封装在parse_page函数中)。
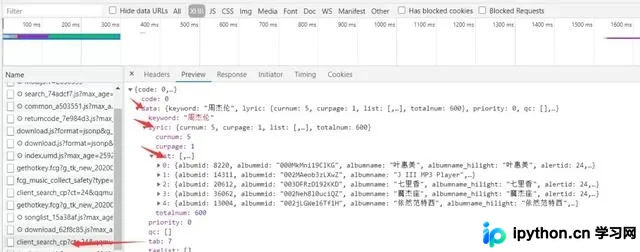
接下来是最具挑战性的歌词获取环节,这往往令人头疼。
歌词接口分析与Excel导出实现
04
1、定位歌词接口:点击“歌词”标签,观察Network面板。

可以看到每页仅展示5首歌曲的歌词信息,我们据此进行爬取(具体逻辑见lyric_a代码部分)。
2、调整params参数:同样在请求底部找到对应参数,修改方式与前述搜索接口类似。
3、利用openpyxl库将数据写入Excel表格。
(1)导入openpyxl模块。
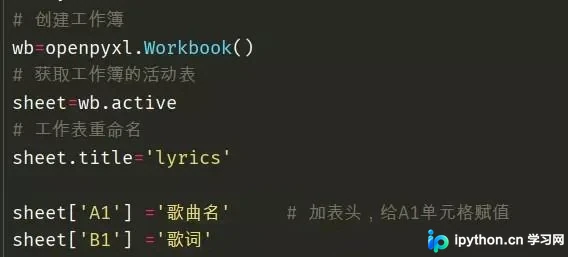
(2)创建新的工作簿。
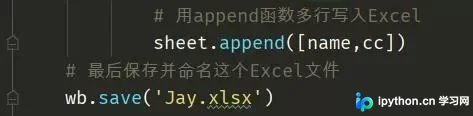
(3)将抓取的数据填入表格并保存命名。
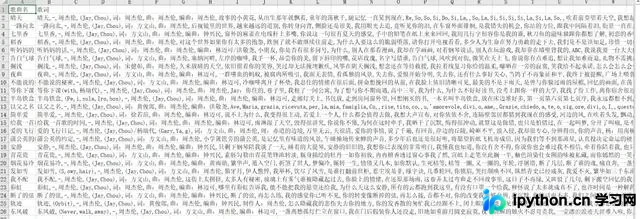
此处为示例效果图。
之所以未选择CSV格式,是因为初学者技术有限,CSV导出时容易出现逗号分隔符解析混乱的问题(即“真·逗号分隔符”困扰)。
以上就是本文的全部内容,希望对各位的学习有所帮助,也欢迎大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









